刘芷溢
最近更新
FlashAttention v1-v4:从 IO 感知到异步流水与硬件协同
沿着 FlashAttention v1-v4 的论文、作者博客与源码,拆解 Ampere、Hopper、Blackwell 如何改变 attention 的数据路径、线程分工和瓶颈,并用调度图解释 copy、MMA、softmax 与输出校正如何真正重叠。
理解 H100:从硬件数据路径到 Nsight Compute 瓶颈分析
沿着 kernel 的分配、指令发射、访存与异步矩阵计算,建立 H100 的硬件工作模型,并把 Nsight Compute 的吞吐、调度、事务和依赖指标组织成可验证的瓶颈诊断方法。
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization 论文笔记
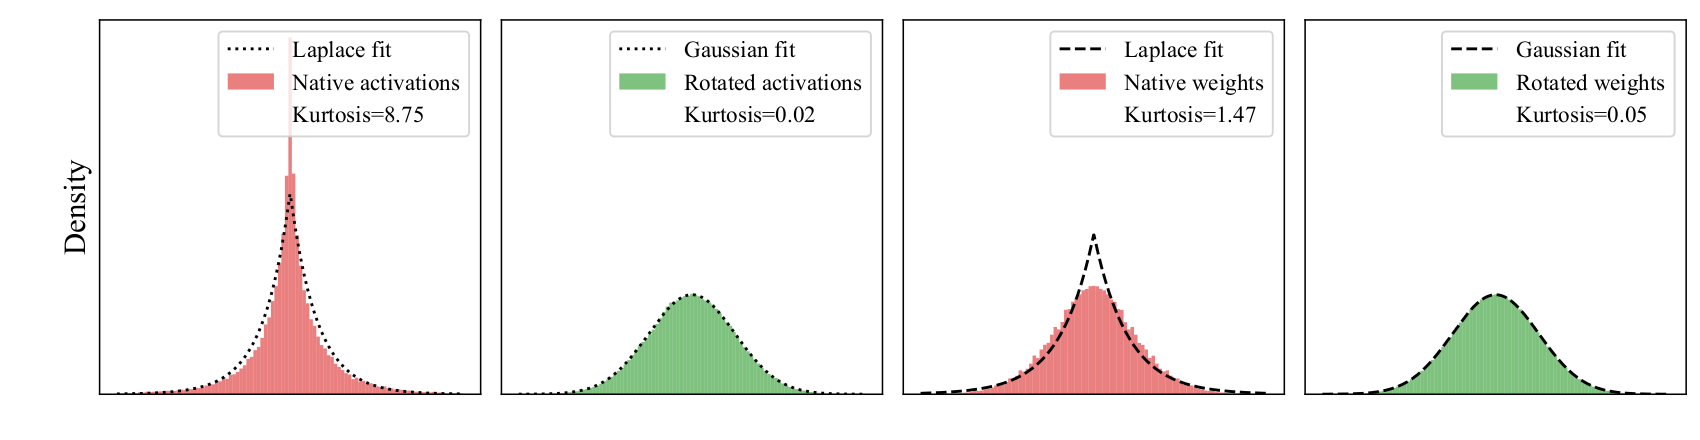
以格式、量化算法和 GPU Kernel 的跨层约束为主线,拆解 ICLR 2026 论文 Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization,解释旋转为何改善 MXFP4 却可能伤害 NVFP4、MR-GPTQ 如何修正这一矛盾,以及 QuTLASS 的真实收益与部署边界。
FP4、FP8 与 INT8/INT4:数值范围、块缩放与推理计算精度
从标量编码、共享 scale 与有效位宽出发,拆解 INT8、FP8、MXFP8、INT4、MXFP4、NVFP4 的表示范围,并沿 GEMM、GQA/MLA Attention 数据流解释 8 bit/4 bit 推理真正使用的乘法、累加、Softmax 与输出精度。
从 EAGLE 到 DFlash 2:SGLang 与 SpecForge 的投机解码训练和推理
沿 EAGLE、EAGLE-2、EAGLE-3、DFlash、DSpark 和 DFlash 2 的演进,解释 draft 的训练目标、数据对齐、推理状态与验证预算,并对照 SpecForge 训练和 SGLang serving 源码串起完整流程。
README
CuTe FlashAttention-2 case-study benchmark This directory preserves the exact teaching kernel, benchmark harness, raw results, and figure generator used by the corresponding tom-jerr blog post.
CuTe 详解:以 FlashAttention-2 拆解 Layout、TiledCopy 与 TiledMMA
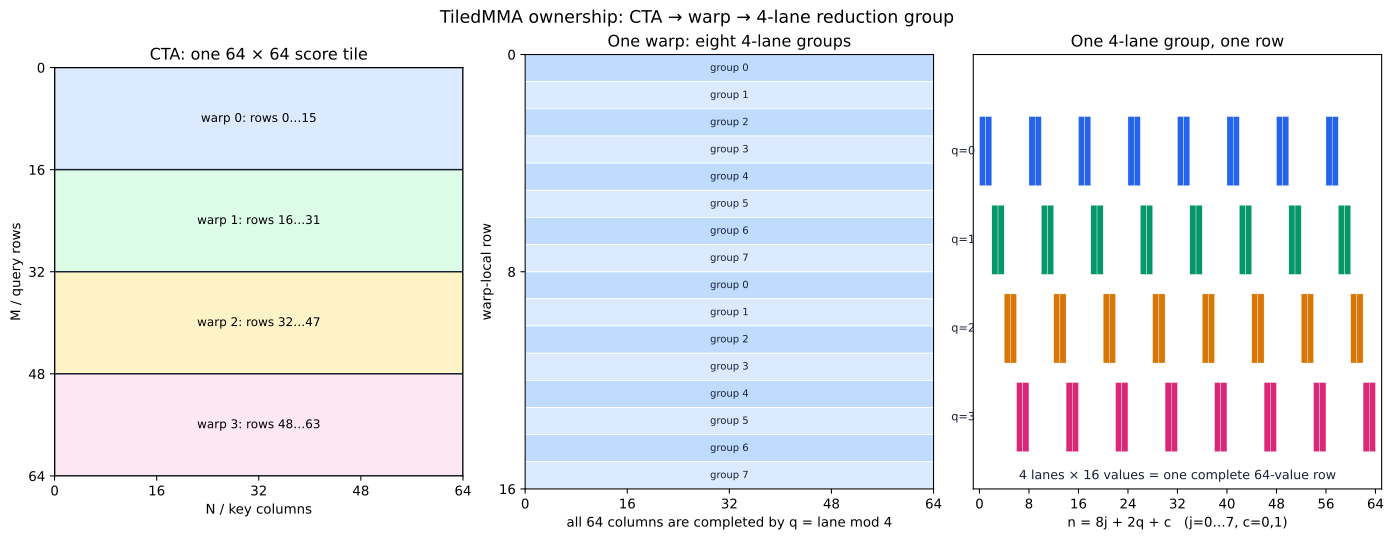
以一份可运行的 FlashAttention-2 前向 Kernel 为贯穿案例,从坐标函数和线程所有权出发,详解 CuTe 的 Layout algebra、Tensor、TiledCopy、TiledMMA、寄存器重解释与流水线,并用正确性和性能实验检查这些抽象最终生成了什么。
LLM 量化综述:数据格式、PTQ 与 QAT 的算法演进
从 INT8、FP8、INT4、MXFP4、NVFP4 的表示范围与舍入误差出发,按 8 bit、4 bit 和低于 4 bit 梳理 PTQ/QAT,解释各方法解决的问题、相对前作的创新、核心优化与数值稳定性,并对应到 llm-compressor 的工程实现。

CMU15445
18 篇文章
Bustub 通关指北
Bustub 通关指北,带你快速了解 Bustub 的核心组件和实现细节,包括 Parser、Planner、Optimizer、Executor 以及 Storage 模块的工作原理。
10-Join Algorithm
10-Join Algorithm 10.1 join algorithms 尽可能选择较小的表作为外围表 10.2 Join opetators Output data Cost Analysis Criteria Nested Loop Join Nested Loop Join 已知表非常小的情况下,可以使用 nested loop join,可以适配 L3 缓存 Index Nested Loop Join Block Nested loop join Nested Loop Join Summary Key Takeaways 选择更小的表作为 Outer table 尽可能在 bu...
12 Query Planning and Optimization
Query Planning and Optimization catalog 是一个记录元数据信息的文件 The Physical Plan Query Optimization(QO) Heuristics/Rules 重写查询来去除那些无效的条件 这些技巧需要访问 catalog,但是它们不需要访问数据 Predicate Pushdown Replace Cartesian Product Projection Pushdown Equivalence Architecture Overview Cost-based Search 使用一个模型来预测执行一个计划的成本 遍历多种计划,选...
13 Concurrency Control Theory
Concurrency Control Theory Transaction in sql ACID Mechanisms for ensuring atomicity Logging LSM tree 是针对单个表文件配置的;而 logging 是针对全局跨文件设置的 Shadow Paging 即使改变几字节,也会复制整个页 Consistency 很多系统采用最终一致性,但在过程中可能出现不一致的情况 Mechanisms for ensuring isolation Formal Properties of schedules Unreaptable Read 读写冲突的情况下,同一事...
14 Two Phase Lock
Two Phase Lock Concurrency Control Executing with locks 事务需要锁(upgrade) 锁管理器为请求申请锁 事务释放锁 锁管理器更新内部的 lock table lock table 跟踪每个事务持有什么锁,并正在等待什么锁 Locks vs.
15 Timestamp Ordering Concurrency Control
Timestamp Ordering Concurrency Control 2PL 和时间戳排序算法是悲观并发控制算法 还有乐观并发控制算法 T/O Concurrency Control 使用时间戳来确保事务执行的顺序 如果 TS(T_I) < TS(T_j),DBMS 需要确保执行的调度必须和T_i发生在T_j前的串行化调度相同 Timestamp allocation System/Wall Clock Logical Counter Hybrid Basic T/O 事务读取和写入对象不需要锁 W-TS(X):是最后成功写入的事务的时间戳 R-TS(X):是最后成功读取的事务的...
16 Multi-Version Concurrency
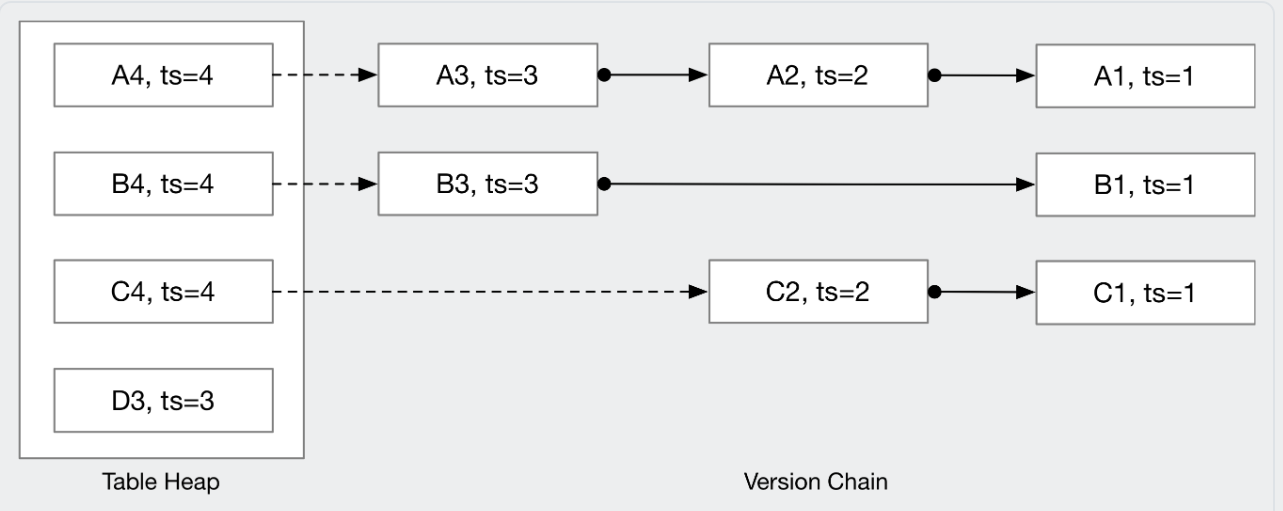
Mutli-Version Concurrency DBMS 有多个物理版本和一个逻辑版本 一个事务写入时会创建一个新版本;读取时会读取该事务开始时最新的版本 MVCC 实际上是维护多个版本的机制;而版本之间的并发正确性仍然需要并发控制协议来维护 writers do not block readers and readers do not block writers 只读事务可以不获取锁读取一个一致性的快照 MVCC example Write Skew Anomaly 快照隔离并不能确保可串行性;可能出现这种写偏斜问题 Version Storage Append-Only Storage...
17 Database Logging
Database Logging Crash Recovery Actions during normal txn processing to ensure that the DBMS can recover from a failure Actions after a failure to recovver the database to a state that ensures atomicity, consistency, and durability Failure Classification Transaction Failures Logical Errors: 事务因为一些内部...
18 Database Recovery
Database Recovery ARIES Log Sequence Numbers MasterRecord 被硬编码到 DBMS,所以我们恢复时这个页面会先被拉到内存中 仅仅当 pageLSN <= flushLSN,才能将 log 刷入磁盘 所有的记录都有一个 LSN 每次一个事务修改一个页上的 record,pageLSN 会改变 每次 DBMS 将 WAL buffer 中的东西写入磁盘,flushedLSN 会更新 Normal Execution Transaction Commit 我们只需要保证在刷新 flushLSN 之前先将日志记录刷新到磁盘即可 TXN-END...
19 Introduction to distributed database
Introduction to distributed database.
7_B+Tree Indexes
7-B+Tree Indexes 7.1 B-Tree Family 7.1 Tree Indexes DBMS 在执行查询的时候,更多是查询索引而不是查询数据库中的表 索引问题 存储开销 维护索引开销 7.2 B+ Tree 是一个自平衡树。这是一种插入、删除均为 O(log n)的数据结构。可以支持线性遍历(哈希表不能做到) 相比 Hash Table,最好的性能是 O(1),最差时退化到 O(n)。因为平衡,所以任意一个叶子结点到根结点的时间复杂度均为 O(log n) 对于读写磁盘上整页数据具有其他数据结构不具备的优势 7.2.1 B+ Tree Properties M阶搜索树 \\...
8_Index Concurrency
8-Index Concurrency 8.0 Concurrency control 8.1 Latch 8.1.0 LOCKS VS.
9-Sort && Aggregation Algorithm
9-Sort && Aggregation Algorithm 9.0 Query Plan 操作符可以处理比内存更多的数据 尽可能高效地利用 buffer pool 访问磁盘用尽可能多的顺序 IO 9.1 Sort 9.1.1 Why do we need to sort 通常情况下,基于哈希的方式比基于排序的方式更优;但是对于预先排序的数据基于排序的方式可能更优 9.1.2 IN-MEMORY SORTING 9.1.3 TOP-N HEAP SORT 如果出现相等的值,就扩展堆数组的大小 9.1.4 EXTERNAL MERGE SORT sorted run 行存储一般...
6_Hash_Table
6 Hash Table 使用范围 Internal Meta-data Core Data Storage Temporary Data Structures (join 联表查询) Table Indexes 6.1 Design Decisions Data Organization Concurrency unrealistic assumptions Hash Function 计算速度和碰撞率的取舍 Hashing Scheme 静态哈希表 可扩展哈希表 6.2 hash functions 6.3 static Hashing Schemes Linear probe hashi...
5_Database_Storage
5 Buffer Pool 在磁盘中将文件切成一个个页 在内存中开辟一个缓存池;加快对页的访问 5.1 Buffer Pool Organization 是一个有着固定页数的数组;每个数组元素叫 frame (帧) 通过 page table 去索引内存池中的页 page table 可以 pin 某个页,也可以锁住某个索引 Mete-Data 页表跟踪现在在内存中的页 Dirty flag Pin/Reference Counter locks vs latches locks 保护事务中的内容 在事务期间持有锁 需要回滚 latches 保护临界区数据结构 在操作期间持有锁 不必回滚改变 ...
4_Database_Storage II
4 Database Storage II 数据库负责将非易失性存储中的数据和内存进行交互 4.1 problem with slotted page design Fragmentation (碎片) Useless Disk I/O Random Disk I/O (update 20 tuples on 20 pages) 4.2 Log-structed storage 更多使用 KV 数据库上,只有一个键一个值 不存数据,存放数据的操作(insert, delete, update) 直接在后面加上新操作,不检查前面的所有操作是否正确 读取一个记录,从后向前进行扫描记录;找到需要的数...
3_Database_Storage I
3-Database Storage I 1 DISK-BASED ARCHITECTURE 易失性存储和非易失性存储相结合 Volatile:Random Access Byte-Addressable (DRAM 之上) Non-Volatile:Sequential Access Block-Addressable(SSD 之下 ) SSD 以下只能按块来存取 顺序访问和随机访问 非易失性存储中顺序访问比随机访问快得多 一般数据存储在连续的块中,同时分配多个物理页叫区 2 DBMS 设计目标 允许管理比可用内存大的数据库 读写磁盘代价高昂,尽可能避免大的停顿和性能下降 DBMS 希望最大...