刘芷溢
最近更新
FlashAttention v1-v4:从 IO 感知到异步流水与硬件协同
沿着 FlashAttention v1-v4 的论文、作者博客与源码,拆解 Ampere、Hopper、Blackwell 如何改变 attention 的数据路径、线程分工和瓶颈,并用调度图解释 copy、MMA、softmax 与输出校正如何真正重叠。
理解 H100:从硬件数据路径到 Nsight Compute 瓶颈分析
沿着 kernel 的分配、指令发射、访存与异步矩阵计算,建立 H100 的硬件工作模型,并把 Nsight Compute 的吞吐、调度、事务和依赖指标组织成可验证的瓶颈诊断方法。
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization 论文笔记
以格式、量化算法和 GPU Kernel 的跨层约束为主线,拆解 ICLR 2026 论文 Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization,解释旋转为何改善 MXFP4 却可能伤害 NVFP4、MR-GPTQ 如何修正这一矛盾,以及 QuTLASS 的真实收益与部署边界。
FP4、FP8 与 INT8/INT4:数值范围、块缩放与推理计算精度
从标量编码、共享 scale 与有效位宽出发,拆解 INT8、FP8、MXFP8、INT4、MXFP4、NVFP4 的表示范围,并沿 GEMM、GQA/MLA Attention 数据流解释 8 bit/4 bit 推理真正使用的乘法、累加、Softmax 与输出精度。
从 EAGLE 到 DFlash 2:SGLang 与 SpecForge 的投机解码训练和推理
沿 EAGLE、EAGLE-2、EAGLE-3、DFlash、DSpark 和 DFlash 2 的演进,解释 draft 的训练目标、数据对齐、推理状态与验证预算,并对照 SpecForge 训练和 SGLang serving 源码串起完整流程。
README
CuTe FlashAttention-2 case-study benchmark This directory preserves the exact teaching kernel, benchmark harness, raw results, and figure generator used by the corresponding tom-jerr blog post.
CuTe 详解:以 FlashAttention-2 拆解 Layout、TiledCopy 与 TiledMMA
以一份可运行的 FlashAttention-2 前向 Kernel 为贯穿案例,从坐标函数和线程所有权出发,详解 CuTe 的 Layout algebra、Tensor、TiledCopy、TiledMMA、寄存器重解释与流水线,并用正确性和性能实验检查这些抽象最终生成了什么。
LLM 量化综述:数据格式、PTQ 与 QAT 的算法演进
从 INT8、FP8、INT4、MXFP4、NVFP4 的表示范围与舍入误差出发,按 8 bit、4 bit 和低于 4 bit 梳理 PTQ/QAT,解释各方法解决的问题、相对前作的创新、核心优化与数值稳定性,并对应到 llm-compressor 的工程实现。

llminference
58 篇文章
FlashAttention v1-v4:从 IO 感知到异步流水与硬件协同
沿着 FlashAttention v1-v4 的论文、作者博客与源码,拆解 Ampere、Hopper、Blackwell 如何改变 attention 的数据路径、线程分工和瓶颈,并用调度图解释 copy、MMA、softmax 与输出校正如何真正重叠。
理解 H100:从硬件数据路径到 Nsight Compute 瓶颈分析
沿着 kernel 的分配、指令发射、访存与异步矩阵计算,建立 H100 的硬件工作模型,并把 Nsight Compute 的吞吐、调度、事务和依赖指标组织成可验证的瓶颈诊断方法。
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization 论文笔记
以格式、量化算法和 GPU Kernel 的跨层约束为主线,拆解 ICLR 2026 论文 Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization,解释旋转为何改善 MXFP4 却可能伤害 NVFP4、MR-GPTQ 如何修正这一矛盾,以及 QuTLASS 的真实收益与部署边界。
FP4、FP8 与 INT8/INT4:数值范围、块缩放与推理计算精度
从标量编码、共享 scale 与有效位宽出发,拆解 INT8、FP8、MXFP8、INT4、MXFP4、NVFP4 的表示范围,并沿 GEMM、GQA/MLA Attention 数据流解释 8 bit/4 bit 推理真正使用的乘法、累加、Softmax 与输出精度。
从 EAGLE 到 DFlash 2:SGLang 与 SpecForge 的投机解码训练和推理
沿 EAGLE、EAGLE-2、EAGLE-3、DFlash、DSpark 和 DFlash 2 的演进,解释 draft 的训练目标、数据对齐、推理状态与验证预算,并对照 SpecForge 训练和 SGLang serving 源码串起完整流程。
CuTe 详解:以 FlashAttention-2 拆解 Layout、TiledCopy 与 TiledMMA
以一份可运行的 FlashAttention-2 前向 Kernel 为贯穿案例,从坐标函数和线程所有权出发,详解 CuTe 的 Layout algebra、Tensor、TiledCopy、TiledMMA、寄存器重解释与流水线,并用正确性和性能实验检查这些抽象最终生成了什么。
LLM 量化综述:数据格式、PTQ 与 QAT 的算法演进
从 INT8、FP8、INT4、MXFP4、NVFP4 的表示范围与舍入误差出发,按 8 bit、4 bit 和低于 4 bit 梳理 PTQ/QAT,解释各方法解决的问题、相对前作的创新、核心优化与数值稳定性,并对应到 llm-compressor 的工程实现。
SGLang HiCache:组件、工作流与 L1/L2/L3 读写时序
从 HiRadixCache、HiCacheController、Host KV Pool 与 Storage Backend 的职责出发,沿 Scheduler 主循环拆解 L3 query、hit、prefetch、L2 load、L2 write 和 L3 write 的准确时序。
quantization cuda
Quantization CUDA 动态量化流程 (Dynamic Quantization Flow): 权重和激活都从浮点开始 权重在预处理阶段量化 激活在运行时量化 使用Int8进行乘法运算 使用Int32进行累加 最后rescale回浮点数 未量化 (Not Quantized): 权重和激活都保持浮点格式 所有运算(乘法和累加)都使用浮点数进行 仅权重量化 (Weight Only Quantization): 权重在预处理阶段量化 随后立即反量化回浮点数 激活保持浮点格式 乘法和累加都使用浮点数进行 最后有一个rescale步骤 Dynamic Quantization 数学表达:...
server_profile
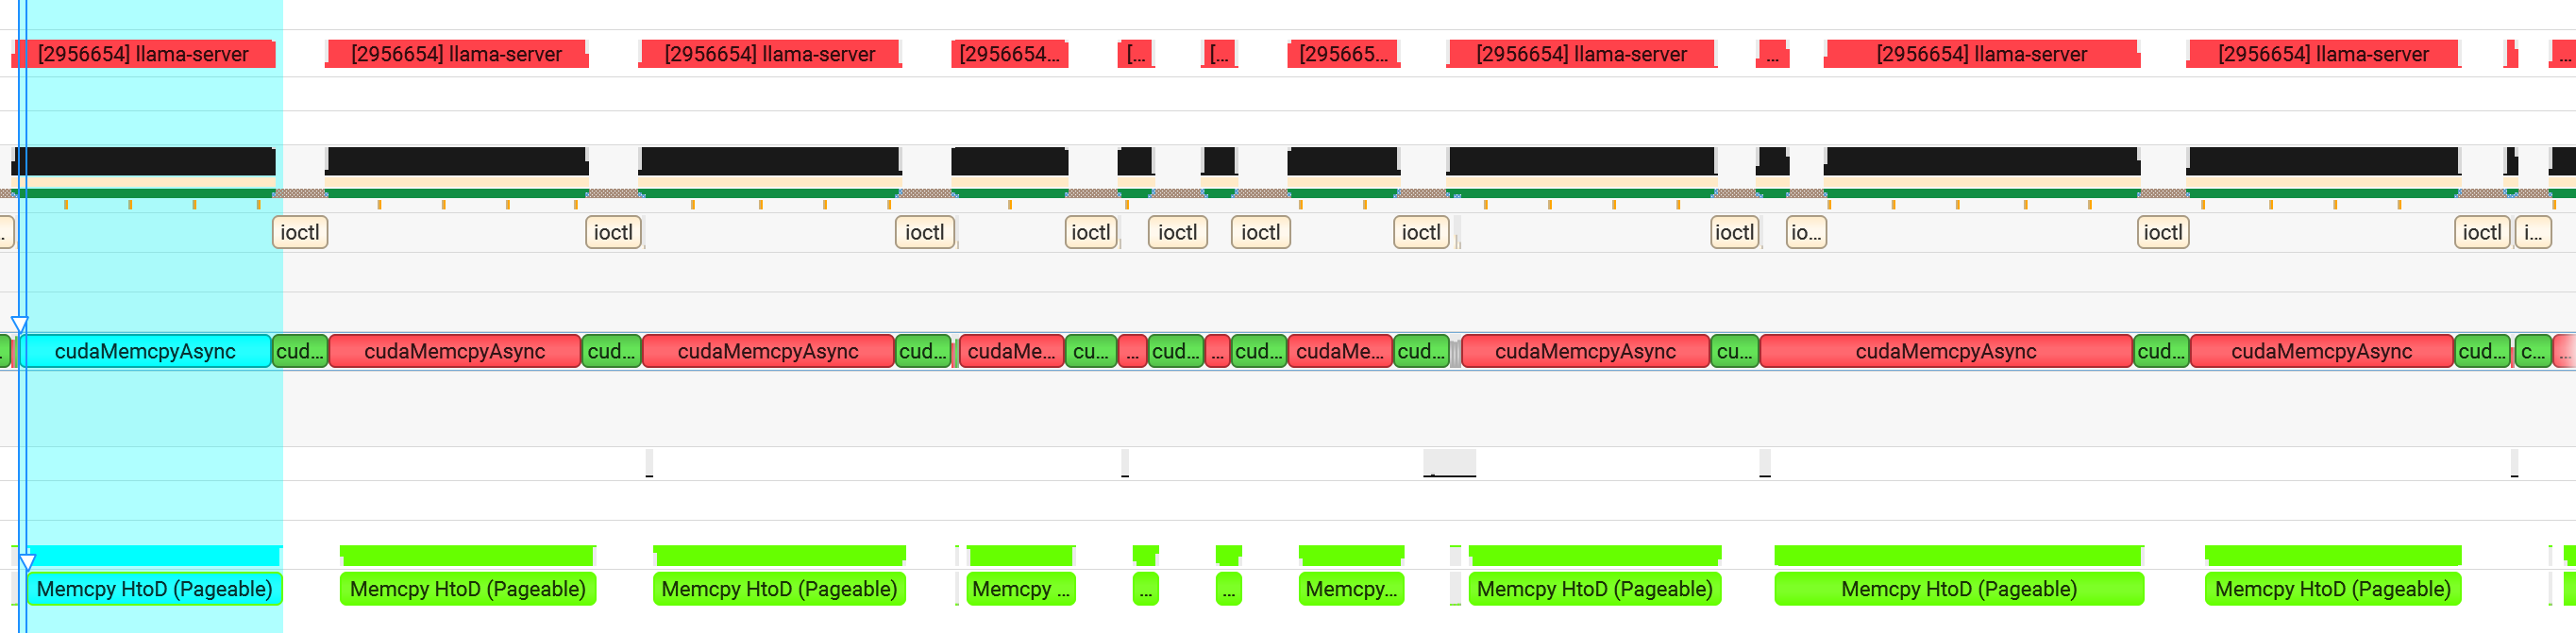
Nsys Profiler Load Model cudamemgetinfo 执行了 373 s,应该是 Orin 的内存探测有问题,可能是其他系统组件影响了这个函数的性能。 使用文件进行 mmap,所以会出现 cudamemasync 之后进行 cuda sync 的情况,导致性能下降。 Forward 也会出现大量的 H2D 拷贝 主要拷贝的不是模型权重,也不是大块 KV cache,而是这些每个 ubatch 都会变化的输入: tokens: 当前 prefill micro-batch 的 token id pos: 每个 token 的 position k_idxs / v_id...
deepep_architecture_notes
DeepEP 架构与实现笔记 本文整理 DeepEP 相关官方文档与源码,重点解释 V2 ElasticBuffer 架构,同时把 V1 legacy 的 NVSHMEM/IBGDA 路径作为对照。源码基于官方仓库 deepseek-ai/DeepEP 的 main 分支临时克隆版本,提交为 d4f41e4e93602a15e95f55f6ee8df8f1aaa0e4bb。 主要参考: DeepEP README DeepEP V1 legacy docs NVSHMEM install guide V1 Python legacy Buffer V1 C++ legacy runtime V...
deepseek
Deepseek Details MoE node-limited routing 每个 token 最多只发到有限个 node,这些 node 根据该 node 上专家的高 affinity 分数之和来选。目的非常直接,就是把跨节点 all-to-all 压下来,给 DualPipe + overlap 创造条件,最终接近计算通信重叠。再配合: 每 step 依据 batch 负载更新 expert bias,而不是靠大 aux loss 硬拉均衡。 再补一个很小的 sequence-wise aux loss,防单条序列极端失衡。 所以训练和推理都可以做到 no token droppin...
llm-compressor框架解析
LLM Compressor 量化原理、架构与算法执行流程 本文整理 llm-compressor 的量化体系:它如何把不同 PTQ / GPTQ / AWQ / SmoothQuant / AutoRound / FP8 / FP4 / KV cache quant 算法封装成 Modifier,如何通过 event 和 hook 在校准前向中收集统计量,如何逐层压缩模型,最后如何保存成 vLLM 可加载的 compressed-tensors checkpoint。 整体阅读顺序: 先理解量化的基础公式和粒度。 再看 llm-compressor 的整体架构、pipeline、event ...
longcontext
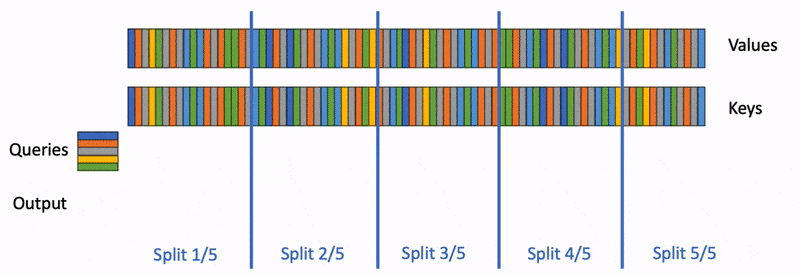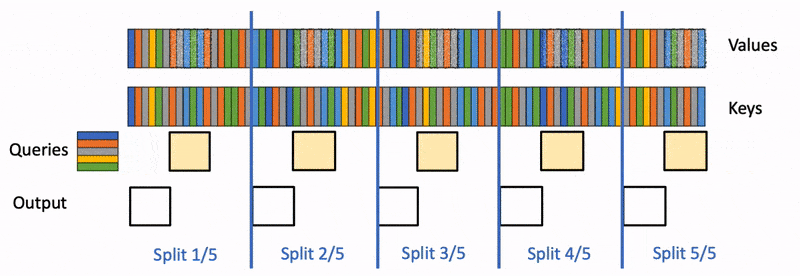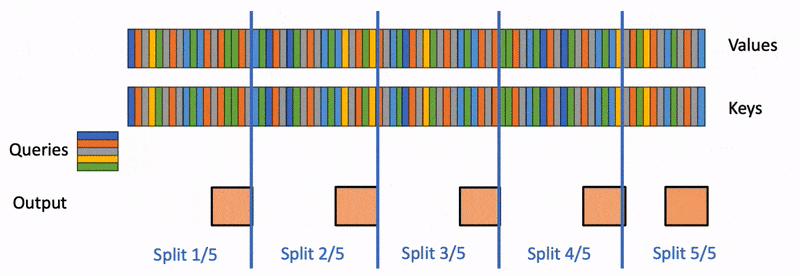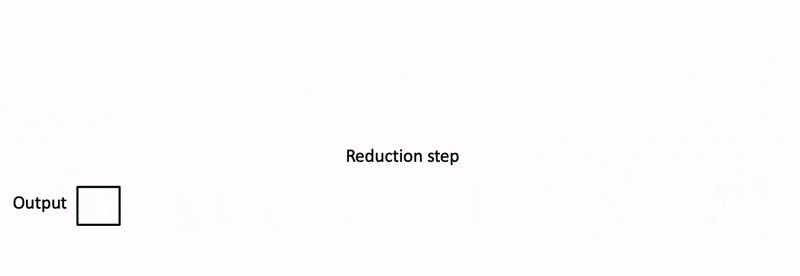
Long Context Attention 长上下文注意力(Long Context Attention)是指在处理长序列数据时,如何高效地计算注意力机制的一种方法。传统的注意力机制在处理长序列时会面临计算和内存的挑战,因为它需要计算所有位置之间的关系,导致计算复杂度为O(n^2)。为了克服这个问题,研究人员提出了多种优化策略,如Ring Attention和Striped Attention,以及后续的 Tree Attention等方法。 Motivation “挑战:我们耗尽了内存” 引用自Ring Attention(2023年,Hao Liu等人的研究): “对于一个隐藏层大小为1...
optimization_tech
CUDA Graph 原理 CUDA Graph 将一段 GPU kernel 序列录制为静态 DAG,之后只需一次 CPU launch 即可重放整个计算流,以此消除逐个 kernel launch 的 CPU 开销。在此基础上,我们更进一步理解 CUDA Graph 的一些核心机制。 构造过程 Capture:捕获或者是录制 CUDA Graph。 调用 cudaStreamBeginCapture() 后,CUDA runtime 进入录制模式——后续所有提交到该 stream 的操作(kernel launch、memcpy、memset 等)都不会真正执行,而是被记录为 DAG 中的...
Prepacking
Prepacking: A Simple Method for Fast Prefilling and Increased Throughput in Large Language Models 阅读笔记.
deepseekv4
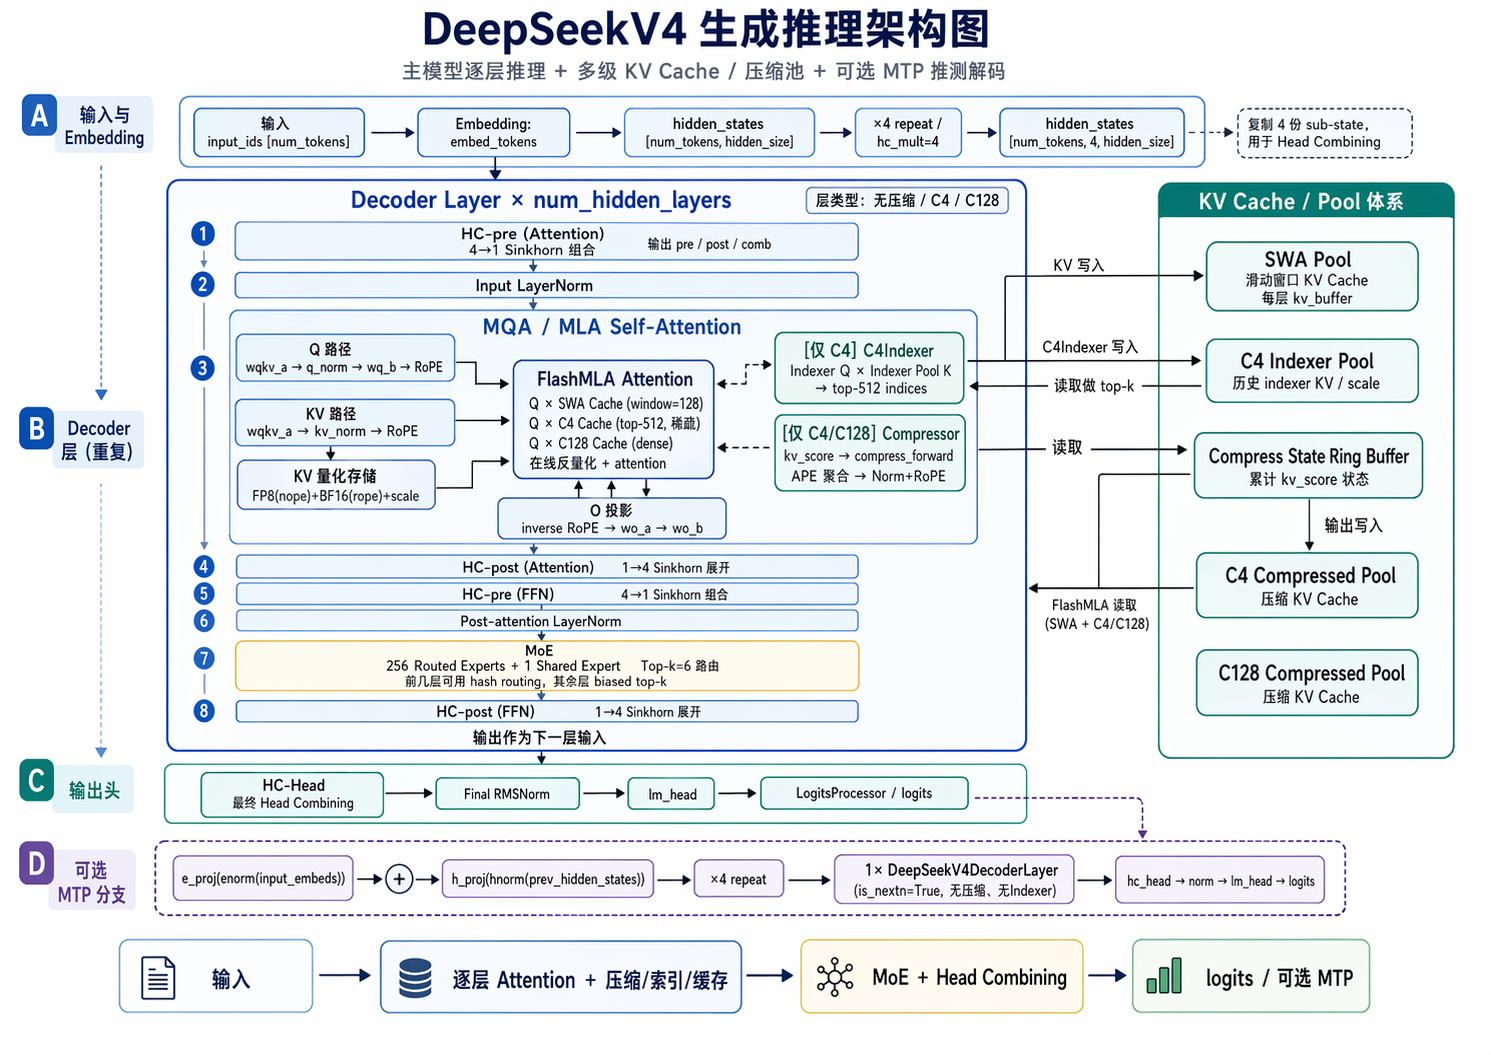
DeepseekV4 模型架构 Attention 这里所有的 Attention 实际上都是 MLA 的方式计算,只是 KV 的压缩程度不同以及是否有 DSA 参与 CSA(Compressed Sparse Attention) Compressed KV Entries:每 m 个 token 生成 1 个压缩 KV,但这个压缩 KV 实际会参考当前 block 的 m 个 token,以及前一个 block 的 m 个 token,一共 2m 个候选 token,然后用 learned softmax 权重加权求和(Overlap) DSA Strategy:对于每个 query,选择...
Chunked Prefill
Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve Motivation Prefill 因为是长序列计算有高延迟,decode 是低延迟但是 GPU 利用率很低 现有的 batching 调度交错 prefill batch 和 decode batch,让高吞吐和低延迟变得困难 Batch 对 decode 吞吐量提升很大,对 prefill 影响小 Decode 阶段计算资源未被充分利用 SM 计算资源空闲:可以在解码批次中处理更多令牌,而不会显着增加其延迟。 线性层在预填充和解码阶段占据了大部分运...
PageAttention
Efficient Memory Management for Large Language Model Serving with PagedAttention Motivation 当时的大模型推理系统直接通过 pytorch 为每个 req 预分配一块连续的内存,会造成内部碎片(因为分配的会过多),外部碎片(因为需要分配连续的);让整个系统的吞吐量骤降,无法高效利用和复用显存 Key Observation KV Cache 当模型生成新的 token 时,它会随着时间动态增长和收缩,并且它的生命周期和长度是未知的。 现有系统预分配 max_token 长度的显存,会导致内部碎片。因为实际...
SGLang
SGLang: Efficient Execution of Structured Language Model Programs.
distserve
DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving Motivation 现有的 LLM 服务系统将 prefill 和 decode 两个阶段并置,并批量计算所有用户和请求的预填充和解码。我们发现这种策略不仅会导致强烈的预填充解码干扰,而且还会耦合两个阶段的资源分配和并行计划。 prefill 关注 TTFT decode 关注 TPOT 现有系统为了满足两种不同的延迟,过度配置计算资源或者牺牲其中一个来满足另一个;这会造成成本效益不足 因此,优化每...
DFLASH
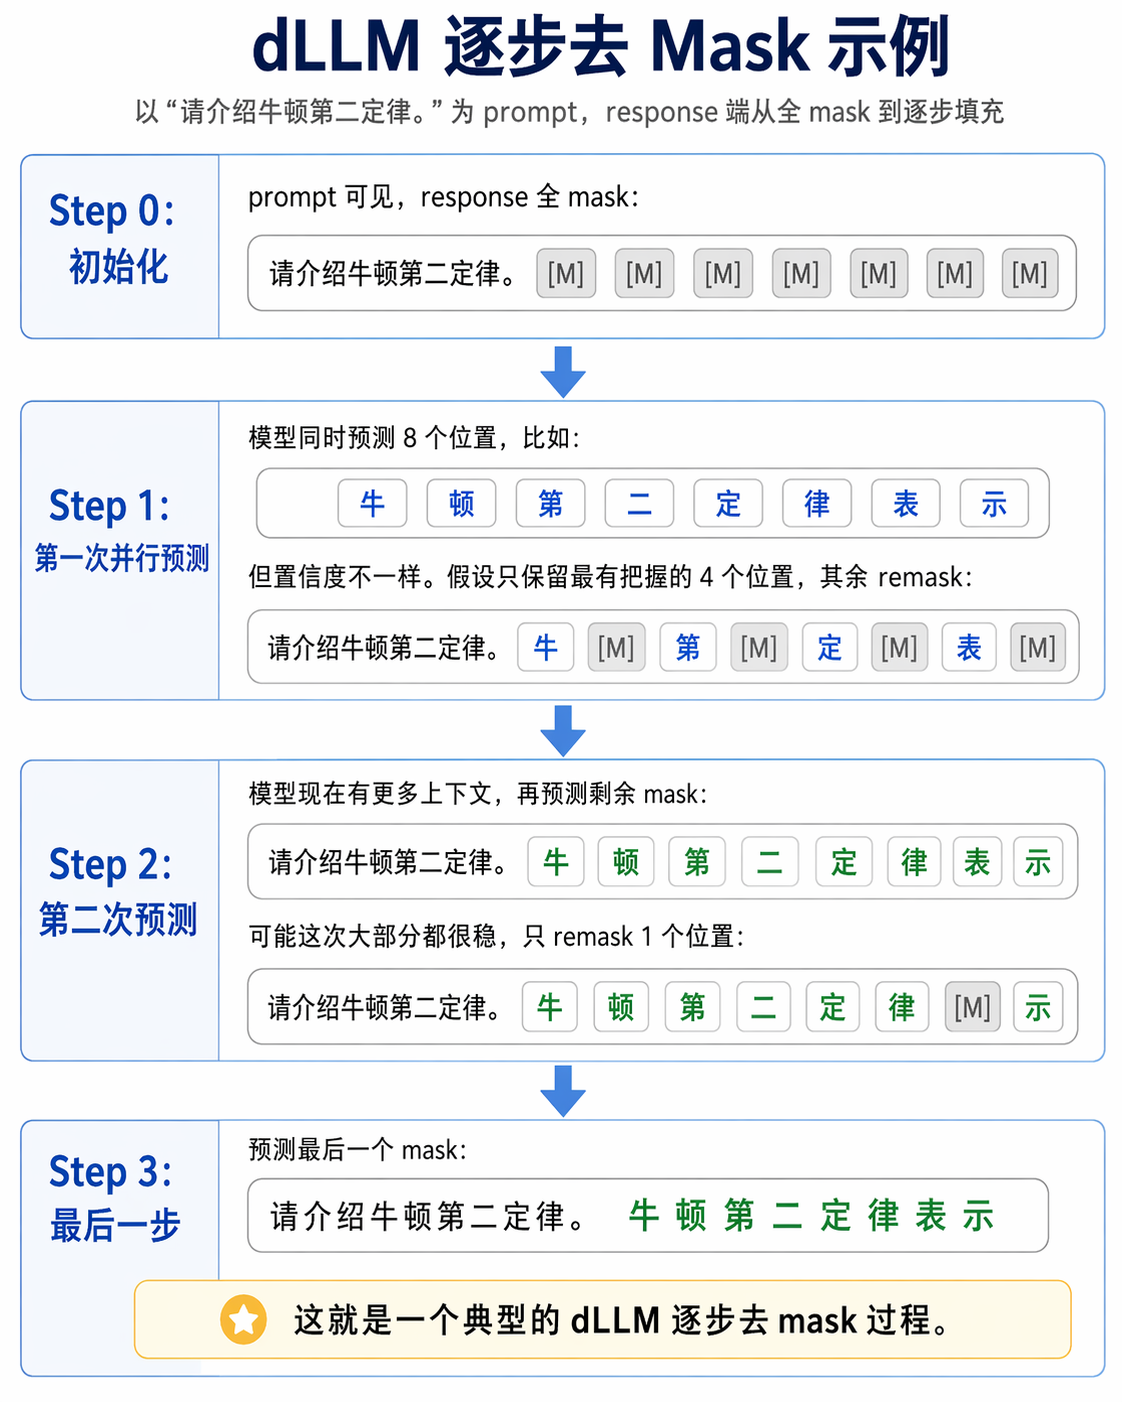
DFlash : Block Diffusion for Flash Speculative Decoding 什么是 DLLM? 在标准的自回归语言模型中,序列的联合概率分布被严格分解为条件概率的连乘:p(x_1,\dots,x_n)=\prod_{i=1}^n p(x_i\mid x_{<i})直观含义:第 i 个 Token 只能基于它前面的 i-1 个 Token 来预测。 dLLM 抛弃了上述的单向连乘约束,转而借鉴了 Diffusion 模型在图像生成领域的成功经验,定义了一个**加噪与去噪”**的过程: Forward Process (前向加噪):在训练阶段,拿一段干净的...
SD in Llama
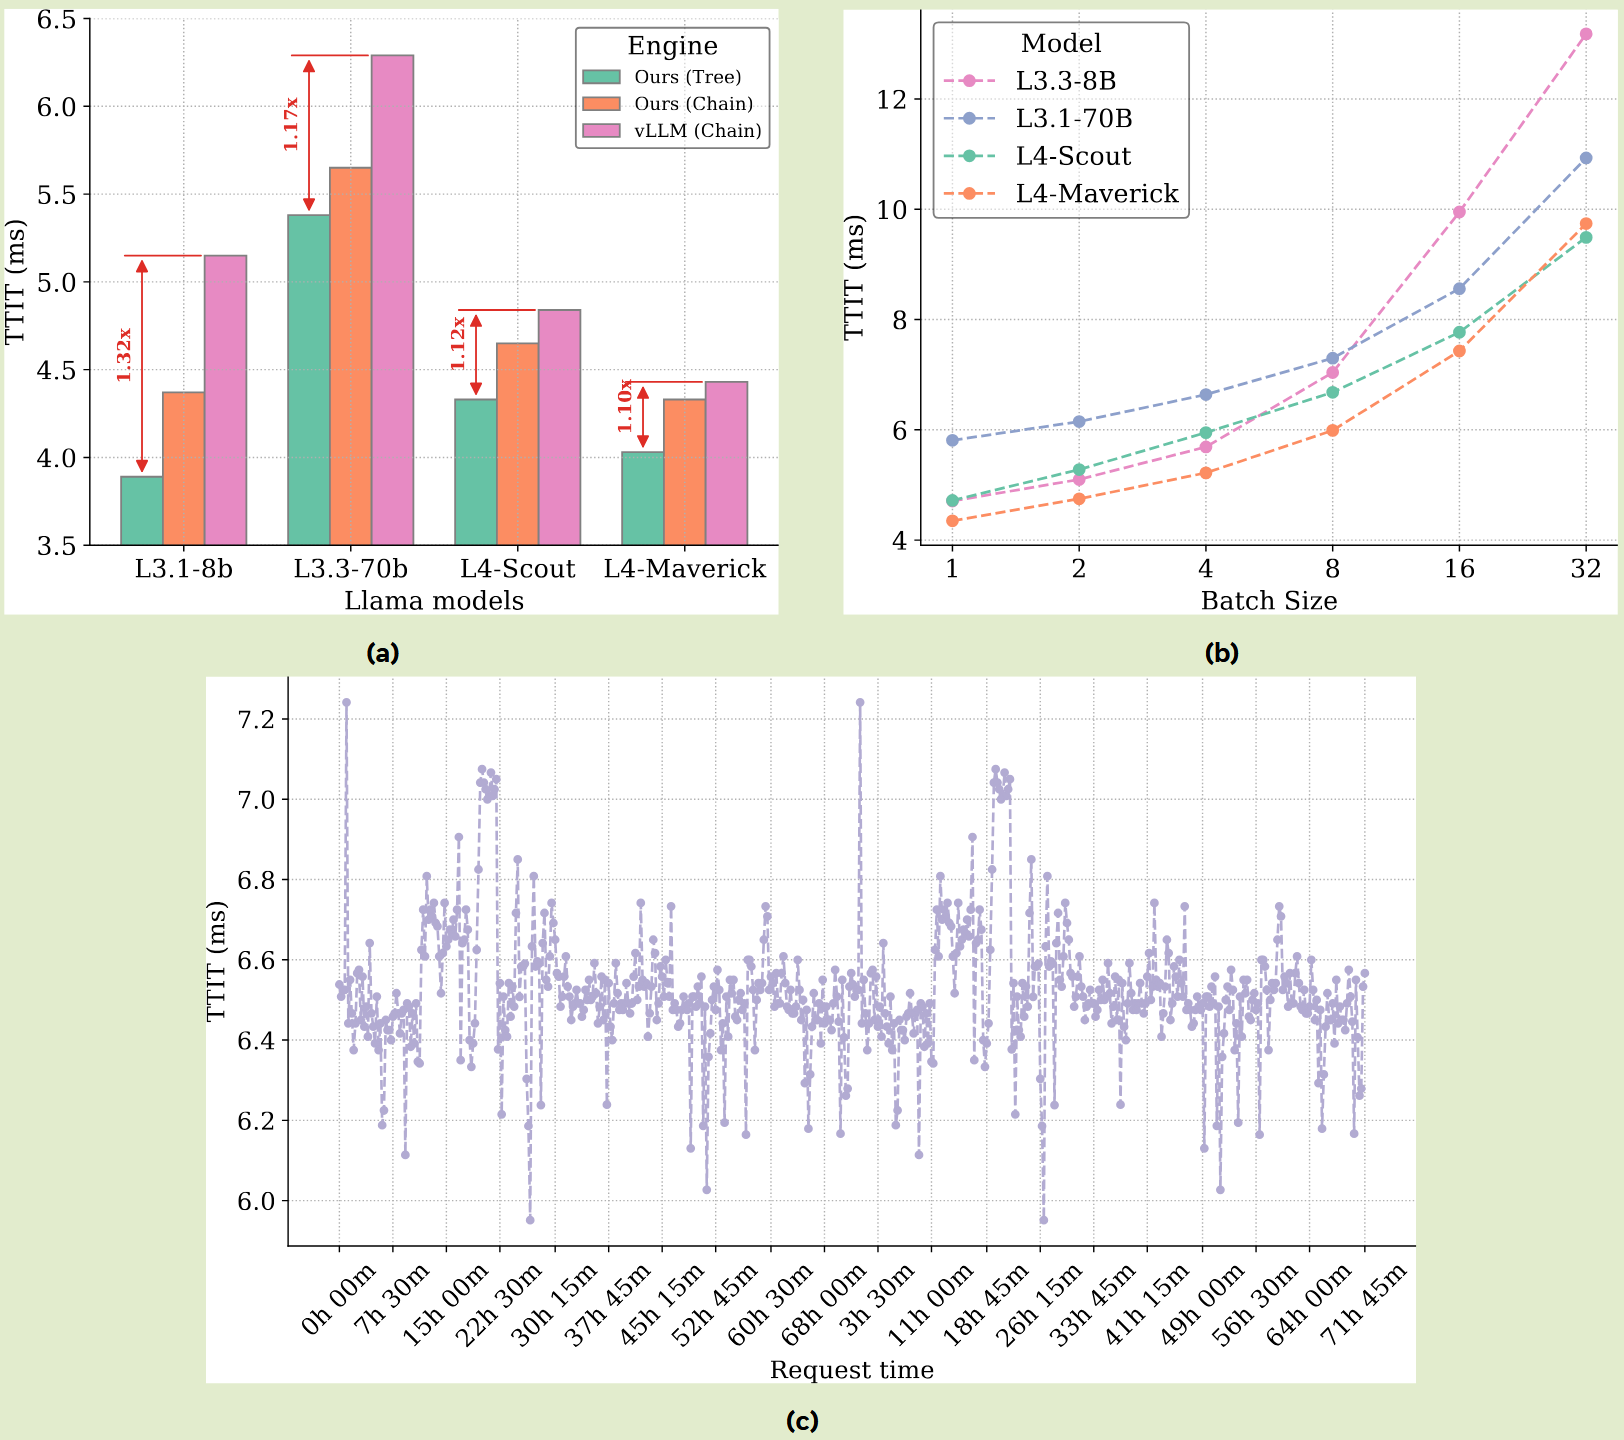
Efficient Speculative Decoding for Llama at Scale: Challenges and Solutions NOTE 在 8 个 NVIDIA H100 GPU 上以每个 token 约 4 ms(批量大小为 1)的速度进行解码,这比之前最知名的方法快了 10%。 对于基于 EAGLE 的推测解码,我们的优化使我们能够在生产规模上实现 1.4 倍到 2.0 倍之间的大规模部署上的加速 这篇文章从训练和推理两方面对现在 eagle-based 的 sd 方法如何在大规模生产环境下使用提出了一些方法。 暂时只看了推理部分 Inference 这里使用了 ...
eagle
(EAGLE 1)EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty Key Observation 特征(second-to-top-layer)级别的自回归比令牌级别更直接。 这一层的 feature 更有规律,在特征级别进行自回归处理,然后使用原始 LLM 的 LM 头导出标记比直接自回归预测标记更有效率。 采样过程中固有的不确定性极大地限制了预测下一个特征的性能。 对“am”或“always”等不同的 token 进行采样会产生不同的特征序列,从而在特征级自回归中引入歧义 EAGLE 将后一步的 tok...
eagle2
(EAGLE 2)EAGLE-2: Faster Inference of Language Models with Dynamic Draft Trees Key Observation Context-Dependent Acceptance Rates draft token 的接受率与位置相关,位置 P1 的接受率最高,位置 P6 的接受率最低 同一位置的接受率存在显着差异,这表明 draft token被接受的概率不仅取决于其位置,还取决于上下文。这表明上下文感知的动态草图树比静态草图树具有更大的潜力 Well-Calibrated Draft Model 为了应用动态草案树,我们需...
eagle3
(EAGLE 3)EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test Motivation 当前的 EAGLE 范式在 scaling-up 上已经达到了瓶颈,无法通过更多的训练数据来提升 EAGLE 的性能,需要分析原因并改进 Key Observation EAGLE 在特征层面进行自回归预测,预测下一个特征,然后将特征输入到目标模型的 LM head 中以获得 token 分布。 EAGLE 的损失函数由两个部分组成:特征预测损失 l_{fea} 和 toke...
survey on parallel text gen
A Survey on Parallel Text Generation: From Parallel Decoding to Diffusion Language Models AR-Based 遵循 Draft-and-Verify 范式 [图片] 最大目标是最大化期望的吞吐率 A 是 accept tokens L(\mathcal{M})denote the latency of a single forward pass for model M.
batch-invariant kernel
Batch-Invariant Kernel 实际上是在硬件、软件栈以及 sampling temperature = 0 严格受控情况下的,输出确定性 Motivation 浮点结合律 浮点数加法不满足结合律,即:(a + b) + c \neq a + (b + c) 在 GPU 计算中,为了追求极致速度,成千上万个线程会并行计算。如果计算的顺序发生了哪怕一丁点改变,由于舍入误差(Rounding errors),最终的结果在比特位级别(Bit-level)就会产生微小差异。由于 LLM 是一个深度堆叠的非线性系统,这种微小的差异会随着层数增加被迅速放大,最终导致生成的下一个 Token ...
eplbopt
GRACE-MoE 优化 一种针对稀疏混合专家(SMoE, Sparse Mixture-of-Experts)模型在分布式多GPU集群上推理时的综合优化方案。SMoE模型的核心痛点在于:跨设备通信开销大与计算负载极度不均衡。 文中提出的三个核心Idea层层递进,形成了一个闭环:先通过分组减少通信(但加剧了负载不均衡),再通过复制缓解负载不均衡,最后通过路由在通信和计算之间找到最优的执行路径。 Core Idea 1.
从 Volta/Turing、Ampere、Ada 到 Hopper:硬件、PTX 与 Kernel 编程范式演进
沿着 Volta/Turing、Ampere、Ada、Hopper 的硬件、PTX 与 kernel 编程范式,连接白皮书峰值、微基准和真实算子,分析每代架构为什么变快,以及未达理论性能时如何区分硬件边界与优化问题。
Model Forward 瓶颈以及优化方法
Model Forward 瓶颈以及优化方法
Speculative Decoding
Speculative Decoding Draft 负责便宜地提一个多步候选树 Verify Target Model 在每一轮验证时的逻辑输入由两部分构成: 已验证的前缀 (Verified Prefix): 即截至上一轮已确认正确的 Token 序列,记为 x_{<n}。这部分通常已经存在于 KV Cache 中。 本轮候选 Token / Tree (Draft Proposals): 由 Draft Model 生成的 k 个候选 Token \{x_n, x_{n+1}, \dots, x_{n+k}\},或者是树状结构的候选节点。 对于 Draft Model 提出的线性序...
Quantization in LLM Inference
Quantization in LLM Inference 对称量化:认为数值分布大致以 0 为中心 量化:q = round(\frac{x}{s}) 反量化:\hat{x} = q \cdot s 其中 s 是 scale,表示量化单位的大小,通常根据数值范围和量化位数 b 计算得到: s = \frac{\alpha}{2^b - 1} \alpha 是数值范围的绝对值上界,例如 \alpha = \max(|x_{min}|, |x_{max}|) 非对称量化:允许数值分布不以 0 为中心,因此需要额外的偏移量(zero-point)来表示 0 的位置 量化:q = round(\fr...
Attention & Transformers
首先从概率论角度介绍语言生成模型最终训练目标然后介绍注意力机制(Attention)及其在 Transformer 架构中的应用,并详细解析 Transformer 的结构和工作流程。
PD Disaggregation in SGLang
本文将从为什么需要 PD 分离开始讲起,通过几篇论文来讲述现在 PD 分离演进的路线,以 SGLang 中 PD 分离的实现作为 example 进行解析;由于笔者之前做过分布式相关的项目,将其中的状态机与 Raft 浅浅做了以下对比。
DIFFUSION LANGUAGE MODELS KNOW THE ANSWER BEFORE DECODING 论文精读
DIFFUSION LANGUAGE MODELS KNOW THE ANSWER BEFORE DECODING 香港理工大学、达特茅斯学院、Google DeepMind 等组织发表 Abstract 随着扩散语言模型(DLM)在各个领域的快速发展,其已成为自回归(AR)模型有力的替代方案。与 AR 模型相比,DLMs 的主要优势包括但不限于:高效的并行解码和灵活的生成顺序。 然而 DLMs 推理时需要双向注意力计算,而且为了高质量的 token 需要多步的 refine,这使得 DLMs 在推理速度上远远落后于 AR 模型,限制了其在实际应用中的使用。 本文,来自香港理工大学、达特茅斯学...
FlashAttention 原理 v1-v3
本文详细介绍 FlashAttention 的原理及其 v1-v3 版本的改进点,涵盖 Online Softmax、分块计算以及并行化优化等关键技术。
Parallelization in LLM Inference
本文介绍了在基于 Transformer 的大规模语言模型(LLM)中常用的并行化技术,包括数据并行(DP)、张量并行(TP)、流水线并行(PP)、专家并行(EP)以及序列并行(SP)和上下文并行(CP)。通过 deepseek-V3 来进行具体分析这些并行化技术在训练和推理中的应用。
Parallelization Concepts
本节主要介绍大模型训练中的并行化技术,涵盖数据并行、模型并行、流水线并行和张量并行等方法。我们将从 Transformer 的参数量、Flops 以及训练占用显存入手,分析为什么需要并行化技术,并介绍这些技术的基本原理。
从 GEMM 实践 CUDA 优化
本文将从最 naive 的 GEMM 实现开始,使用 nsight compute 工具进行性能分析寻找瓶颈并一步步进行优化。通过这种方式来实践 CUDA 中的各种优化技巧,包括 Tiling、Free Bank Conflict、Double Buffer、wmma 指令优化等。
DiT Generate Model in SGLang
DiT Generate Model in SGLang 常见 DiT Generate 模型 Stable Diffusion 3(Image Generate) NOTE 文本(Text)和图像(Image)是两种本质不同的模态,因此应该使用两套独立的权重来分别处理它们,但在注意力机制(Attention)阶段允许两者进行交互。 双流架构:文本流 c 与图像流 x 各自用独立权重处理,仅在注意力处交互,以更好保留各自模态特征。 全局调制:由时间步 t 与汇聚文本向量构成的 y 经 SiLU+Linear,为两流各自产生 6 组调制参数(\alpha,\beta,\gamma,\delta,...
Masked Diffusion Large Language Model
Masked Diffusion Large Language Model 📚 这里以 Ant Group 的 LLaDA 论文为例,介绍 Masked Diffusion LLM 的基本原理和实现方法;后面结合 SGLang 对该模型的推理实现进行说明。 Traing Details 基于掩码的扩散模型(Masked Diffusion Model) LLaDA 通过定义前向过程(Forward Process)和反向过程(Reverse Process)来建立模型分布 p_\theta(x_0)。 前向过程(破坏数据):LLaDA 不像传统扩散模型那样添加高斯噪声,而是通过掩码(Mask...
MultiModel Generate in SGLang
MultiModel Generate in SGLang Overview SGLang Diffusion 采用了 Client-Server 架构,结合 多进程 (Multi-Process) 和 模块化流水线 (Modular Pipeline) 设计。 Client (DiffGenerator): 用户接口,负责发送请求和接收结果。 Server (Scheduler & Workers): 后端推理服务,由多个 GPU Worker 进程组成。 Rank 0 (Scheduler): 主节点,负责接收 Client 请求,并通过分布式广播将任务分发给所有 Worker。 ...
一条 Request 在 SGLang 的前世今生
本文将介绍在 SGLang 中,一条请求从到达系统到最终完成的全过程,涵盖请求的接收、调度、执行以及结果返回等关键环节。
RadixAttention 你需要知道的细节
本文深入探讨 SGLang 中 RadixAttention 的实现细节,涵盖 Radix Tree 结构、前缀匹配、内存管理与驱逐策略,以及 Cache-Aware Scheduling 的工作原理。
SGLang 中的 TP + PP 流程浅析(以 Qwen2 为例)
这里我们以 Qwen2 模型为例,开启 PP + TP 分析一下 SGLang 是如何实现模型推理的并行的
大模型推理服务中的 Batching
现在的大模型推理的框架基本都实现了 Continuous Batching,本文将从大模型推理服务为什么需要 Batching 开始,逐步讲解该领域的技术演进,包含调度层和计算层的相关优化技术。
从代码看 SGLang 的 KV Cache
本文将深入解析 SGLang 的 KV Cache 实现细节,介绍其组件结构、工作原理以及在模型推理中的应用。
Page Attention
本文深入探讨 Page Attention 的实现细节,涵盖 GPU Tiling、矢量化访问、分层计算结构以及注意力内核的具体实现过程,帮助读者理解其高效计算注意力机制的原理。
SGLang Scheduler 技术变迁
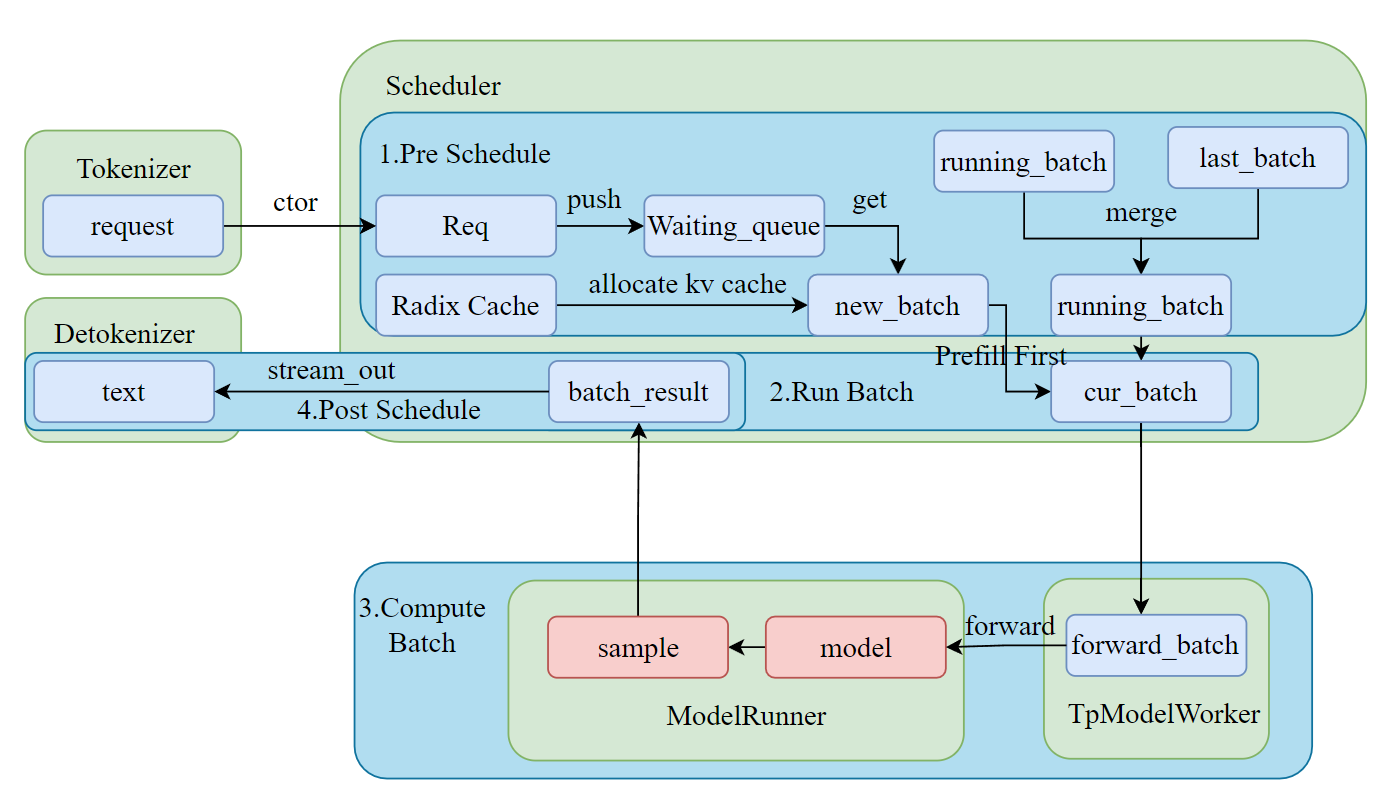
本文将结合代码分析 SGLang Scheduler 的技术演进,介绍其核心数据结构和工作流程,帮助读者深入理解调度器的实现细节。
Data Parallelism in Attention in SGLang
本文介绍 SGLang 中 Attention 层的数据并行(DP Attention)机制,涵盖其设计理念、实现细节及执行流程,旨在提升模型推理的效率和性能。
一步步实现 CUDA Vector Add 优化
本文将通过一个简单的 CUDA Vector Add 例子,介绍如何使用 Nsight Compute 工具进行性能分析,并一步步进行优化。
Batching Inference & KV Cache
Batching Inference & KV Cache KV Cache Question without KV Cache Attention 计算实际上是与 seq_len 平方成正比的,所以 prompt 变长的话,我们的 FLOPs 会很快增长到超过 Single GPU 的计算能力(Compute-Bound) “Aha!”时刻: 当我们去预测第 9 个词时,我们需要: Q = 第 8 个 token 的 Query 向量。 K = ["The", ..., "and", "the"](所有 8 个 token)...
Group Query Attention
GQA: Group Query Attention Group Query Attention 这是一种针对多头注意力机制的优化技术,可以降低与键 (K) 和值 (V) 投影相关的计算和内存成本。与多头注意力机制 (MHA) 中每个查询 (Q) 头都有自己的 K 头和 V 头不同,多个 Q 头共享相同的 K 头和 V 头。多查询注意力机制 (MQA) 是 GQA 的一个特例,其中所有 Q 头共享一个 K/V 头对。 实际上在应用时,我们还会再计算 q @ k 后进行 mask 叠加,这里一般有两种情况: 一种就是我们自己设计的 mask 形式 一种就是 causal mask(因果掩码),用...
RMSNorm & MLP
RMSNorm & MLP RMSNorm RMSNorm1 的定义: y = \frac{x}{\sqrt{mean(x^2) + \epsilon}} \cdot weight x 是输入张量。 weight 是一个可学习的缩放参数。 epsilon(eps) 是为了数值稳定性而添加的一个小常数(例如,1e-5 或 1e-6)。 mean(x^2) 是平方和然后除以元素的数量 LayerNorm 成功的关键在于其 “重新缩放” (re-scaling) 的不变性,而 “重新中心化” (re-centering,即减去均值) 这一步可能不是必需的 归一化方法 方法归一化维度是否依赖批...
Introduction
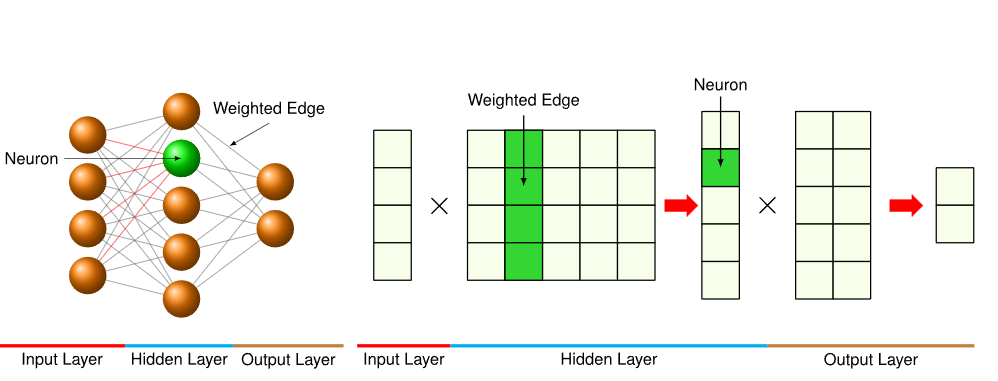
本文介绍了不同神经网络架构(如 MLP、CNN、RNN 和 Transformer)对计算模式的影响,探讨了这些模式如何映射到计算机系统资源,包括内存访问模式、计算特性、数据移动和资源利用。
Transformer-based LLM
本章介绍基于 Transformer 架构的大规模语言模型(LLM),涵盖其核心组件如位置编码、注意力机制、归一化方法和前馈网络。