
Transformer-based LLM
现在的大模型基本是 Transformer-based 的自回归预训练模型,本章我们将以 llama2 为例介绍这种模型的基本结构。
- Positional Encoding: RoPE
- Attention: Multi-Head Attention or Multi-Query Attention or Grouped-Query Attention or Multi-Head Latent Attention or DeepSeek Sparse Attention
- Normalization: LayerNorm or RMSNorm
- FFN: MLP or SwiGLU or Mixture of Experts
Overview
以 Transformer 架构为基础的 Large Language Models 的整体流程是基于 Transformer Block 的,每个 Transformer Block 主要由 Multi-Head Self-Attention Block,Feed Forward Network 以及 Layer Normalization 组成。每个 Transformer Block 的输入是上个 Transformer Block 的输出。

LLMs 推理是一般分为两个阶段 prefill 阶段和 decode 阶段:
- Prefill Stage: LLM 计算并存储初始输入 token 的 KV cache,并生成第一个 output token
只有这个阶段 Q*K 是矩阵,decode 阶段通过 KV 缓存只会生成新的一行
- Decode Stage: LLM 通过 KV cache 逐个生成 output token,然后用新生成的 token 的 KV 对更新 KV cache

Positional Encoding
一般分为两大类:绝对位置编码(Absolute Position Encoding)和相对位置编码(Relative Position Encoding)。本节将介绍这两种位置编码的区别及其重要性,并重点解析一种结合了两者优点的创新方法——旋转位置编码(Rotary Position Embedding, RoPE)
Why we need Position Encoding
在自然语言处理领域,Transformer 模型已成为一项革命性的技术。然而,其核心的自注意力机制本身并不具备捕捉序列中单词顺序的能力,即位置无关性。为了解决这一问题,位置编码应运而生。
绝对位置编码(Absolute Position Encoding)
给序列中的每个位置一个唯一的向量,把位置信息直接加到 token embedding 上。
- 固定式:不用学习参数,能推广到比训练时更长的序列
在最初的 Transformer 论文《Attention Is All You Need》中,作者使用正弦和余弦函数来生成这些位置编码。其数学表达式如下:
- 可学习式:模型可以学到适合任务的位置信息。训练时没见过的长序列可能无法泛化
相对位置编码(Relative Position Encoding)
相对位置编码是根据单词之间的相对位置关系来计算位置编码。这种编码方式更加灵活,能够捕捉到不同单词之间的相对位置信息,有助于模型更好地理解序列中单词之间的关系。但是也有缺点,计算效率低下,同时大部分相对编码都没有落地可行性。
ALiBi: Attention with Linear Biases
不给 token embedding 加位置向量,也不旋转 Q/K,而是在 attention score 上按距离直接减去一个线性惩罚。形式通常写成:
其中:
- 是第 个 head 的 slope
- 距离越远,惩罚越大
- 不同 head 有不同 slope,有的更看近处,有的更看远处
ALiBi 原论文报告它能在较短训练长度下外推到更长输入,并且几乎不增加参数和运行成本
很多现代 LLM 实践里,效果通常仍不如 RoPE 家族稳定全面
Rotary Position Embedding (RoPE)
将位置编码与词向量通过旋转矩阵相乘,使得词向量不仅包含词汇的语义信息,还融入了位置信息
给位置为 m 的向量 q 乘上矩阵)、位置为 n 的向量 k 乘上矩阵)用变换后的 Q,K 序列做 Attention,Attention 就自动包含相对位置信息
-
相对位置感知:使用绝对位置编码来达到相对位置编码的效果,RoPE 能够自然地捕捉词汇之间的相对位置关系。
-
无需额外的计算:位置编码与词向量的结合在计算上是高效的。
-
适应不同长度的序列:RoPE 可以灵活处理不同长度的输入序列。
目的
我们假设通过下述运算来给 q,k 添加绝对位置信息,然后通过 Attention 的内积运算,内积的结果带有相对位置信息:
所以我们要求出该恒等式的一个(尽可能简单的)解。求解过程还需要一些初始条件,显然我们可以合理地设 和
实现
位置 m 的编码进行解方程,我们得到二维情况下用复数表示的 RoPE:
矩阵形式:
由于内积满足线性叠加性,因此任意偶数维的 RoPE,我们都可以表示为二维情形的拼接,即

⚠️ 由于)具有稀疏性,不建议使用 matmul 进行实现,建议使用下面的方式实现:其中)是逐位对应相乘,即 Numpy、Tensorflow 等计算框架中的 ∗ 运算

问题
- 位置维度和内容维度强耦合:对于一些架构,特别是 MLA 这类压缩 attention 表达的结构,可能不希望所有维度都带旋转位置信息
- 对上下文扩展很敏感:所以后来有很多 “RoPE scaling / interpolation / NTK-aware scaling / YaRN / LongRoPE”等变体
Partial RoPE
只对 Q/K 的一部分维度施加 RoPE,剩下维度保持不旋转。
假设 head_dim 是 ,只对前 维做旋转,后面 维不动:
然后:
最后 score 变成:
目的
-
不是所有维度都需要位置敏感:有些维度更适合表达语义内容,不一定适合被相位旋转。
-
降低长上下文时的高频扭曲:RoPE 的高频维度在超长外推时更容易出问题。只让部分维度承担旋转,可以减少这种影响。
-
适配 MLA / latent attention 一类结构:在 MLA 里,Q/K/V 有更强的低秩压缩和结构约束。把所有维度都塞进 RoPE,可能会损伤压缩后的表达效率。近年的 MHA2MLA 工作就把 partial RoPE 作为关键设计之一,用来仅保留对 attention 分数更重要的旋转维度
RoPE Scaling
训练只见过 ,推理要跑更长 ,那就不要让位置 m 直接照原公式进旋转,而是做一个缩放:
或者某种非线性映射,再代入旋转角度。
直觉上是把更长序列压缩映射回训练时更熟悉的角度范围,减轻超长时的相位失真。
Attention Series
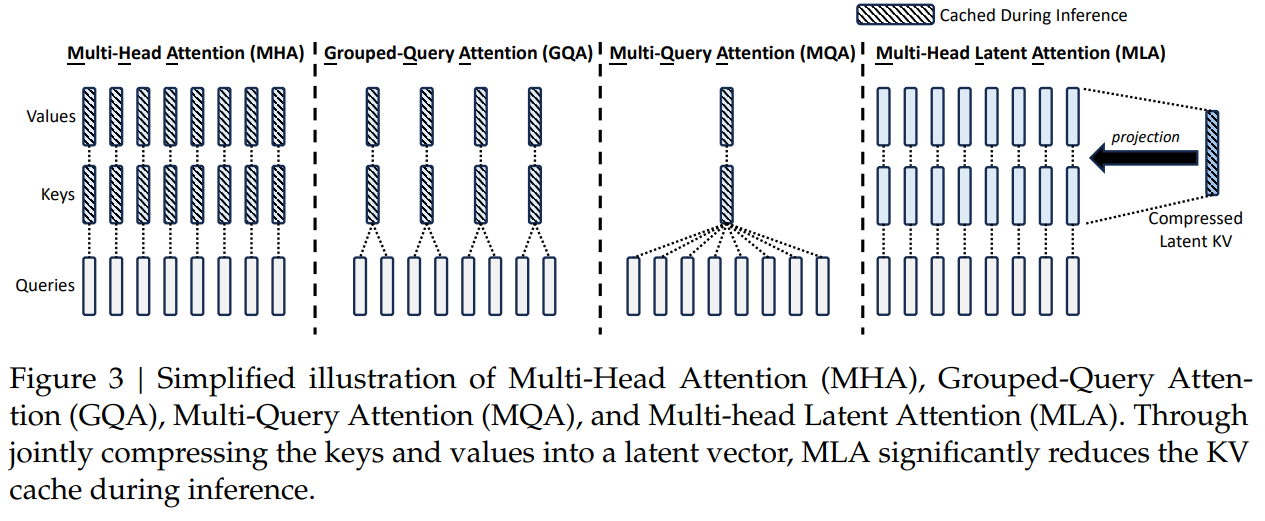
- 在 MHA (Multi Head Attention) 中,每个头有自己单独的 key-value 对;标准的多头注意力机制,h 个 Query、Key 和 Value 矩阵。
- 在 MQA (Multi Query Attention) 中只会有一组 key-value 对;多查询注意力的一种变体,也是用于自回归解码的一种注意力机制。与 MHA 不同的是,MQA 让所有的头之间共享同一份 Key 和 Value 矩阵,每个头只单独保留了一份 Query 参数,从而大大减少 Key 和 Value 矩阵的参数量。
- 在 GQA (Grouped Query Attention) 中,会对 attention 进行分组操作,query 被分为 N 组,每个组共享一个 Key 和 Value 矩阵 GQA 将查询头分成 G 组,每个组共享一个 Key 和 Value 矩阵。
- GQA-G 是指具有 G 组的 grouped-query attention。
GQA-1 具有单个组,因此具有单个 Key 和 Value,等效于 MQA。而 GQA-H 具有与头数相等的组,等效于 MHA。
- GQA-G 是指具有 G 组的 grouped-query attention。

Why GQA?
ARM 中,Attention 的瓶颈并不在算力,而在 KV cache 的显存和带宽。
MQA 和 GQA 的出发点都是减少 KV Cache 的显存占用和内存带宽,从而提升推理速度。但是 MQA 所有的 Query 头都共享同一组 Key 和 Value,导致模型表达能力下降。而 GQA 则通过将 Query 头分组,每组共享一组 Key 和 Value,在一定程度上保留了模型的表达能力,同时仍然减少了 KV Cache 的显存占用和内存带宽。
Multi-Head Latent Attention(MLA)
目的:不完全将 head 的 K/V 去掉,而是用一个低秩 latent 表示,把 head-specific 的投影推迟到计算时完成。
- KV cache 与 head 数无关
- 推理阶段 等价于 MQA
- 训练阶段 仍保留 MHA 的多头表达能力
- 吸收操作可防止 KV 缓存恢复到其原始大小。
KV Cache
对长度为 的序列,MLA KV cache 实际是:
| 方案 | KV cache 大小(近似) |
|---|---|
| MHA | |
| GQA | |
| MLA |
其中:
训练阶段
- 在训练阶段,除了多了一步低秩投影以及只在部分维度加 RoPE 外,MLA 与 Q、K 的计算与 MHA 是基本相同的
RoPE 的计算后投影矩阵与位置相关,为了解决这个问题,对 Q 和 K 的低秩投影分为两部分,一部分是原始的投影矩阵,另一部分是与位置相关的投影矩阵
标准 MHA:
对第 i 个 token 第 s 个 head:
kv cache 需要存储所有的 ,与 head 数成正比。
MLA:
MLA 在 KV 计算前增加一层共享低秩投影
接着做 head-specific 投影:
推理阶段
利用矩阵吸收实现 MQA 级推理效率。
- 避免了在推理阶段将 K 恢复到原始大小的昂贵操作。
- 在线阶段就不必先恢复 full value 再做 output projection,而是可以直接从 latent 输出映射到最终 hidden,减少中间张量和访存。
注意力 logits:
重写为:
定义新的 Query 投影矩阵:
于是:
原始输出:
定义:
于是:
在 Transformer 里,多头输出会 concat 然后乘一个输出矩阵 :
把上面的 代进去,相当于:
KV cache 只需要缓存:
与 head 数 完全无关,所有 head 共享同一份 KV latent。与 head 相关的信息全部吸收到 Query 和输出矩阵中。
RoPE 解耦
- 和位置无关的内容部分已经被压成共享 latent ,per-head 的差异被全部搬到Q / 输出侧的矩阵里;
- 和位置有关的 RoPE 部分,K 也是共享的,但每个 head 的 Q 不一样,所以每个 head 看到的 logits 还是不同的。
为 RoPE 是一个跟位置相关分块对角矩阵,满足,MLA 加入 RoPE 之后会让固定的投影矩阵与位置相关:
这里的 就无法合并为一个固定的投影矩阵了(跟位置差 相关),从而 MLA 的想法无法结合 RoPE 实现。
每个 Attention Head 的 Q、K 新增 个维度用来添加 RoPE,其中 K 新增的维度每个 Head 共享:
Why RoPE-K shared?
K 矩阵仅需共享的 ;head 间的差异完全由各自的 在 Q 侧体现。
完整推理过程
-
生成 Query
- 内容部分(已吸收):
- 位置部分:
-
生成并缓存 KV
-
Attention 分数计算
- 内容分数:
- 位置分数:
- 总分数:
-
Value 聚合(在压缩空间)
形状:。
-
输出投影
映射回 维。
Linear Attention
所以 linear attention 的核心目标就是:
避免显式构造 的 attention matrix,把复杂度从二次降到线性。
传统 Attention 的计算方式是:先算 Query 和 Key 的相似度矩阵,再乘 Value:
Linear Attention 的核心思想是去掉 Softmax,利用一个特征映射函数 来代替,然后利用矩阵乘法的结合律,改变计算顺序:
我们将 提前计算好(它是一个固定大小的矩阵),这样复杂度就降到了 。在自回归(RNN)视角下,它可以表示为隐状态 的不断累加:
Gated DeltaNet
初代的 Linear Attention 虽然速度快,但语言建模能力一直不如标准 Transformer。研究界经过几年的探索,最终演进出了 Gated DeltaNet
- 阶段一:Vanilla Linear Attention (2020)
- 机制:单纯地把历史信息无脑累加到隐状态 中。
- 痛点:记忆像一个不断塞满的垃圾桶,模型无法区分重要和不重要的信息,导致长文本表现拉胯。
- 阶段二:Gated Linear Attention, GLA (2023-2024)
- 进化:向 RNN / LSTM 借用了“遗忘门(Forget Gate)”的思想,引入了数据驱动的 Gating 机制。
- 机制:。其中 是一个根据当前输入计算出的标量(或向量)。
- 效果:模型拥有了“全局重启开关”,当遇到新话题时,可以通过让 快速衰减并清空无关的历史记忆。
- 阶段三:DeltaNet (2024)进化:引入了神经网络早期的 Delta Rule(增量学习法则)。
- 机制:不再无脑写入 ,而是先看当前记忆里已经有了什么(提取特征 ),然后只把目标值 与当前预测值 的差值写入记忆。
- 效果:模型拥有了“精准橡皮擦”,可以实现精确的记忆覆盖(Selective Overwriting),大幅提升了信息检索(如大海捞针)的能力。
- 阶段四:Gated DeltaNet (2024-2026)终极形态:结合了 Mamba/GLA 的 Gating 机制(全局遗忘) 和 DeltaNet 的 Delta Rule(精准修改)。
- 机制:
- 应用:以极小的性能损耗,在长文本、数学推理和检索上打平甚至超越了标准 Attention。
- 目前业界的做法通常是混合架构(Hybrid):比如 3 层 Gated DeltaNet 搭配 1 层标准 Attention(Qwen3-Next 模式),既要线性的推理速度和恒定缓存,又要全注意力的精度。
Normalization
-
LayerNorm: 对某个样本的所有特征维度进行归一化
-
RMSNorm: 简化版的 LayerNorm,它不减去均值,只基于平方均值 (Root Mean Square) 来归一化
Why RMSNorm?
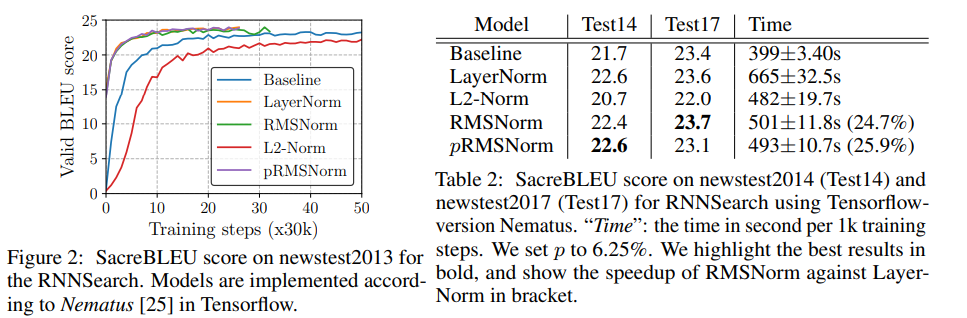
- Layer-Norm 和 RMS-Norm 在测试集效果上没有明显差异,基本持平
- RMS-Norm 的计算效率要更高
Feed Forward Network
Dense FFN
-
MLP: 两层全连接网络,中间使用非线性激活函数(如 ReLU 或 SiLU)
-
SwiGLU: 使用 SiLU 激活函数的变体并增加门控机制
Mixture of Experts (MoE)
-
Mixture of Experts (MoE): 多个专家网络的集合,每个输入样本通过一个路由器选择部分专家进行处理,从而提高模型的表达能力
- Switch Transformer:Top-1 gating,每个 token 只去 1 个专家。
- GShard / GLaM:Top-2 gating,每个 token 走 2 个专家,结果加权。
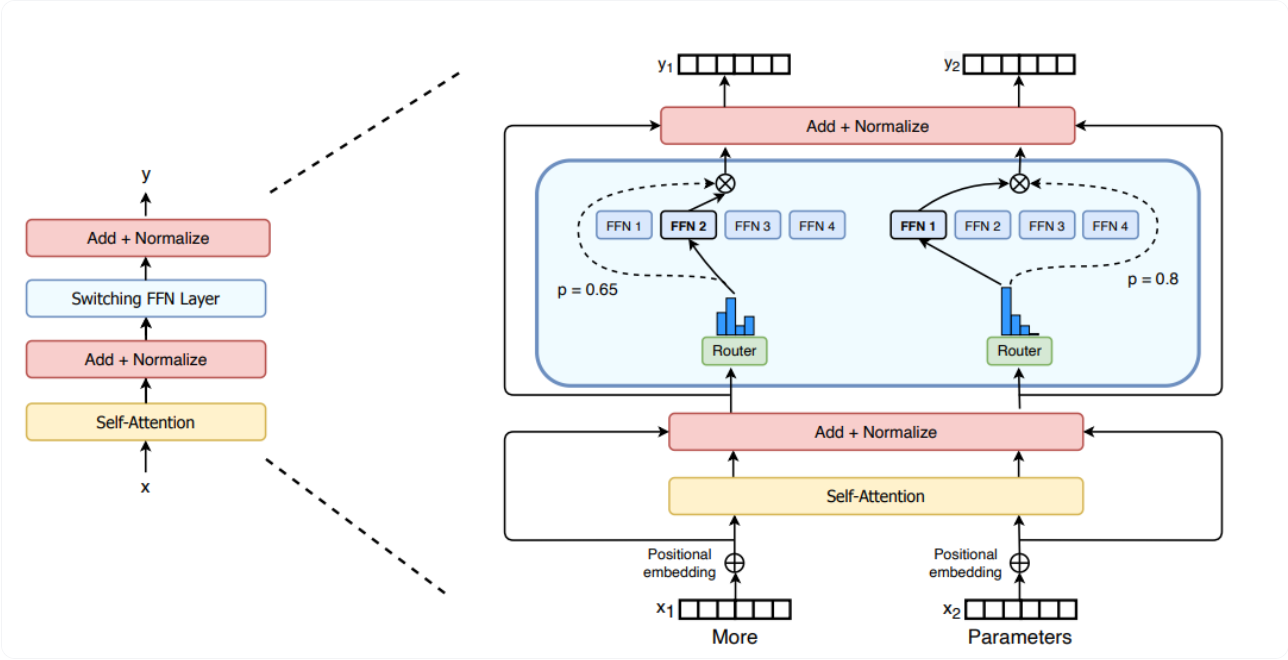
Why we need MoE?
Dense FFN 的计算量随着模型规模的增大而迅速增加,MoE 通过引入多个专家网络,并让每个输入样本只激活其中的一部分专家,从而在保持模型表达能力的同时,大幅降低了计算资源的消耗。
MoE 的参数量巨大,但实际 activation 只用到一小部分专家
MoE 优势
- 将参数数量与参数激活量解耦
- 参数效率极高:Dense 70B ≈ MoE 600B(激活 40B)
- 推理成本可控:
- 每 token 只算 K 个 expert
- 理论 FLOPs 接近中型 Dense 模型
- 每个专家可以学到不同的知识领域,模型的整体能力提升
MoE 挑战
原本很规整的 dense 计算,变成了:
-
动态路由
-
不规则 token 分布
-
跨设备数据交换
-
很多小而不均匀的专家 batch
-
额外的 gather/scatter / permutation / combine
hidden states
  → router logits
  → top-k select
  → token 按 expert 分桶 / 排序 / 重排
  → 跨卡发给对应 expert(all-to-all)
  → 每个 expert 做 MLP
  → 结果再跨卡收回(all-to-all)
  → 恢复原 token 顺序
  → combine / weighted sum
训练挑战
-
路由不均衡,部分专家过载,其他专家不能学到知识
- 如果使用辅助损失(auxiliary loss) 来鼓励负载均衡,辅助损失过大会损害模型性能。
-
Token-Dropping,每个 expert 在一次 forward 中能处理的 token 数是有限的:
太多 token 同时路由到同一个 expert 时,就会发生丢 token。IMPORTANT
路由不均 + 容量有限共同造成了 token-dropping 现象
-
稀疏激活带来的优化困难
- 每个 GPU 的负载不同容易形成很多小矩阵乘,很难保持高 occupancy 和高 cache 命中
-
通信开销大,需要两次 all2all 通信
tokens ↓ routing scatter to experts (all-to-all) ↓ expert compute gather back (all-to-all)-
大规模集群中,需要将通信开销与计算开销 overlap

-
推理挑战
-
routing 导致的动态不规则 workload
- 负载倾斜:有些 GPU 上热门专家非常忙,其他 GPU 空闲。
- 小批量 GEMM:很多 expert 只拿到很少 token,导致 MLP GEMM 变成瘦高矩阵或超小 batch,Tensor Core 利用率差。
- 动态 shape:每一步每层每个 expert 的 token 数都变,难以做静态最优调度,也不利于 CUDA Graph 这类静态捕获。
-
token permutation / unpermutation 开销大
- 很多非连续访存,是 memory-bound
-
专家热点与真实流量分布不一致
推理优化
-
并行策略:
- DP:数据并行,不同副本处理不同请求
- TP:张量并行,同一个大矩阵切开
- EP:专家并行,不同 expert 放在不同 GPU
-
Grouped GEMM + permutation kernel:
- 将多个 expert MLP 小矩阵乘合并成一个大矩阵乘,提升 Tensor Core 利用率
- 用 专门的 permutation kernel 降低重排开销
- 尽量把 permutation 和 grouped GEMM 更紧地接起来
-
all-to-all & compute overlap:
- dispatch/combine 主要是数据搬运,expert MLP 是算数密集,两者资源侧重点不同,所以理论上可以流水并发
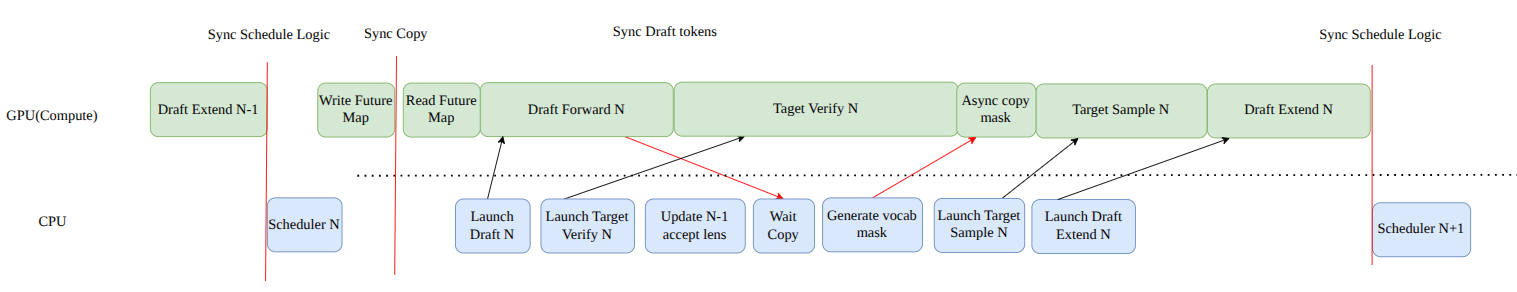
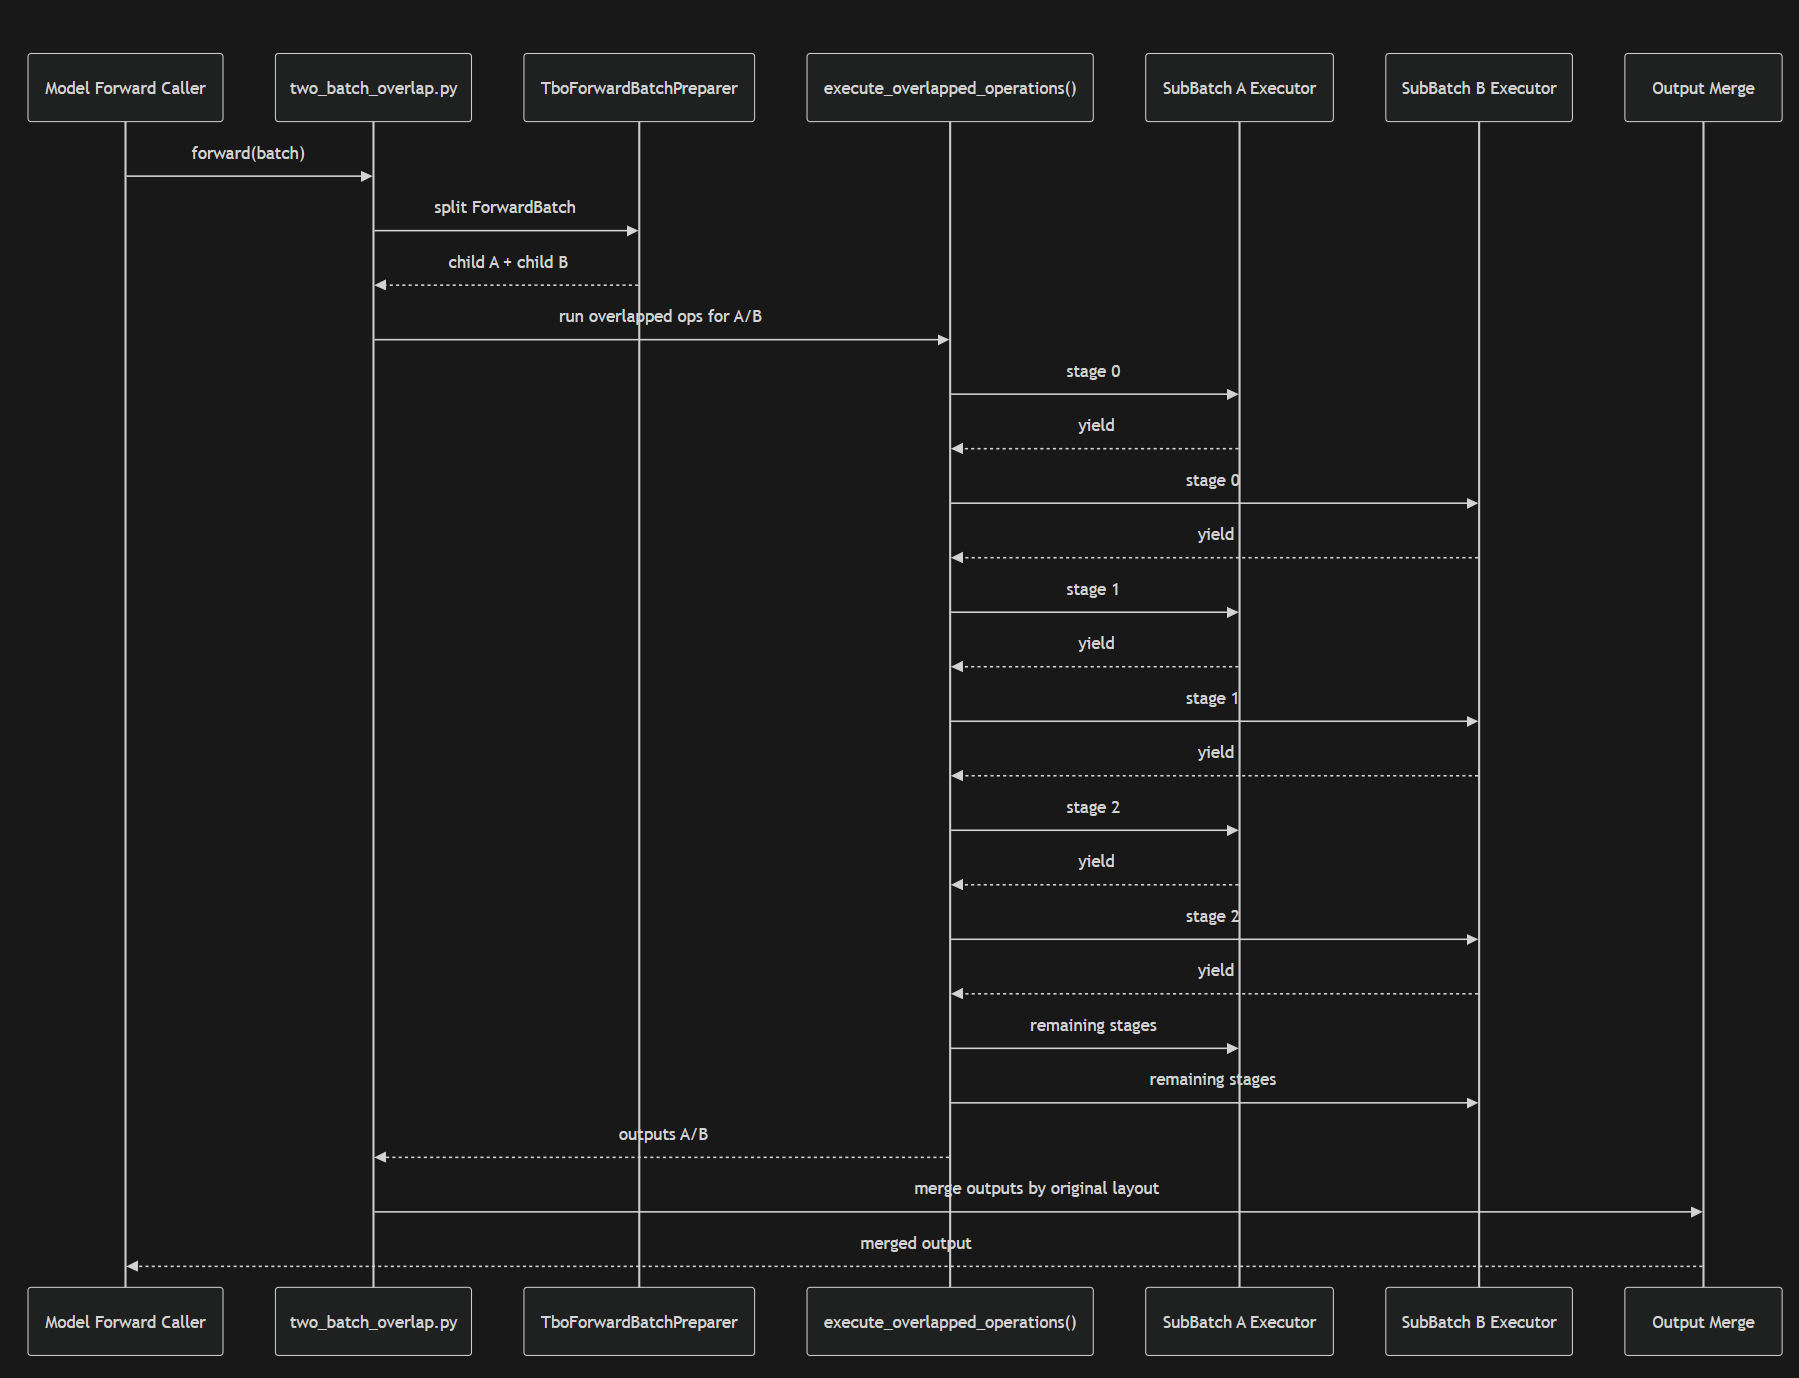
- TBO(two-batch-overlap):把一个大 ForwardBatch 拆成两个可以交错执行的子 batch,然后在单层 forward 内部,按预定义阶段显式穿插执行。
- decode/verify:两个batch对半分 sequence,交错执行
- prefill/extend:按 extend token 总量均衡切分
- 在定义好的 operation 上交错执行
Stage 0 = attn prepare
Stage 1 = attn core + gate/select_experts
Stage 2 = dispatch_a + shared_expert
Stage 3 = dispatch_b + experts + combine_a
Stage 4 = combine_b
Stage 5 = output
-
EPLB(在线负载均衡):
- 服务时 expert rebalance:
- 统计最近若干 step 各 expert 的 token 数
- 调整 expert 到 EP rank 的映射
- 把热门专家复制到更多 rank 上
- 让 routing 更容易命中本地或较空闲的 rank
- SGLang 做法
- 重要对象:
EPLBManager:负责周期触发、算新布局、切 chunk,并在 chunk 之间 yield。ExpertLocationMetadata:维护逻辑布局表,描述每个 physical slot 当前代表哪个 logical expert。ExpertLocationUpdater:负责把真实 expert 权重切片复制到对应 GPU 槽位。- 基于 expert 热度统计做周期性重平衡:统计的是每个 expert 被多少 token 命中
- 分层 placement:会优先把某个 rank 的 logical expert 映射最近的 replica:同 GPU 优先,其次同节点,最后随机补齐,再把物理 expert 权重分发到 GPU。
- —eplb-rebalance-layers-per-chunk,由全模型一次迁移变成每次只迁一部分 layer
- 重平衡是在model_runner.forward() 后调用on_forward_pass_end() 推进 Generator 入口,然后再进入 rebalance()、update_expert_location() 等流程
- 新布局先整体算出来
- 先 yield,等下一个 forward 结束,再执行这一个 chunk 的 update_expert_location()
- 常规情况下:先把真实权重搬到目标 physical slot,再把逻辑映射切过去
- 权重复制:updater 会找到需要复制的 logical_expert_id 当前实际在哪些源槽位/源 rank 上有权重。然后把对应参数切片复制到本地目标槽位
- 服务时 expert rebalance:
-
使用 CUDA Graph,基于预设的 cuda-graph-max-bs 来捕获图
LLAMA2 模型结构
-
相较于 Transformer,llama2 使用了 pre-norm 结构
-
使用 RMSNorm 替代 LayerNorm,不计算样本均值
-
使用 Rotary Positional Encoding (RoPE),用绝对编码的方式来实现相对位置编码
-
使用 GQA (Grouped-Query Attention),平衡效率和性能
-
使用 SwiGLU 替代简单的 MLP,激活函数使用 SiLU
IMPORTANT
一般 embedding 和最后模型输出前的 LMHead 层会共享权重

推理时的计算量和显存占用
FLOPs
在推理时,只有前向传播,没有反向传播。
-
经验公式(Rule of Thumb)
对于任何 Transformer 模型,生成一个 Token 的浮点运算次数(FLOPs)约为:
- 其中 是模型参数数量。
-
两个阶段的具体计算假设模型参数量为 (例如 7B 模型,),输入 Prompt 长度为 ,生成长度为 。
- Prefill 阶段 (处理 Prompt)一次性并行处理 个 token。
- 总 FLOPs
- 特点:Compute-bound(计算密集型)。GPU 利用率通常很高,像是在做矩阵乘法。
- Decode 阶段 (逐个生成)每步生成 1 个 token,共生成 次。
- 单步 FLOPs
- Attention Cost:随着序列变长, 的计算量是线性的 。但在常见的上下文长度(如 < 8k)下,相对于巨大的参数量 ,Attention 的计算量通常可以忽略不计。
- 特点:Memory-bound(访存密集型)。这是推理慢的核心原因——虽然计算量只有 ,但每算一个 token 都要把几十 GB 的模型权重从显存搬到计算单元,显存带宽(Bandwidth)成为了瓶颈。
- Prefill 阶段 (处理 Prompt)一次性并行处理 个 token。
显存占用
显存占用主要由三部分组成:模型权重 (Weights)、KV Cache、激活值 (Activation)。
- 模型权重 (Model Weights)
- 公式:
- 示例 (7B 模型):FP16 (2 Bytes):
- KV Cache —— 随着序列长度(Context Length)和 Batch Size 的增加,KV Cache 会迅速膨胀,甚至超过模型权重。
- 公式 (MHA):
- GQA: 将 变为 (例如 32头变 8头),KV Cache 减少 4 倍。
- MLA: 将 压缩为极小的 Latent 维度 ,KV Cache 极度压缩
- 激活值 (Activations)
- 这是前向传播时的中间结果(每一层的输出)。在推理时,我们不需要存反向传播的梯度,用完即丢。
- 占用相对较小,主要取决于
场景分析
- 场景 A:个人用户 / 边缘端推理 (Batch=1, 长度 < 4k)
- 模型权重以 LLaMA-7B (FP16) 为例:权重:~14 GB
- KV Cache (4k长度):
- 此时优化 KV Cache 意义不大,量化权重(INT4)才是关键。
- 场景 B:企业级服务 / 长文本推理 (Batch=64, 长度=32k)
- 以 LLaMA-7B (FP16) 为例:权重:~14 GB (固定不变)
- KV Cache:
KV Cache 远超模型权重
- 这就是为什么 DeepSeek (MLA) 和 LLaMA-3 (GQA) 如此重要的原因——如果不压缩 KV Cache,显存会在长窗口、高并发下瞬间爆满,导致 OOM (Out of Memory)。
总结
| 指标 | Prefill 阶段 | Decode 阶段 |
|---|---|---|
| 计算量 (FLOPs) | 巨大: | 较小: |
| 瓶颈 | 算力瓶颈(GPU Compute) | 带宽瓶颈(Memory Bandwidth) |
| 显存大头(短序列) | 模型权重 | 模型权重 |
| 显存大头(长序列 / 高并发) | KV Cache | KV Cache |
参考资料
- 结构篇| 浅析 LLaMA 网络架构
- 苏剑林. (Mar. 23, 2021). 《Transformer 升级之路:2、博采众长的旋转式位置编码 》[Blog post]. Retrieved from https://kexue.fm/archives/8265
- 苏剑林. (May. 13, 2024). 《缓存与效果的极限拉扯:从 MHA、MQA、GQA 到 MLA 》[Blog post]. Retrieved from https://spaces.ac.cn/archives/10091
- DeepSeek-V2: A Strong, Economical, and Efficient
Mixture-of-Experts Language Model - Root Mean Square Layer Normalization
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity