刘芷溢
最近更新
FlashAttention v1-v4:从 IO 感知到异步流水与硬件协同
沿着 FlashAttention v1-v4 的论文、作者博客与源码,拆解 Ampere、Hopper、Blackwell 如何改变 attention 的数据路径、线程分工和瓶颈,并用调度图解释 copy、MMA、softmax 与输出校正如何真正重叠。
理解 H100:从硬件数据路径到 Nsight Compute 瓶颈分析
沿着 kernel 的分配、指令发射、访存与异步矩阵计算,建立 H100 的硬件工作模型,并把 Nsight Compute 的吞吐、调度、事务和依赖指标组织成可验证的瓶颈诊断方法。
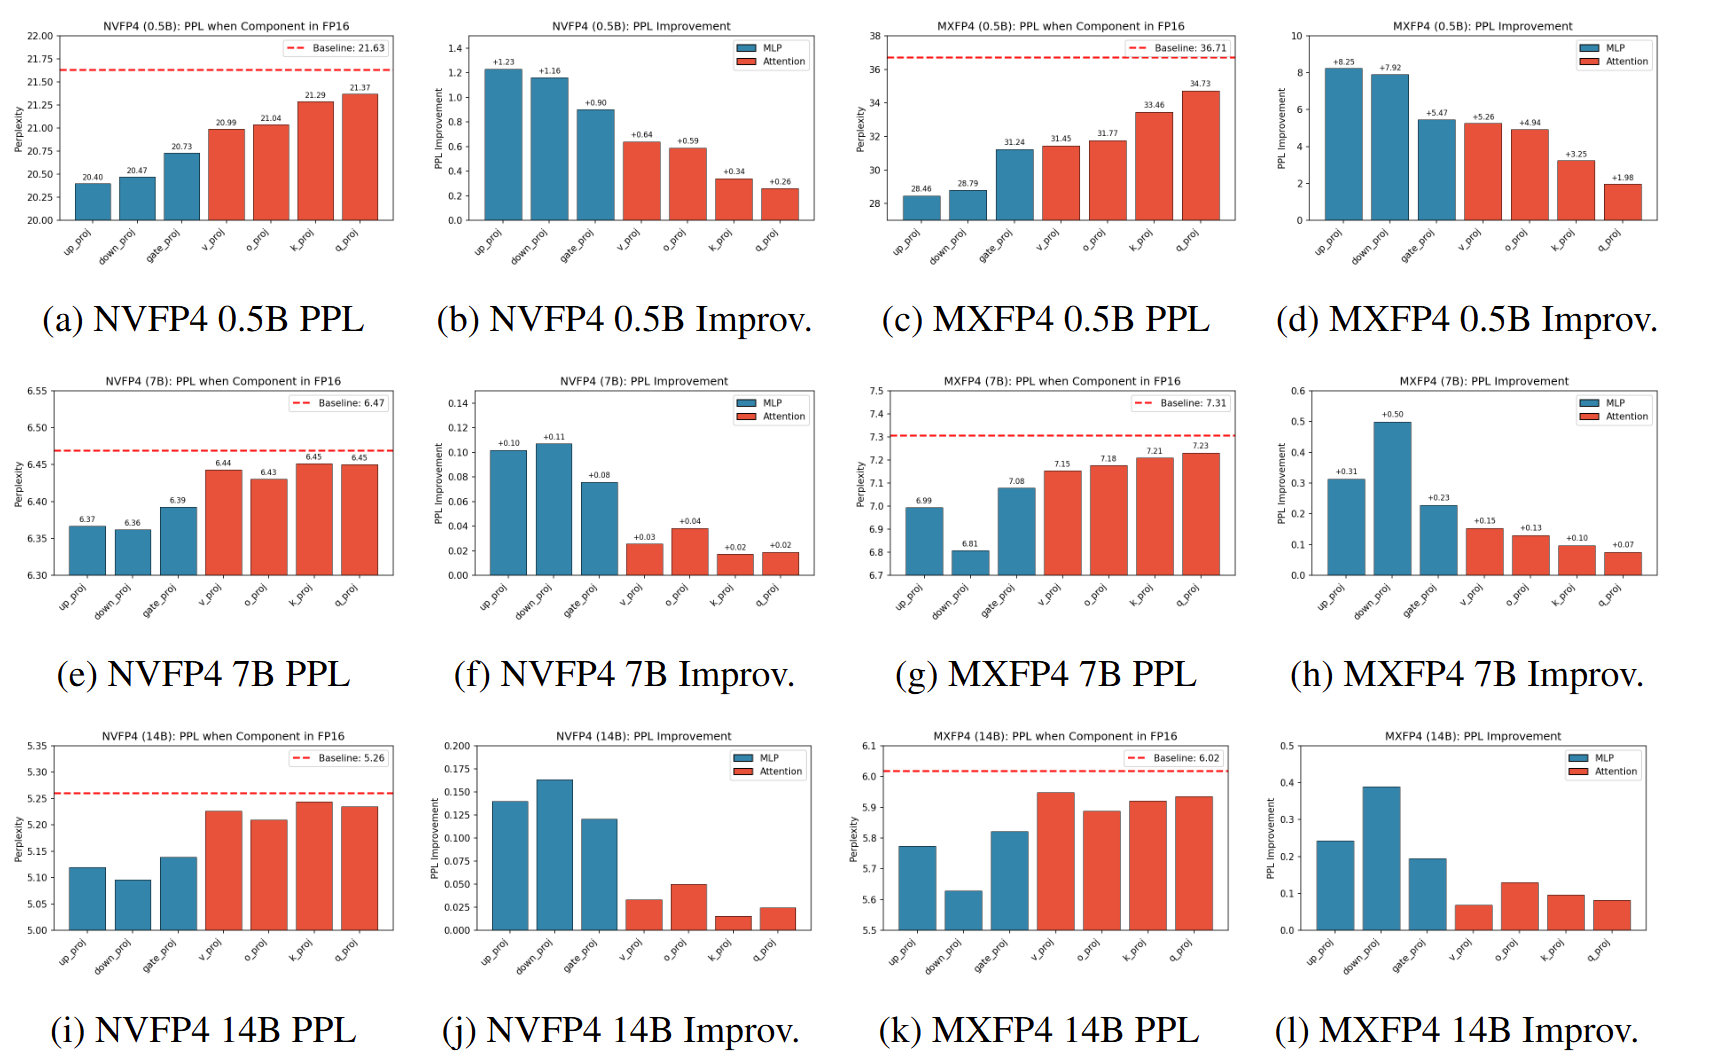
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization 论文笔记
以格式、量化算法和 GPU Kernel 的跨层约束为主线,拆解 ICLR 2026 论文 Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization,解释旋转为何改善 MXFP4 却可能伤害 NVFP4、MR-GPTQ 如何修正这一矛盾,以及 QuTLASS 的真实收益与部署边界。
FP4、FP8 与 INT8/INT4:数值范围、块缩放与推理计算精度
从标量编码、共享 scale 与有效位宽出发,拆解 INT8、FP8、MXFP8、INT4、MXFP4、NVFP4 的表示范围,并沿 GEMM、GQA/MLA Attention 数据流解释 8 bit/4 bit 推理真正使用的乘法、累加、Softmax 与输出精度。
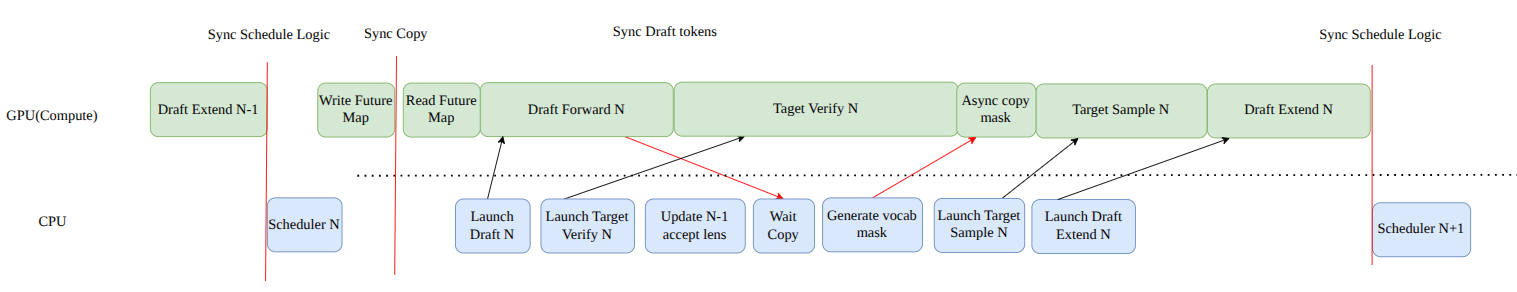
从 EAGLE 到 DFlash 2:SGLang 与 SpecForge 的投机解码训练和推理
沿 EAGLE、EAGLE-2、EAGLE-3、DFlash、DSpark 和 DFlash 2 的演进,解释 draft 的训练目标、数据对齐、推理状态与验证预算,并对照 SpecForge 训练和 SGLang serving 源码串起完整流程。
README
CuTe FlashAttention-2 case-study benchmark This directory preserves the exact teaching kernel, benchmark harness, raw results, and figure generator used by the corresponding tom-jerr blog post.
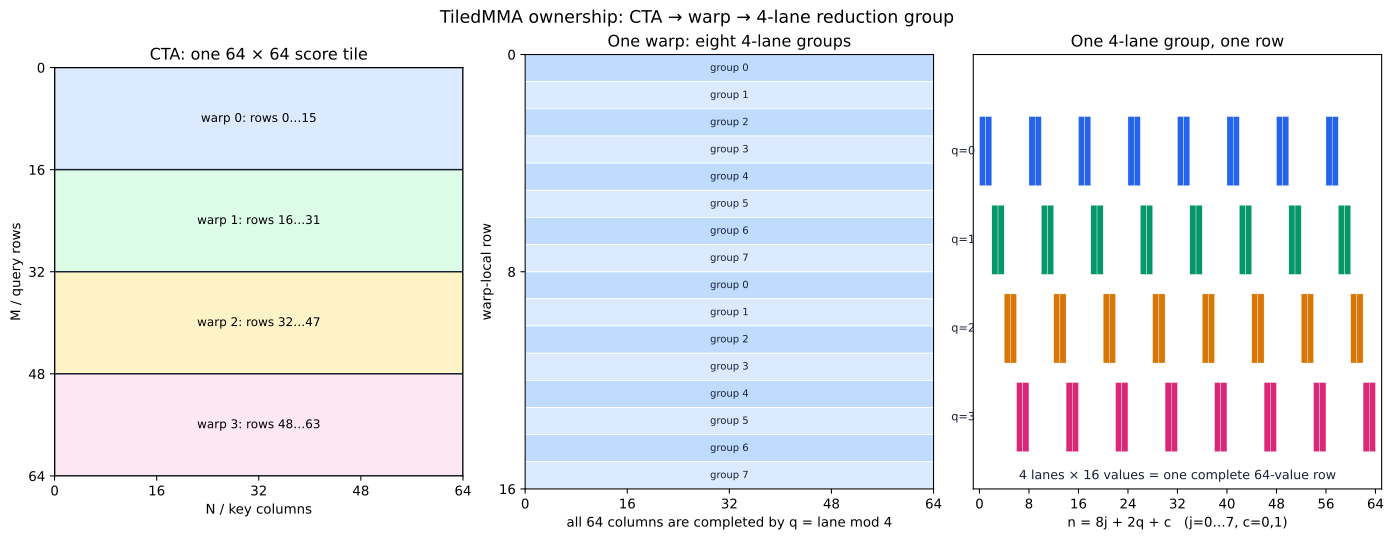
CuTe 详解:以 FlashAttention-2 拆解 Layout、TiledCopy 与 TiledMMA
以一份可运行的 FlashAttention-2 前向 Kernel 为贯穿案例,从坐标函数和线程所有权出发,详解 CuTe 的 Layout algebra、Tensor、TiledCopy、TiledMMA、寄存器重解释与流水线,并用正确性和性能实验检查这些抽象最终生成了什么。
LLM 量化综述:数据格式、PTQ 与 QAT 的算法演进
从 INT8、FP8、INT4、MXFP4、NVFP4 的表示范围与舍入误差出发,按 8 bit、4 bit 和低于 4 bit 梳理 PTQ/QAT,解释各方法解决的问题、相对前作的创新、核心优化与数值稳定性,并对应到 llm-compressor 的工程实现。

llm_inference
20 篇文章
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization 论文笔记
以格式、量化算法和 GPU Kernel 的跨层约束为主线,拆解 ICLR 2026 论文 Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization,解释旋转为何改善 MXFP4 却可能伤害 NVFP4、MR-GPTQ 如何修正这一矛盾,以及 QuTLASS 的真实收益与部署边界。
FP4、FP8 与 INT8/INT4:数值范围、块缩放与推理计算精度
从标量编码、共享 scale 与有效位宽出发,拆解 INT8、FP8、MXFP8、INT4、MXFP4、NVFP4 的表示范围,并沿 GEMM、GQA/MLA Attention 数据流解释 8 bit/4 bit 推理真正使用的乘法、累加、Softmax 与输出精度。
LLM 量化综述:数据格式、PTQ 与 QAT 的算法演进
从 INT8、FP8、INT4、MXFP4、NVFP4 的表示范围与舍入误差出发,按 8 bit、4 bit 和低于 4 bit 梳理 PTQ/QAT,解释各方法解决的问题、相对前作的创新、核心优化与数值稳定性,并对应到 llm-compressor 的工程实现。
deepep_architecture_notes
DeepEP 架构与实现笔记 本文整理 DeepEP 相关官方文档与源码,重点解释 V2 ElasticBuffer 架构,同时把 V1 legacy 的 NVSHMEM/IBGDA 路径作为对照。源码基于官方仓库 deepseek-ai/DeepEP 的 main 分支临时克隆版本,提交为 d4f41e4e93602a15e95f55f6ee8df8f1aaa0e4bb。 主要参考: DeepEP README DeepEP V1 legacy docs NVSHMEM install guide V1 Python legacy Buffer V1 C++ legacy runtime V...
deepseek
Deepseek Details MoE node-limited routing 每个 token 最多只发到有限个 node,这些 node 根据该 node 上专家的高 affinity 分数之和来选。目的非常直接,就是把跨节点 all-to-all 压下来,给 DualPipe + overlap 创造条件,最终接近计算通信重叠。再配合: 每 step 依据 batch 负载更新 expert bias,而不是靠大 aux loss 硬拉均衡。 再补一个很小的 sequence-wise aux loss,防单条序列极端失衡。 所以训练和推理都可以做到 no token droppin...
llm-compressor框架解析
LLM Compressor 量化原理、架构与算法执行流程 本文整理 llm-compressor 的量化体系:它如何把不同 PTQ / GPTQ / AWQ / SmoothQuant / AutoRound / FP8 / FP4 / KV cache quant 算法封装成 Modifier,如何通过 event 和 hook 在校准前向中收集统计量,如何逐层压缩模型,最后如何保存成 vLLM 可加载的 compressed-tensors checkpoint。 整体阅读顺序: 先理解量化的基础公式和粒度。 再看 llm-compressor 的整体架构、pipeline、event ...
longcontext
Long Context Attention 长上下文注意力(Long Context Attention)是指在处理长序列数据时,如何高效地计算注意力机制的一种方法。传统的注意力机制在处理长序列时会面临计算和内存的挑战,因为它需要计算所有位置之间的关系,导致计算复杂度为O(n^2)。为了克服这个问题,研究人员提出了多种优化策略,如Ring Attention和Striped Attention,以及后续的 Tree Attention等方法。 Motivation “挑战:我们耗尽了内存” 引用自Ring Attention(2023年,Hao Liu等人的研究): “对于一个隐藏层大小为1...
optimization_tech
CUDA Graph 原理 CUDA Graph 将一段 GPU kernel 序列录制为静态 DAG,之后只需一次 CPU launch 即可重放整个计算流,以此消除逐个 kernel launch 的 CPU 开销。在此基础上,我们更进一步理解 CUDA Graph 的一些核心机制。 构造过程 Capture:捕获或者是录制 CUDA Graph。 调用 cudaStreamBeginCapture() 后,CUDA runtime 进入录制模式——后续所有提交到该 stream 的操作(kernel launch、memcpy、memset 等)都不会真正执行,而是被记录为 DAG 中的...
pip&uv
Pip & uv 使用 Pip 基础使用 pip install xxx 从 PyPI 下载合适的版本(一般是最新,如果没有 requirement) 优先使用 wheel 构建,如果没有本地编译 pip 会创建一个临时隔离环境 只安装 pyproject.toml 里声明的 build-system.requires 当前环境的 torch / numpy / cuda 都不可见 Pip 相关选项 —no-build-isolation:构建时直接用当前环境里的包 —no-use-pep517:不用 PEP 517 新构建系统,走 setup.py install —no-deps:...
python项目构建
Python 项目构建 现代 Python 项目基本围绕 PEP 517/518/621: PEP 518:构建工具写在哪里?构建前要先装什么? PEP 517:pip / uv 应该如何“调用构建后端”? PEP 621:项目元数据应该如何标准化地写? 常见 python project 构建配置文件 pyproject.toml:项目元数据 + 构建配置的统一入口 build backend(构建后端):真正构建项目二进制包的实现(setuptools / hatchling / flit / poetry-core…) build frontend(构建前端):调用后端去构建 wheel...
Model Forward 瓶颈以及优化方法
Model Forward 瓶颈以及优化方法
Speculative Decoding
Speculative Decoding Draft 负责便宜地提一个多步候选树 Verify Target Model 在每一轮验证时的逻辑输入由两部分构成: 已验证的前缀 (Verified Prefix): 即截至上一轮已确认正确的 Token 序列,记为 x_{<n}。这部分通常已经存在于 KV Cache 中。 本轮候选 Token / Tree (Draft Proposals): 由 Draft Model 生成的 k 个候选 Token \{x_n, x_{n+1}, \dots, x_{n+k}\},或者是树状结构的候选节点。 对于 Draft Model 提出的线性序...
Quantization in LLM Inference
Quantization in LLM Inference 对称量化:认为数值分布大致以 0 为中心 量化:q = round(\frac{x}{s}) 反量化:\hat{x} = q \cdot s 其中 s 是 scale,表示量化单位的大小,通常根据数值范围和量化位数 b 计算得到: s = \frac{\alpha}{2^b - 1} \alpha 是数值范围的绝对值上界,例如 \alpha = \max(|x_{min}|, |x_{max}|) 非对称量化:允许数值分布不以 0 为中心,因此需要额外的偏移量(zero-point)来表示 0 的位置 量化:q = round(\fr...
Attention & Transformers
首先从概率论角度介绍语言生成模型最终训练目标然后介绍注意力机制(Attention)及其在 Transformer 架构中的应用,并详细解析 Transformer 的结构和工作流程。
FlashAttention 原理 v1-v3
本文详细介绍 FlashAttention 的原理及其 v1-v3 版本的改进点,涵盖 Online Softmax、分块计算以及并行化优化等关键技术。
Parallelization in LLM Inference
本文介绍了在基于 Transformer 的大规模语言模型(LLM)中常用的并行化技术,包括数据并行(DP)、张量并行(TP)、流水线并行(PP)、专家并行(EP)以及序列并行(SP)和上下文并行(CP)。通过 deepseek-V3 来进行具体分析这些并行化技术在训练和推理中的应用。
Parallelization Concepts
本节主要介绍大模型训练中的并行化技术,涵盖数据并行、模型并行、流水线并行和张量并行等方法。我们将从 Transformer 的参数量、Flops 以及训练占用显存入手,分析为什么需要并行化技术,并介绍这些技术的基本原理。
Page Attention
本文深入探讨 Page Attention 的实现细节,涵盖 GPU Tiling、矢量化访问、分层计算结构以及注意力内核的具体实现过程,帮助读者理解其高效计算注意力机制的原理。
Introduction
本文介绍了不同神经网络架构(如 MLP、CNN、RNN 和 Transformer)对计算模式的影响,探讨了这些模式如何映射到计算机系统资源,包括内存访问模式、计算特性、数据移动和资源利用。
Transformer-based LLM
本章介绍基于 Transformer 架构的大规模语言模型(LLM),涵盖其核心组件如位置编码、注意力机制、归一化方法和前馈网络。