
Model Forward 瓶颈分析以及优化方法
这里以 MHA 为例,输入 X 大小为 [B, S, D],其中 B 是 batch size,S 是序列长度,D 是隐藏层维度。
- 每一层是一个 Transformer Block,包含一个 MHA 和一个 FFN,中间还有 Norm 和残差连接。
MHA 的计算过程如下:
- QKV: Wq, Wk, Wv 分别是大小为 [D, D] 的权重矩阵,计算 Q = X * Wq, K = X * Wk, V = X * Wv,得到 Q, K, V 大小为 [B, S, D] -> [B, S, H, D_h] -> [B, H, S, D_h]
- Attention Scores: 计算 Attention Scores = Q * K^T / sqrt(D),得到大小为 [B, H, S, S]。
- softmax: 对 Attention Scores 进行 softmax,得到 Attention Weights 大小为 [B, H, S, S]。
- score * V: 计算 Output = Attention Weights * V,得到大小为 [B, H, S, D_h] -> [B, S, D]。
- 输出 Output 大小为 [B, S, D]。
FFN 的计算过程如下:
- Linear1: W1 大小为 [D, D_ffn],计算 Output1 = X * W1,得到大小为 [B, S, D_ffn]。
- Activation: 对 Output1 进行激活函数(如 ReLU),得到大小为 [B, S, D_ffn]。
- Linear2: W2 大小为 [D_ffn, D],计算 Output2 = Output1 * W2,得到大小为 [B, S, D]。
- Linear3: W3 大小为 [D, D],计算 Output3 = X * W3,得到大小为 [B, S, D]。
- 输出 Output 大小为 [B, S, D]。
Arithmetic Intensity 分析(FP16)
Prefill 阶段
MHA
QKV 计算每个都是一个 GEMM 的算术强度为:
Attention Scores 计算的算术强度为:
- QK^T 的算术强度为:
- softmax 的算术强度为: 基本上都是 Memory-Bound,算术强度非常低。
- score * V 的算术强度为:
FFN
- Linear1 的算术强度为: 一般 D_ffn 是 D 的 4 倍。
- Activation 的算术强度为: 基本上都是 Memory-Bound,算术强度非常低。
- Linear2 的算术强度为:
- Linear3 的算术强度为:
Decode 阶段
- 此时每一个 Q 长度都为 1,K 和 V 的长度是 S(历史键值对 + 当前输入)
MHA
Attention Scores 计算的算术强度为:
- QK^T 的算术强度为:
- softmax 的算术强度为: 基本上都是 Memory-Bound,算术强度非常低。
- score * V 的算术强度为:
分析
- Prefill 阶段 S 比较大,算术强度相对较高,主瓶颈常在 GEMM 算力利用率 和 attention 中间张量 IO
- QK^T 产生 [B, H, S, S] 的中间张量,softmax 又要读写这个张量,score·V 再读一次
- Decode 阶段,每步只有一个 query token,Q 长度是 1,K/V 长度是历史长度 S,每生成一个 token 都要读整段历史 KV cache,瓶颈一般在KV cache 读取带宽以及 KV cache 的布局 / 碎片 / 页访问局部性
- FFN / projection 虽然 FLOPs 大,但因 S=1 shape 很小,常常也吃不满算力
优化方法
Batching
- 对 Prefill 阶段提升不是很大,因为 S 已经比较大了已经是 Compute-Bound 了,提升算力利用率的空间有限。
- 对 Decode 阶段提升很大,可以显著提升算力利用率,减少每个 token 的平均 latency。
GQA
- 每个 KV head 为多个 query head 服务,减少了需要维护和加载的 KV cache 的数量,降低了内存带宽压力。
- 因为共享 K head 后,一个 K tile 可以服务多个 Q heads:那么实际 HBM 读取会下降,cache locality 更好。这会提高实际有效 AI
- Decode AI,输入 [B, 1, D],输出 [B,1, D],算术强度为:
- 实际上与 H_q 和 H_k 的比值相关,
- GQA 的理论 AI 主要用来判断 decode attention 是否仍然受 KV 带宽限制,以及减小 H_k 还有没有收益。长上下文下这个 AI 近似与 H_q/H_k 成正比
- GQA 的本质价值是提升每次 K/V 读取的复用度。
- 调优:如果没有达到预期,通常从几个方向排查:
- 是否有额外 gather/scatter、transpose 或中间张量导致实际 bytes 远大于理论;
- 共享 K/V 是否真的在片上复用了,还是不同 Q heads 仍然重复从 HBM 加载;
- 为了复用而增加的寄存器和 shared memory 占用是否把 occupancy 打低了;
- paged KV 的碎片和非连续访问是否吞掉了 GQA 带来的带宽收益;
- 最后还要确认端到端瓶颈有没有转移到 sampling、通信或 CPU-GPU 同步。
Speculative Decoding
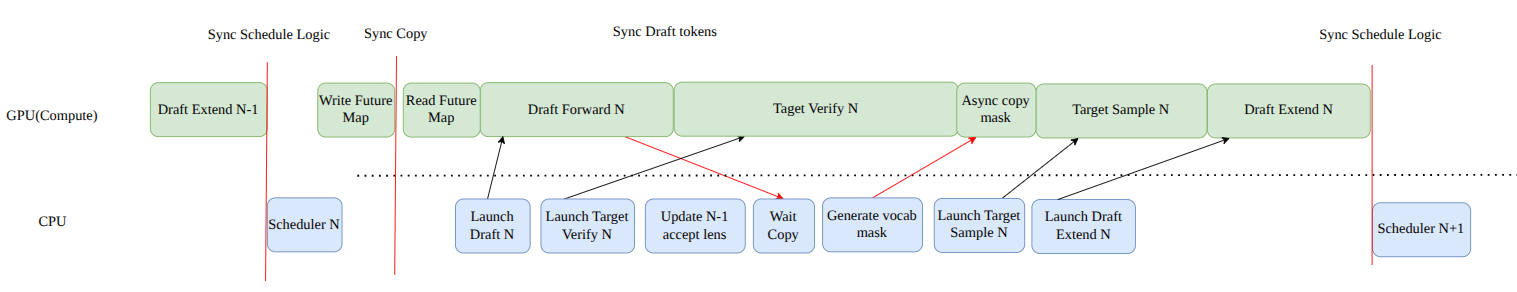
- 可以理解为同样是为了提高 decode 阶段的算力利用率,但它是通过增加并行度(同时生成多个 token,即增大 S)来提升理论 AI,同时减少 KV Cache 的重复访问提高有效 AI
Flash Attention
- 并没有提升理论 AI,但通过减少中间张量的读写来提升实际 AI。
- 通过 fuse Attention 的多个步骤(QK^T、softmax、score·V)来减少中间张量的读写,降低内存带宽需求,提高实际 AI。
- 每次加载一个 Q/K/V tile 后,直接计算对应的 Attention Scores 和 score·V 的部分结果,避免了生成完整的 [B, H, S, S] Attention Scores 张量。

- 每次加载一个 Q/K/V tile 后,直接计算对应的 Attention Scores 和 score·V 的部分结果,避免了生成完整的 [B, H, S, S] Attention Scores 张量。