刘芷溢
最近更新
FlashAttention v1-v4:从 IO 感知到异步流水与硬件协同
沿着 FlashAttention v1-v4 的论文、作者博客与源码,拆解 Ampere、Hopper、Blackwell 如何改变 attention 的数据路径、线程分工和瓶颈,并用调度图解释 copy、MMA、softmax 与输出校正如何真正重叠。
理解 H100:从硬件数据路径到 Nsight Compute 瓶颈分析
沿着 kernel 的分配、指令发射、访存与异步矩阵计算,建立 H100 的硬件工作模型,并把 Nsight Compute 的吞吐、调度、事务和依赖指标组织成可验证的瓶颈诊断方法。
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization 论文笔记
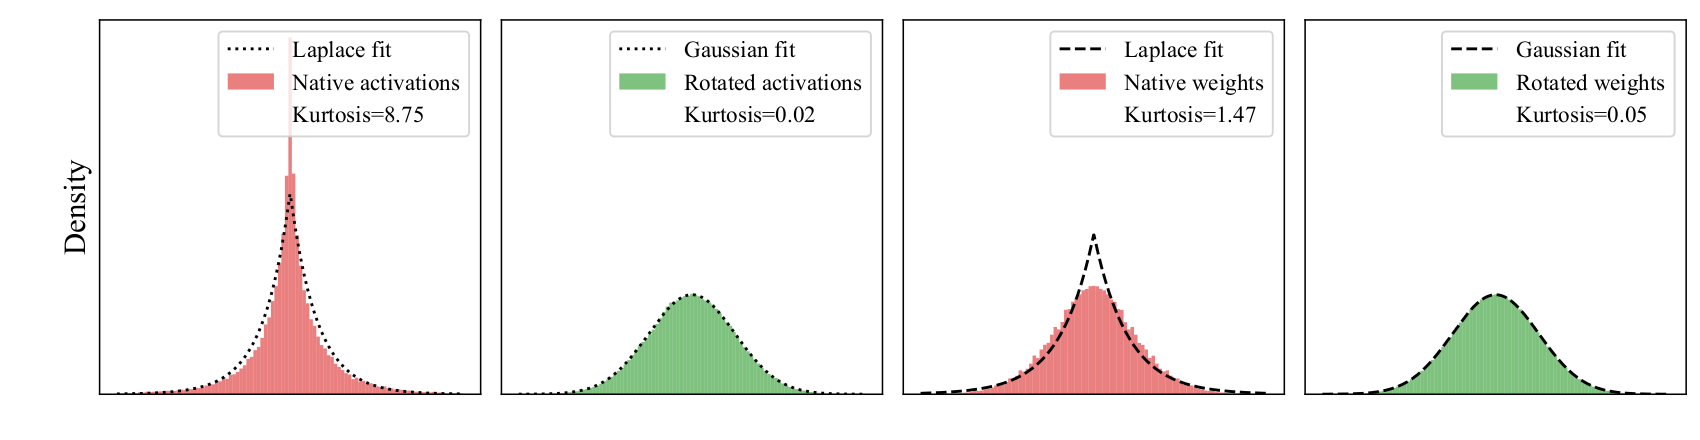
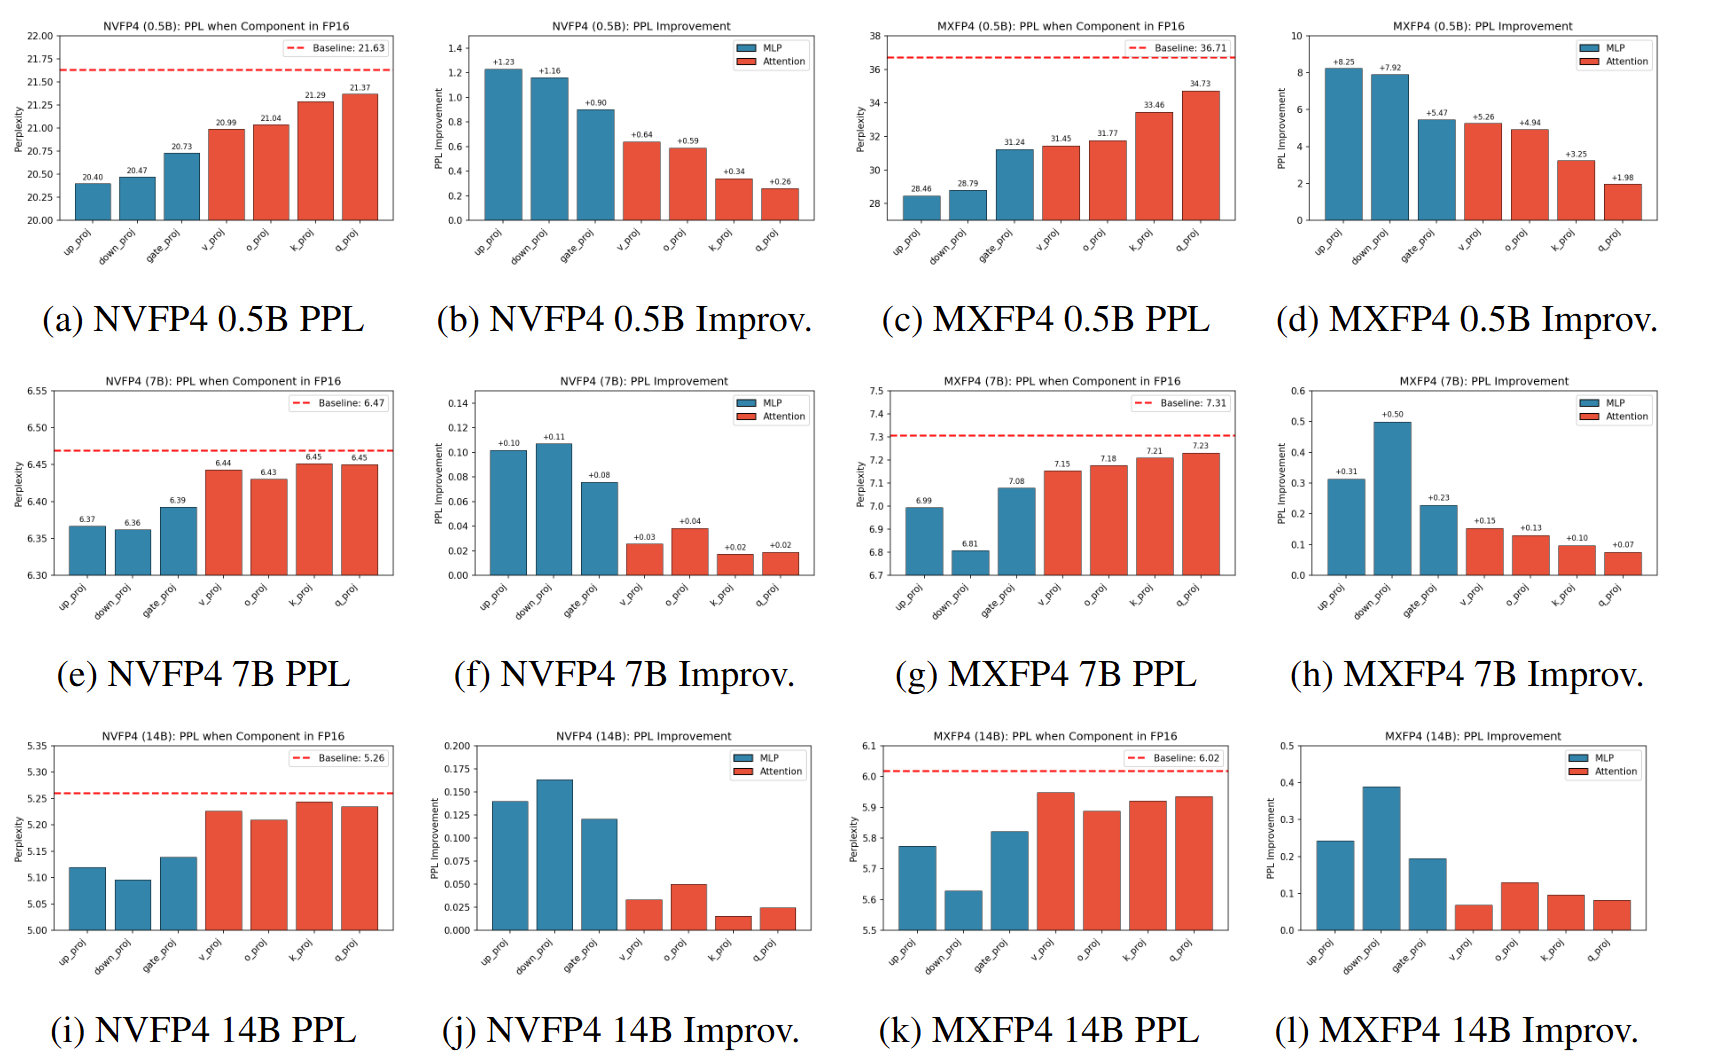
以格式、量化算法和 GPU Kernel 的跨层约束为主线,拆解 ICLR 2026 论文 Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization,解释旋转为何改善 MXFP4 却可能伤害 NVFP4、MR-GPTQ 如何修正这一矛盾,以及 QuTLASS 的真实收益与部署边界。
FP4、FP8 与 INT8/INT4:数值范围、块缩放与推理计算精度
从标量编码、共享 scale 与有效位宽出发,拆解 INT8、FP8、MXFP8、INT4、MXFP4、NVFP4 的表示范围,并沿 GEMM、GQA/MLA Attention 数据流解释 8 bit/4 bit 推理真正使用的乘法、累加、Softmax 与输出精度。
从 EAGLE 到 DFlash 2:SGLang 与 SpecForge 的投机解码训练和推理
沿 EAGLE、EAGLE-2、EAGLE-3、DFlash、DSpark 和 DFlash 2 的演进,解释 draft 的训练目标、数据对齐、推理状态与验证预算,并对照 SpecForge 训练和 SGLang serving 源码串起完整流程。
README
CuTe FlashAttention-2 case-study benchmark This directory preserves the exact teaching kernel, benchmark harness, raw results, and figure generator used by the corresponding tom-jerr blog post.
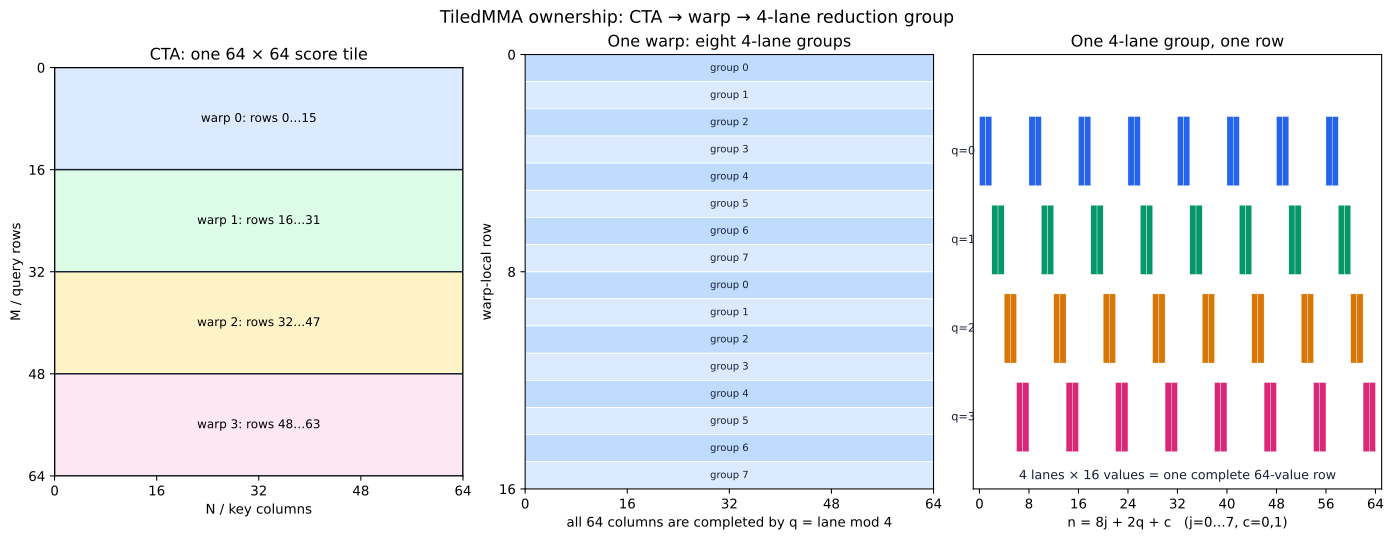
CuTe 详解:以 FlashAttention-2 拆解 Layout、TiledCopy 与 TiledMMA
以一份可运行的 FlashAttention-2 前向 Kernel 为贯穿案例,从坐标函数和线程所有权出发,详解 CuTe 的 Layout algebra、Tensor、TiledCopy、TiledMMA、寄存器重解释与流水线,并用正确性和性能实验检查这些抽象最终生成了什么。
LLM 量化综述:数据格式、PTQ 与 QAT 的算法演进
从 INT8、FP8、INT4、MXFP4、NVFP4 的表示范围与舍入误差出发,按 8 bit、4 bit 和低于 4 bit 梳理 PTQ/QAT,解释各方法解决的问题、相对前作的创新、核心优化与数值稳定性,并对应到 llm-compressor 的工程实现。

cuda
13 篇文章
FlashAttention v1-v4:从 IO 感知到异步流水与硬件协同
沿着 FlashAttention v1-v4 的论文、作者博客与源码,拆解 Ampere、Hopper、Blackwell 如何改变 attention 的数据路径、线程分工和瓶颈,并用调度图解释 copy、MMA、softmax 与输出校正如何真正重叠。
理解 H100:从硬件数据路径到 Nsight Compute 瓶颈分析
沿着 kernel 的分配、指令发射、访存与异步矩阵计算,建立 H100 的硬件工作模型,并把 Nsight Compute 的吞吐、调度、事务和依赖指标组织成可验证的瓶颈诊断方法。
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization 论文笔记
以格式、量化算法和 GPU Kernel 的跨层约束为主线,拆解 ICLR 2026 论文 Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization,解释旋转为何改善 MXFP4 却可能伤害 NVFP4、MR-GPTQ 如何修正这一矛盾,以及 QuTLASS 的真实收益与部署边界。
FP4、FP8 与 INT8/INT4:数值范围、块缩放与推理计算精度
从标量编码、共享 scale 与有效位宽出发,拆解 INT8、FP8、MXFP8、INT4、MXFP4、NVFP4 的表示范围,并沿 GEMM、GQA/MLA Attention 数据流解释 8 bit/4 bit 推理真正使用的乘法、累加、Softmax 与输出精度。
CuTe 详解:以 FlashAttention-2 拆解 Layout、TiledCopy 与 TiledMMA
以一份可运行的 FlashAttention-2 前向 Kernel 为贯穿案例,从坐标函数和线程所有权出发,详解 CuTe 的 Layout algebra、Tensor、TiledCopy、TiledMMA、寄存器重解释与流水线,并用正确性和性能实验检查这些抽象最终生成了什么。
从 Bank Conflict 到 CUTLASS Swizzle:推导 ldmatrix 的访存布局
从 shared memory 的 32 个 bank 出发,逐地址推导 ldmatrix 的行地址、寄存器分配与 bank conflict,再解释 CUTLASS 的 XOR permutation、CuTe Swizzle 参数和 producer/consumer 布局约束,附交互图与可运行验证程序。
CUDA 中的 ILP 与 MLP:从依赖链到延迟隐藏
从 warp scheduler、依赖链与 Little's Law 出发,区分 CUDA 中的指令级并行和内存级并行,并结合 GEMM、GEMV、FlashAttention、可对照的 Kernel 与 Nsight Compute 指标说明何时以及如何提升二者。
cuda basic
CUDA Basic Concept CUDA Async Copy & Pinned Memory 通常情况下,CPU 分配的内存是 Pageable(可分页) 的。操作系统为了节省物理内存,可能会把这些内存交换到磁盘上。 当你要把数据从 Pageable 内存拷贝到 GPU 时,CUDA 驱动其实做了一个幕后动作: 先在系统中申请一块临时存储区(即 Pinned Memory)。 将数据从 Pageable 内存拷贝到这块 Pinned Memory。 通过 DMA(直接内存访问) 将数据从 Pinned Memory 传给 GPU。 实际上多了一次 CPU 侧拷贝,所以性能会受到...
cuda performance checklist
CUDA Performance Checklist DRAM vs SRAM DRAM由1个晶体管和1个电容器构成;SRAM: 由6个晶体管构成 SRAM 比 DRAM 更快,但也更贵;SRAM 占用更多空间且发热更多; 实际上SRAM就对应了GPU的Shared Memory,而DRAM对应的则是Shared Memory。 Performance Checklist 合并全局内存访问(Coalesced Global Memory Access) 最大化占用率(Maximize occupancy) 理解是内存受限还是计算受限(Understand if memory or comput...
quantization cuda
Quantization CUDA 动态量化流程 (Dynamic Quantization Flow): 权重和激活都从浮点开始 权重在预处理阶段量化 激活在运行时量化 使用Int8进行乘法运算 使用Int32进行累加 最后rescale回浮点数 未量化 (Not Quantized): 权重和激活都保持浮点格式 所有运算(乘法和累加)都使用浮点数进行 仅权重量化 (Weight Only Quantization): 权重在预处理阶段量化 随后立即反量化回浮点数 激活保持浮点格式 乘法和累加都使用浮点数进行 最后有一个rescale步骤 Dynamic Quantization 数学表达:...
从 Volta/Turing、Ampere、Ada 到 Hopper:硬件、PTX 与 Kernel 编程范式演进
沿着 Volta/Turing、Ampere、Ada、Hopper 的硬件、PTX 与 kernel 编程范式,连接白皮书峰值、微基准和真实算子,分析每代架构为什么变快,以及未达理论性能时如何区分硬件边界与优化问题。
GPU 内存系统演进:最大化带宽利用与延迟隐藏的技术路径
本文探讨了 GPU 内存系统的演进路径,重点介绍了如何通过提升带宽利用率和隐藏延迟来优化 GPU 性能。涵盖了 Little's Law、ILP/DLP 并行扩展、异步内存加载以及启动延迟优化等关键技术。
CUDA Optimization for LLM Inference
在大规模语言模型(LLM)推理中,优化 CUDA 代码对于提升性能和效率至关重要。本文档介绍了一些关键的 CUDA 优化技术,帮助开发者更好地利用 GPU 资源进行 LLM 推理。


