
从 EAGLE 到 DFlash 2:SGLang 与 SpecForge 的投机解码训练和推理
投机解码看起来是一件很简单的事:让小模型先猜几个 token,大模型一次验证,接受正确前缀。但真正把它接入 serving 之后,问题会同时落到三个地方:草稿是否准确、生成草稿花多久、系统愿意为它分配多少验证资源。
EAGLE 系列最先把 target 的内部表示交给 draft,让小模型不必从 token 历史重新理解整个问题;DFlash 把重计算从逐 token 自回归改成整块并行;DSpark 和 DFlash 2 则继续处理并行预测中的块内依赖。其中,DSpark 还把验证长度变成了一个随请求质量和系统负载变化的调度决策。
这不是几个算法名字的简单替换。训练阶段允许 draft 看见哪些信息,会决定推理阶段必须维护什么状态;推理阶段如何选候选,又会决定训练到底应该优化哪一种损失。本文沿着这些接口,串起论文、SpecForge 的训练实现和 SGLang 的推理实现。
NOTE
本文在原 EAGLE2 文章上重写,保留原文的树验证、KV 管理及 grammar overlap 实验。源码固定到 2026-09-11 核对的 SGLang
822e73ccddc0和 SpecForge3d64e7a61f5f,链接均指向对应快照。DFlash 2 的方法来源是官方技术博客及公开实现;本文说明的 SpecForge recipe 是该框架的公开训练路径,不等同于作者 checkpoint 的完整内部训练配方。本文没有重新运行 GPU 训练或性能实验。
1. 先统一一轮投机解码的输入、输出与成本
1.1 已经生成 token,不代表已经计算它的 KV
设 target 已经执行了前缀 ,对应 KV 和 hidden states 都已存在,并从最后一个位置的分布中采样出 。将这个刚生成的 token 记为 anchor 。
此时系统的状态是:
已执行 target:    A B C
已生成但尚未执行:      D   ← anchor
希望 draft 预测:        E F G H

已有 target feature:h_A h_B h_C
尚无 target feature:            h_D h_E h_F ...
anchor 已确定,但 target 尚未以它为输入执行 forward。 这个一位偏移贯穿 EAGLE 的特征递推、DFlash 的训练 mask 和验证后的 KV 提交。
统一记号如下,避免把不同论文里的 、、block size 混在一起。
| 记号 | 本文含义 |
|---|---|
| 上轮 target 生成、这一轮要处理的 anchor | |
| 本轮新提出的 draft token 数,不包含 anchor | |
| 线性 target verify 的输入长度:anchor 加草稿 | |
| 实际接受的 draft 前缀长度, | |
| 平均每轮新输出 token 数,包含 correction/bonus | |
| DFlash 2 每个位置保留的候选数,与 block size 不同 |
target 验证的输入是 [a, d1, ..., dm]。因果 attention 允许一次得到所有位置的条件分布:anchor 那一行预测 d1,d1 那一行预测 d2,依此类推。第一个不匹配或被拒绝的位置使后缀作废;若所有草稿都通过,则再从最后一行采样 bonus。
因此,全部接受时是 个新输出,而不是接受 个再补一个。到达 EOS 或输出长度上限时,面向用户的输出还会被截断。
1.2 Lossless 保证来自验证协议
对随机 proposal,令 为 draft 在实际已选前缀下使用的条件分布, 为 target 在同一前缀下的分布。对 ,经典拒绝采样使用:
拒绝后从残差分布采样:
接受分支提供的概率质量是 ,拒绝分支补上 ,两者之和恰好为 。这里不要求 ;两者越接近,通常接受率越高,但不接近首先损失的是速度。原始 speculative decoding 论文给出了这一分布保持机制。
需要区分三件事:
- Greedy 验证比较 target argmax 和候选 token,在相同数值与 tie-breaking 条件下保持 greedy 输出。
- 随机采样要求记录实际 proposal 分布。经过 DSpark correction 或 DFlash 2 selector 后,不能继续把未经修改的 unary softmax 当成 。
- 分布相同不意味着同一个随机种子下逐 token 相同;并行路径对随机数的消费顺序可能不同。
另外,树采样、独立 target 采样后匹配前缀,以及标准 拒绝采样是不同实现。算法叫作 speculative decoding,并不自动证明某个设备后端和采样配置保持分布,后文会回到源码中的实际分支。
1.3 优化目标是每个有效输出的总成本
单请求稳态下,可以用下面的近似理解收益:
是 drafting, 是 target verification,另外两项包含 KV 提交、draft 状态刷新、采样和调度开销。这是把一轮成本除以有效输出数的摊销模型,不能把其中某一项默认视为零。
若无投机时每个 token 成本为 ,收益条件是:
小 batch 下,合并多个位置有机会摊薄权重读取和执行开销;高并发下,target 已经忙于服务大量请求,验证低质量后缀会与其他请求竞争容量。“一次验证与一次 decode 一样贵”只是某些区间内的近似,并非前提保证。
2. EAGLE 与 EAGLE-2:先利用 target feature,再决定树怎么长
2.1 EAGLE 的不确定性来自尚未确定的下一个 token
EAGLE 中的 feature 指 LM head 之前的高层表示。论文使用 second-to-top-layer 的说法,不能机械理解成所有框架的 hidden_states[-2];需要核对是否包含 embedding、final norm,以及 capture 发生在 decoder layer 的输入还是输出。
假设 target 对 I 预测了两个可能后续:am 与 always。单凭 ,下一位置的 feature 并不唯一,因为它取决于实际选中了哪个 token。EAGLE 因此把提前一位的 token embedding与已有 feature 一起输入草稿模型:
公式表示完整前缀上的递推关系,增量实现只计算新增位置。关键配对是 与 ,而不是 与 。EAGLE 论文及原文的示意图都围绕这一点展开。
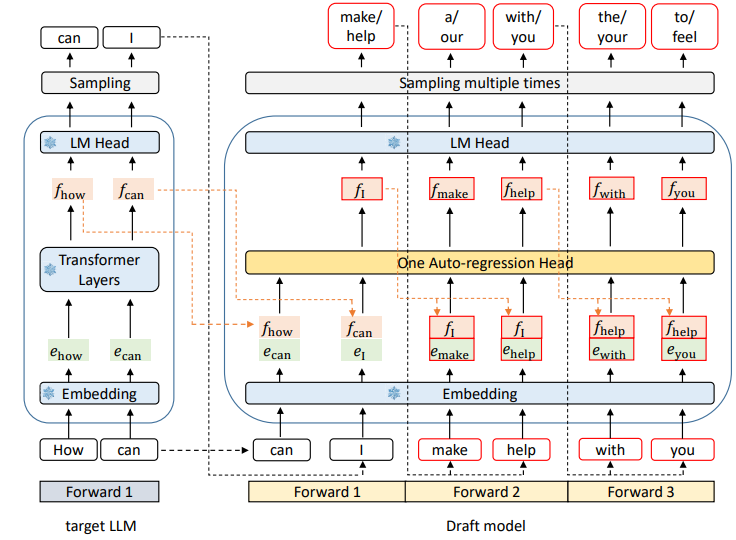
图中的 token 输入把采样结果补给 feature predictor。后续尚无真实 target feature 时,draft 继续使用自己预测的 feature,仍然沿深度自回归。
2.2 EAGLE 的训练:feature regression 与 token prediction
训练时冻结 target,用完整训练序列取得 feature 和 token 分布。草稿模型学习从前一位置 feature 加下一 token embedding,预测下一位置表示。目标可概括为:
其中 feature 项使用 Smooth L1 一类的回归损失,token 项约束经过 LM head 后的预测;具体权重属于训练配置。原始方法还对输入 feature 加噪,缓解推理时使用近似 feature 带来的偏移。
这让 draft 既要输出适合预测 token 的向量,又要接近 target 指定位置的向量。后一个要求在 EAGLE 中提供了训练稳定性和递推接口,但也成为 EAGLE-3 要重新审视的约束。
2.3 EAGLE-2 不需要一套新的训练目标
EAGLE 使用树状候选,同一深度可以有多个分支。静态树的问题在于,它不能区分当前上下文究竟适合继续加深,还是应该保留多个浅层候选。
EAGLE-2 保留原有 draft 模型,把变化放在 context-aware tree construction:用 draft confidence 近似衡量节点的价值。沿一条路径累积:
这个量是候选路径的 proposal score,不能直接等同于严格的 target 接受概率。它的用途是以低成本选择值得扩展和验证的节点。
- Expand:选择较高分的 frontier,继续调用 draft 扩展后继;同一轮可并行多个分支,但后续深度仍依赖前一轮。
- Rerank:从已生成的所有候选中选出验证预算允许的高分节点,不只选最后一层。
- 保持祖先闭包:子节点不能脱离父节点单独送去验证;概率乘积的单调性配合稳定的 tie-breaking 支持这一约束。
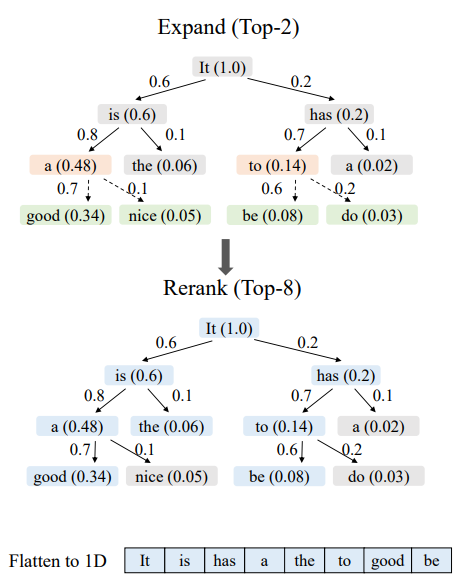
这张旧文中的扩展图表达的是生成预算与验证预算分离:draft 可以探索一些最终不会送给 target 的节点。EAGLE-2 论文改变的是这种推理期资源分配,而不是另训一种 EAGLE-2 feature predictor。
2.4 Tree attention 为什么能在一次 forward 中验证多条路径
将树压成一维 token 数组后,每个节点只能看已提交的历史、自己的祖先和自己,不能看兄弟分支;position ID 根据路径深度生成,而不是根据压平后的数组下标生成。
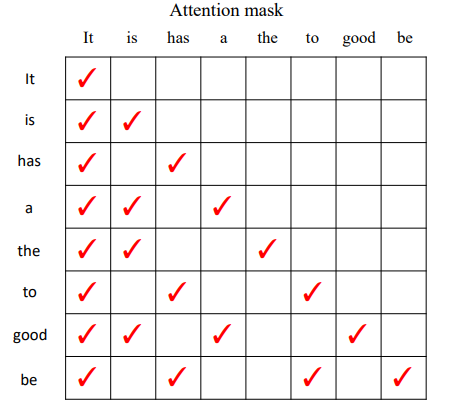
这使同一层不同节点能在一次 target forward 中计算,同时各自获得合法的自回归上下文。验证之后只保留一条路径,其余节点既不能进入输出历史,也不能成为下轮 attention 的有效 KV。
还要区分 EAGLE-2 算法版本和 SGLang EAGLEWorkerV2 的 worker 版本。后者是 serving 执行路径的名字,EAGLE-3 也会使用它;看到 V2 不能推断当前运行的是 EAGLE-2 checkpoint。
3. EAGLE-3:取消 feature 回归以后,训练必须承受自己的输出
3.1 从“逼近 target 向量”转向“让后续 token 预测正确”
EAGLE-3 去掉 feature prediction loss,让草稿内部状态 不必拟合 target 的某个指定 hidden state,同时将多个 target 层的特征融合为条件:
浅、中、深层是原始方法的选取思路,具体 layer IDs、维度和 normalization 需要以 checkpoint 为准。它们提供不同层级的信息,但“某一层只负责词法、另一层只负责语义”不是严格的架构契约。
有了 anchor 后,递推为:
这里省略历史,只展示新增位置。第二步使用 ,因为 target 尚未处理 anchor,拿不到 。EAGLE-3 论文的 inference pipeline 正是这个 self-feedback 过程。
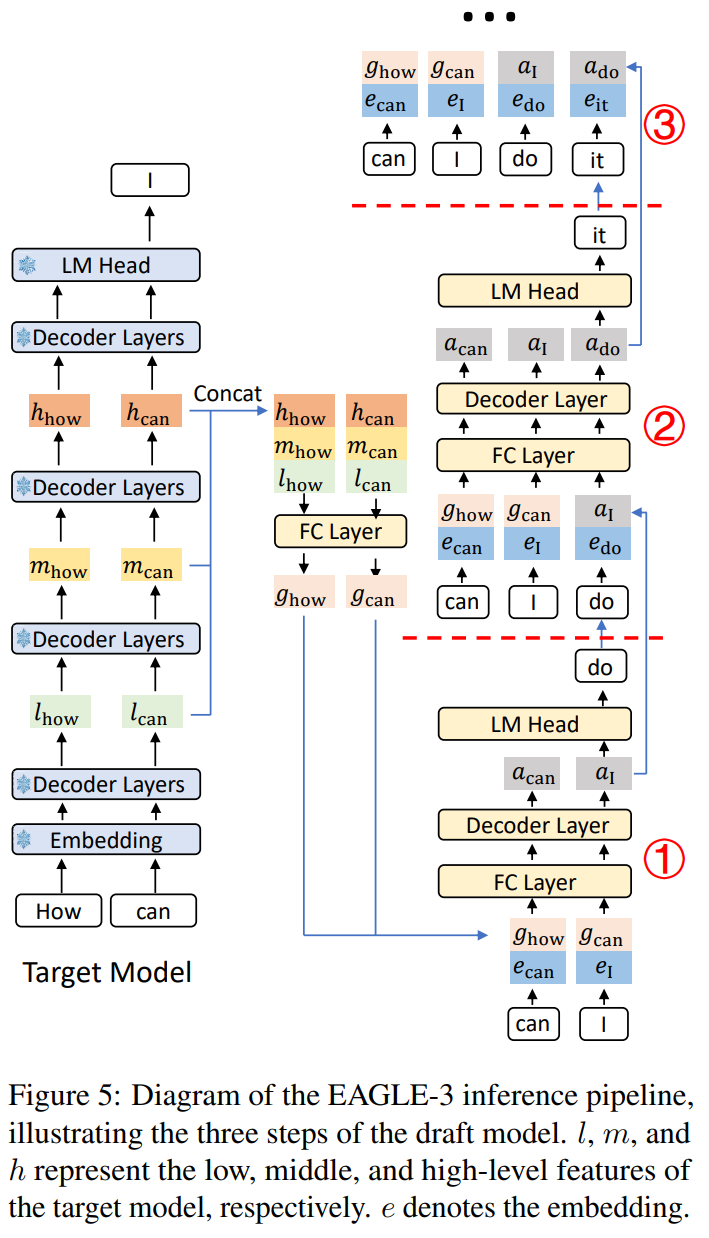
EAGLE-3 的“直接预测 token”指优化目标和内部表示约束的改变,不意味着不存在 hidden state 或 LM head。
3.2 Training-Time Test 解决的是递推状态的训练分布
如果训练时始终输入真实 ,推理时第二步却改喂 unconstrained ,训练和执行之间就出现接口偏移。去掉 feature loss 后,这个偏移甚至更明显:第一步 token 预测变好了,但输出向量未必适合作为第二步输入。
Training-Time Test,简称 TTT,要求训练中也展开多步:第一轮使用 target feature,后续轮次使用 draft 刚产生的状态,每轮继续计算 token 层的监督。
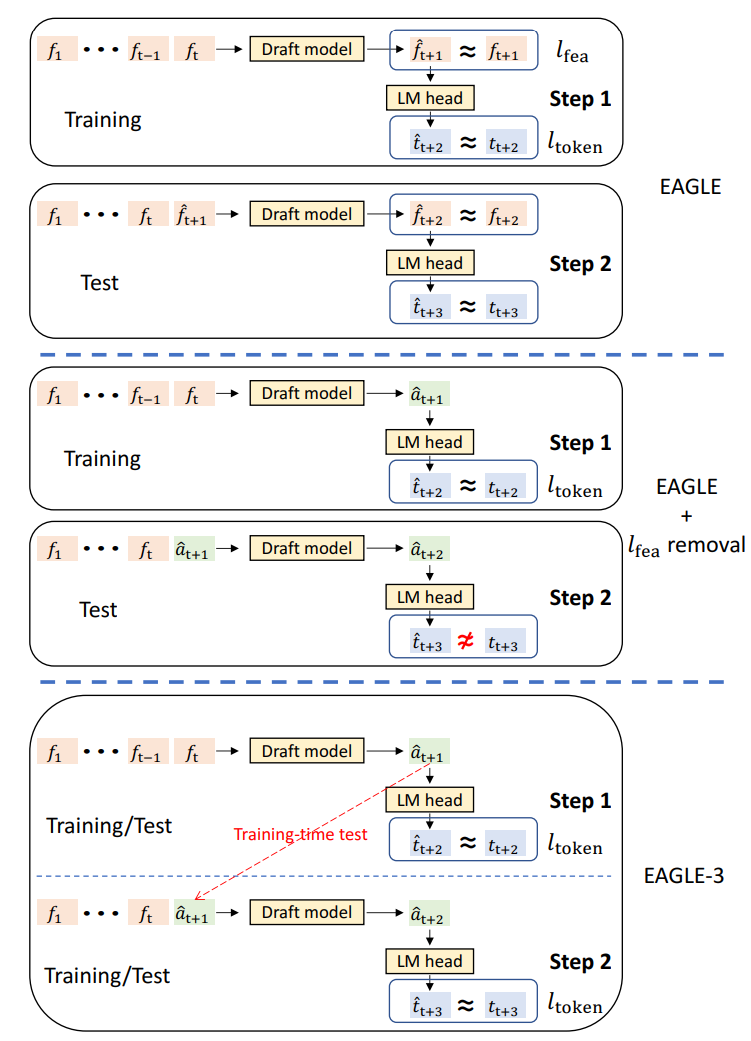
需要修正一个常见的简化:TTT 不等于把所有深度一次性无依赖算完。 同一个深度上的多个起点可以并行,下一深度仍需要上一深度生成的表示。训练 attention mask 则让每个起点只访问自己的合法上下文和递推链,防止不同起点的模拟后续互相泄漏。
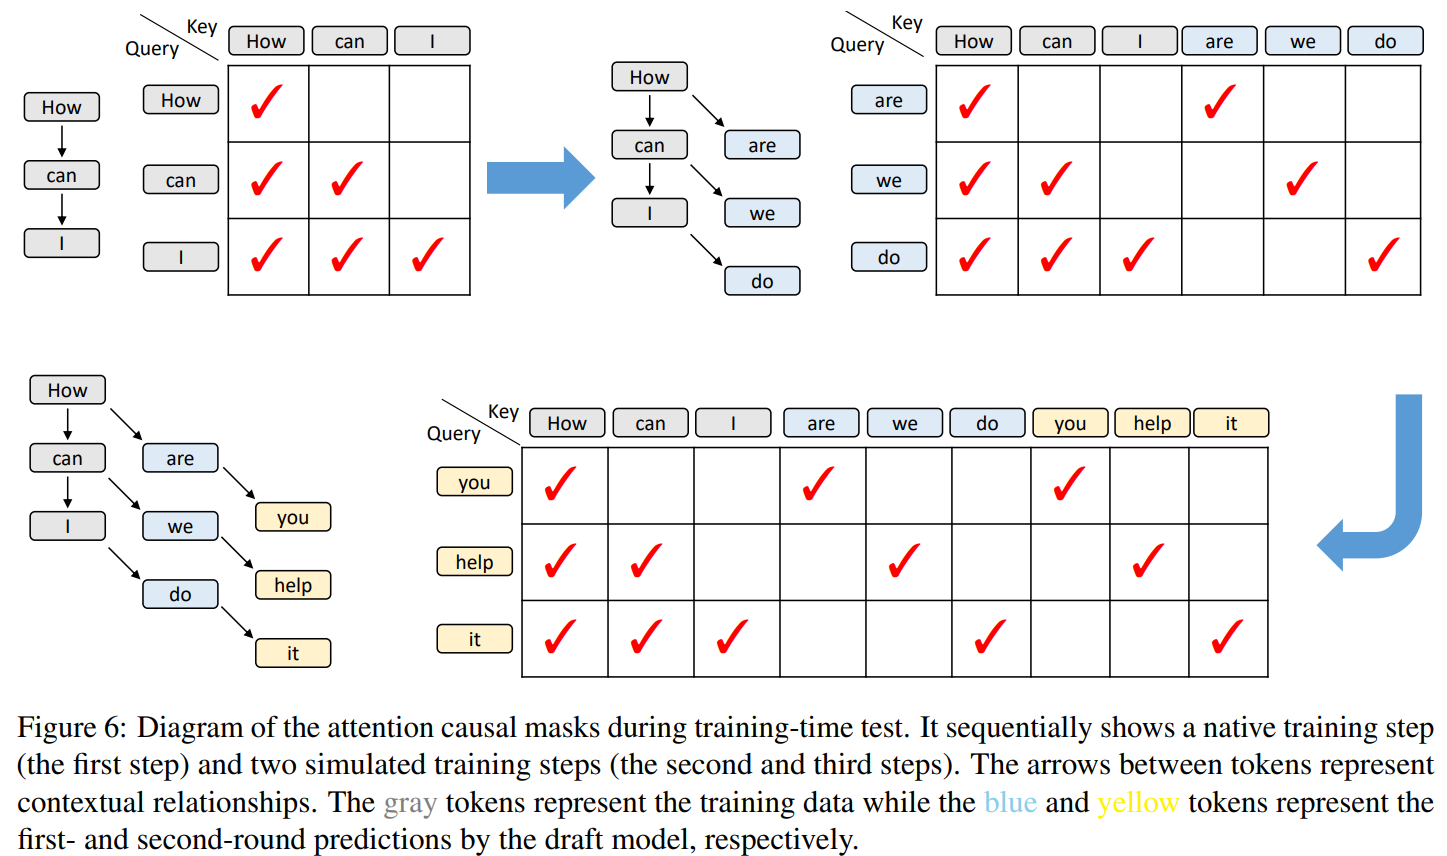
图中的额外 mask 不是装饰:如果把模拟轮次当成普通连续序列,后一个训练起点可能读到本不该看见的答案。
3.3 SpecForge:TTT 循环、teacher forcing 与梯度边界
当前实现的入口是 OnlineEagle3Model.forward(),训练策略是 Eagle3TrainStrategy。名字中的 Online 是历史命名,这个 wrapper 也被当前统一 runtime 的 offline 训练使用。
其核心逻辑可以简化为以下说明性伪代码:
state = fuse(target_aux_features)
losses = []
for depth in range(ttt_length):
    # input_ids、teacher、loss mask 按深度对齐;attention 限制各 rollout 的上下文
    embeds = draft.embed_input_ids(shifted_training_tokens(depth))
    state = draft.backbone(embeds, state, rollout_attention, rollout_kv)
    logits = draft.compute_logits(state)
    losses.append(token_distribution_loss(logits, shifted_teacher(depth)))
loss = sum(ploss_decay**depth * value for depth, value in enumerate(losses))
真正值得注意的是三处细节:
第一,latent self-feedback 与 token self-sampling 不是同一件事。 当前循环把 hidden_states_out 赋给下一轮 hidden_states;token 输入却通过 padding(..., left=False) 等对齐逻辑推进训练序列,并非每轮都把 draft argmax 写回输入。这是自生成状态加 teacher-forced token 的训练路径,不能描述成完全自由运行的生成。
第二,不能把 stop-gradient 写成 EAGLE-3 的必需步骤。 这个循环直接传递 hidden_states_out,这里没有 blanket detach()。teacher 分布和统计指标的 detach 是另外的边界;冻结 teacher,也不等于停止梯度穿过 draft 自己的递推。原文把 stop-gradient 当成统一规则的说法在这个版本下不成立。
第三,token loss 不必是对数据 token 的普通硬标签 CE。 当前默认路径通过 LogSoftmaxLoss 对齐 teacher 分布,训练策略再按深度衰减聚合;源码还提供 LK 等可选目标。论文的“取消 feature regression”和某个框架的“具体 token objective”是两个层次,不宜混写。
如果启用缩小的 draft vocabulary,还必须同时处理 t2d、d2t 和监督 mask。草稿 ID 只是较小词表中的索引,不能原样当作 target token ID。当前 SGLang 也通过映射将其恢复到 target 词表。训练数据归一化与推理模型是检查该契约的两端。
3.4 SGLang:prefill、draft、verify、draft extend
当前 EAGLEWorkerV2.forward_batch_generation() 的主路径如下:
首次 prefill
  target forward:填充 target KV,取得 target features 和 anchor
  _draft_extend_for_prefill:shift token,填充 draft KV,准备首层候选

后续每轮
  draft / draft_forward:逐深度扩展,整理候选树
  run_eagle_verify:target forward + grammar mask + sample
  提交有效长度与接受路径
  _draft_extend_for_decode:用 target 确认的特征刷新 draft 状态
prefill 中,对于 [A,B,C] 和 target 生成的 D,draft 的特征输入为 [h_A,h_B,h_C],token 侧配成 [B,C,D]。它计算的是处理 B/C/D 的草稿状态,最后一行给出 E 的候选。
draft_forward() 再从这些已准备的候选开始循环。源码在最后一轮选出 token 后直接 break,不再做无用 forward;因此不能把 speculative_num_steps=m 简化成“decode 函数内恰好调用 次 draft forward”。首层预测可能已在上轮 draft extend 中完成。
生成阶段整理 score_list、token_list、parents_list;树构建生成 custom_mask、positions、retrieve_index、retrieve_next_token、retrieve_next_sibling。这些数组分别描述可见性、逻辑位置和验证遍历路径,而不是几份等价的 token 下标。
run_eagle_verify() 完成 target forward 后,调用 eagle_sample() 得到 predict、accept_lens 与 accept_index。当 topk > 1 时,它还把接受路径的 KV、预测和 hidden states 整理到后续链式处理所需的位置。
最后的 draft extend 很关键:target 的验证结果不仅决定输出,也生产下一轮 draft 的可信条件。 如果只更新 token 历史而遗漏这个状态刷新,下一轮就可能继续使用未被 target 确认的 latent/KV。
EAGLE-3 因而仍有两个不同的递推方向:一轮内部用 draft 自己的 向前猜,一轮结束后用 target 确认的特征重新对齐。TTT 训练前者,serving 的 draft extend 维护后者。
4. DFlash:把整块重计算并行化,target feature 改从每层 KV 注入
4.1 一次 forward 同时预测多个 MASK
EAGLE-3 的训练改善了多步 draft 的质量,但执行仍需要逐深度推进。DFlash 将输入改成:
target 已执行的前缀: A B C
target 给出的 anchor:D

draft 输入: D [MASK] [MASK] [MASK] [MASK]
draft 输出:     E      F      G      H

target verify 输入:D E F G H
这里的 包含一个 anchor,真正新提出的候选是 。这是一次 block denoising forward,不是每生成一块都执行多轮扩散去噪;target 自己仍是原来的自回归模型。DFlash 论文的主要变化是把 diffusion-style 计算用于 cheap drafter。
“并行预测”也不等于 hidden states 之间毫无交互。原始 DFlash 在块内使用双向 attention,多个 MASK 的表示可以互相影响;缺少的是实际已经选出的前序离散 token 条件。计算第二个位置的分布时,模型还不知道第一个位置最后选了什么。
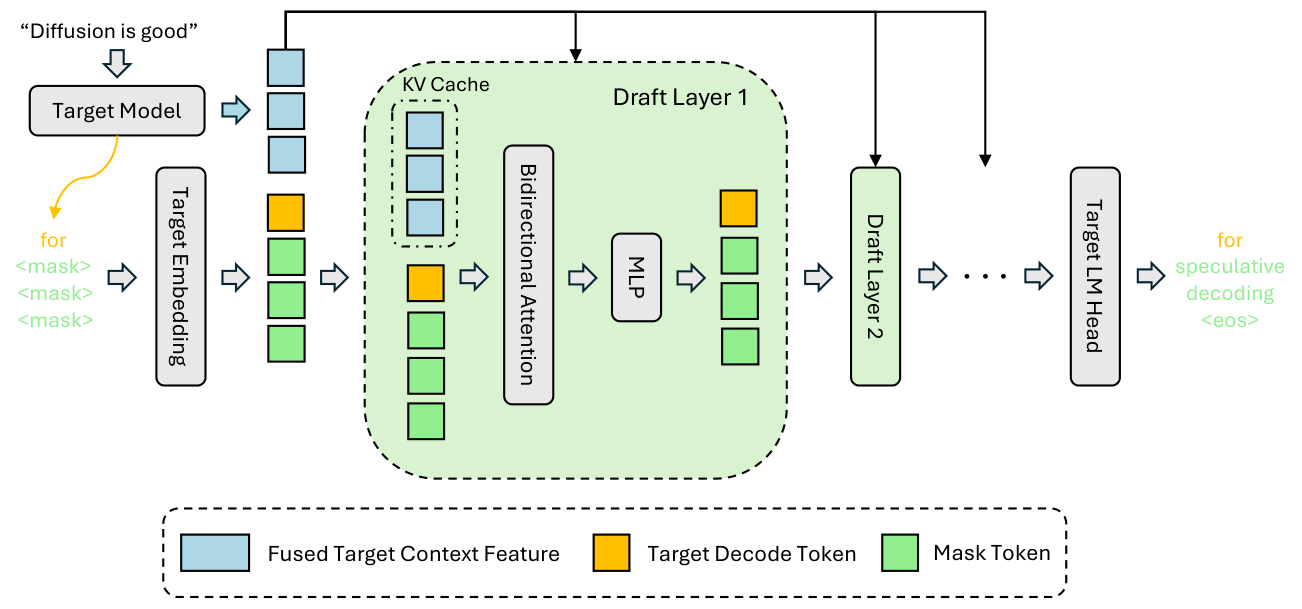
图源:DFlash 论文 v2,Figure 2,PDF 第 4 页,从原 PDF 裁出图区,保留原始标注。读图时沿两条路径看:上方的蓝色 target features 注入每一层,下方的 anchor 与 MASK 通过 draft backbone。下面的中文流程图进一步展开训练监督和验证后的状态提交。
4.2 KV injection 注入的是投影后的 target hidden,不是 target KV
从若干 target 层提取特征,拼接、投影得到条件表示 。对 draft 的第 层,可以概括为:
该层的 draft query 读取 context KV 和当前 noisy block 的 KV:
公式省略 norm、RoPE 等细节。这里没有直接复制 target attention 层的 K/V 张量。 target 与 draft 的层数、head layout、投影参数未必相同;复用的是 target 已经计算出的上下文信息。
每一层都重新访问这份条件,有利于增加 draft 深度时继续利用 target 信息。并行 block 降低了沿 token 轴反复执行 backbone 的需求,但多层 draft、context KV projection 和更长的 attention 仍然有成本。
4.3 SpecForge:随机 anchor、严格的上下文边界与位置加权 CE
根据 DFlash §4.2 与 Figure 4及 SpecForge block 训练实现简化重绘。图中用一个 anchor 展示数据流,实际训练会同时采样多个 block;最容易漏掉的约束是 context 的截止位置在 anchor 之前。冻结 target 与共享词表接口,仍允许损失经过 LM head 回传到 draft。
OnlineDFlashModel._forward_draft_blocks() 负责把训练序列变成多个独立 draft block:
- 用
loss_mask找到可监督区域,采样 anchor;当前_sample_anchor_positions()要求 anchor 与紧接的目标位置都有效。 _create_noise_embed()构造每块首位为真实 token、其余为 MASK 的输入。- position ID 使用原始序列中的 anchor 位置加块内偏移,不能重置成每块都从零开始。
- 从完整序列的 target forward 取得 context features,但用 mask 限制每块可访问的范围。
- backbone 一次处理这些 block,对非 anchor 位置计算预测损失。
设一条训练序列长 ,采样了 个 anchor,则 draft query 长度为 ,attention 的 key/value 逻辑长度为 。允许的上下文是:
必须是严格小于 anchor 位置。 训练时虽然已离线算出 ,推理却没有它;把它放进可见 context 等于让 draft 偷看 target 已处理 anchor 后的信息。create_dflash_block_mask() 中的 kv_idx < anchor_pos 明确体现了这个边界。
原始 full-attention 路径允许同块双向交互;当前框架还支持 sliding-attention checkpoint,其 block 内 mask 会增加因果限制。不能把论文默认 mask 无条件套在所有新模型配置上。训练 mask 与分层 attention 实现、DFlash 模型需要一起看。
默认 DFlash objective 可写为:
是位置权重的衰减尺度,这里特意与 proposal length 分开命名。越早出错,浪费的后缀越长,所以前部预测得到更大权重。
这条路径主要用数据 token 做 CE,不要求所有训练样本都携带完整 teacher 概率。冻结的 embedding/LM head 负责维持表示与词表接口,训练更新 draft backbone、条件投影等参数。当前 SpecForge 还支持 D-PACE/LK 等 loss 变体,它们是可选训练策略,不是 DFlash 论文的必选组成。
固定 可以约束 noisy query 的规模,但不意味着上下文长度 增长后训练成本完全不变:target capture、feature 存储和读取 context 的 attention 仍受 影响。
4.4 SGLang:用 target hidden 更新 draft KV,替代 EAGLE 式状态递推
DFlashWorkerV2.forward_batch_generation() 的 prefill 分支先执行 target,随后立即调用 _append_target_hidden_to_draft_kv_by_loc(),按 target 提供的有效位置填充 draft context KV。
这一步不能随意推迟。源码说明了原因:prefill 返回后 scheduler 可能更新 radix cache;共享映射可被发布之前,对应 draft cache 也必须已经具备有效内容。
decode 期主流程为:
这张图把论文的一次 drafting 展开为 SGLang worker 中的一轮状态变化。示例接受 E F、拒绝 G,于是新输出为 E F G*;能写回 context 的却是已执行的输入 D E F。新输出的 G* 还没有自己的 target hidden,下一轮通过 next_draft_input 携带它及有效前缀长度,再准备 positions 与临时 cache slots。
与 EAGLE 的差别在于,DFlash 不必用自生成状态再跑一条逐 token 的 draft extend 链。它在每轮验证后,把可信 target context 直接物化到每个 draft layer 的 KV 中。DFlashAttention.kv_proj_only() 和 project_target_hidden()是理解这种更新的模型侧入口。
当前 worker 支持共享预分配映射,也有 compact draft cache 的滑窗路径。两种布局改变 KV 的物理组织,却都必须满足:下轮可见的历史只对应 target 已确认的前缀,不能让 noisy block 留下的临时内容冒充可信 context。
5. DSpark:并行 backbone 加轻量序列头,再决定值得验证多长
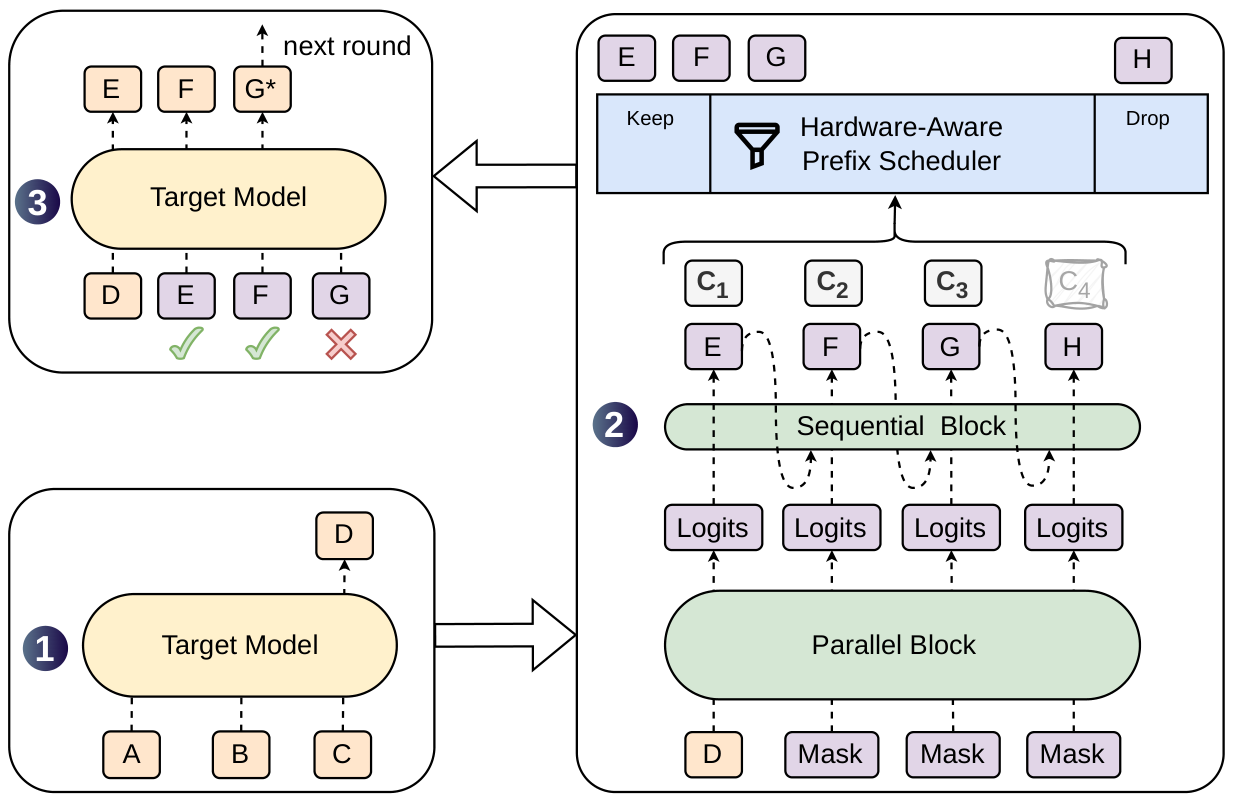
图源:DSpark 论文 v1,Figure 1,PDF 第 5 页,直接裁取原图。右侧先生成 E F G H,调度器裁掉 H;左上角的 target 随后拒绝 G 并给出 G*。调度裁剪和验证拒绝是两次不同的决定,后面的推理图会把原图的环形阅读顺序展开为从左到右的执行顺序。
5.1 为什么并行预测会出现 suffix decay
如果上下文允许 of course 与 no problem,两个独立位置的高概率词可能组合成 of problem。每个 token 单看都合理,组合后却偏离 target 的条件分布。越往后,前面选择的分支越重要,缺少实际 token 条件就越容易使接受率下降。
DSpark 把大部分计算留在 DFlash 式 backbone 中,一次生成全部位置的 hidden states 与基础 logits ,再由轻量 head 沿块内前缀修正分布:
这是正规化后的条件分布,不是简单把两个概率函数相乘却省略 normalization。DSpark 论文和公开模型实现给出了 Markov 与 RNN 两类序列头。
Markov head 只依赖前一个 token,用低秩形式避免存储 转移矩阵:
RNN head 再维护块内状态 ,将前一状态、前一 token embedding 与当前位置 拼接,通过门控更新状态,同时产生 logit bias。它能利用更长的已选块内前缀,但递推深度仍存在。
所谓 semi-autoregressive,是把串行部分限制在轻量修正和采样,而不是每个 token 都重新跑完整 Transformer。对 Markov head,训练时若前驱 token 全部已知,可以批量计算 bias;推理时前驱是刚选出的 token,仍需从左到右执行。RNN 在训练时也有块内递归状态,不能宣称全部序列头都能消除训练递推。
5.2 DSpark 的一个小改动:anchor 行也负责预测
原始 DFlash 的 个输入位置只用后 行预测。DSpark 的默认布局把 anchor 自己也当成预测位置:
DFlash,4 个 proposal:
  输入    D MASK MASK MASK MASK
  预测      E    F    G    H

DSpark,4 个 proposal:
  输入    D MASK MASK MASK
  预测    E F    G    H
因此 DSpark draft 可以用 个 query 输出 个候选,target verify 仍需要 [D,E,F,G,H] 共 个输入。
SpecForge 的 _build_dspark_labels_and_mask() 使用 anchor 后的 1 ... block_size 作为 label 偏移;SGLang 的 DraftProposer 则按 sample_from_anchor 选择 query_token_num=m 或 m+1,不能忽略 checkpoint 对该行为的声明。训练 label 构造和推理 proposer直接对应。
这种一位变化会影响 label gather、LM head 行数、position ID、loss mask 和 serving 参数。若沿用 DFlash 的切片规则,程序可能仍能运行,但预测整体错位。
5.3 SpecForge:CE、分布 L1 和 confidence 三个训练目标
OnlineDSparkModel 复用 anchor 采样、noise embedding 和 context mask,然后构造:
根据 DSpark §3.1–3.3及 SpecForge objectives重绘。图中 target_ids=[E,F,G,H],prev_token_ids=[D,E,F,G];backbone 同时产出各位置 hidden 与基础 logits,序列头再得到修正后的 draft logits。三个损失框分别回答“词对不对”“分布接不接近”“接受率估得准不准”,STS 则另用留出数据校准。
这里也是 teacher forcing。推理时 prev_token_ids 来自 draft 的实际选择,训练 CE 很低并不自动证明自由生成的块内一致性已经足够好。
DSpark 额外需要 target_last_hidden_states。它与用于 context conditioning 的多层 hidden_states 不是同一个张量:前者通过冻结的 target LM head 恢复 teacher 分布,后者用于 draft KV injection。源码用 safe_label_indices - 1 取得预测该 label 的 target hidden,避免再次发生一位错配。DSpark feature contract明确要求这两类数据。
令 为 teacher 分布, 为经过序列头修正后的 draft 分布,训练项是:
最后按配置加权组合。论文的默认权重为 ;这是该 recipe 的设置,不是所有 target 的最优超参数。严格说 TV 是 L1 的一半,论文以 TV 命名的损失项采用 L1 形式,差一个常数可以吸收到权重中。
为什么有意义?在同一前缀下,标准拒绝采样的平均接受概率为:
它衡量整个分布的重叠程度,既不是 的最大 softmax 值,也不是某一个已抽到 token 的 。
当前 _dspark_objective_chunk_terms() 在 teacher 一侧使用 no_grad(),计算 L1 时允许梯度回到 draft;confidence 的 soft label 则使用 accept_probability.detach()。这里 detach 的作用是固定监督目标,防止 confidence loss 借改变标签走捷径,并非切断整个 draft 的训练。
实现还按 block 分块计算词表 logits,通过 checkpointed_chunk_reduce() 聚合 numerator/denominator,控制 中间张量规模。做分布匹配后,训练成本不只来自 backbone;大词表上的 teacher projection 和 loss 也可能成为瓶颈。
5.4 Confidence 预测的是“前面都通过以后,这一位还能不能通过”
confidence head 将 draft hidden 与前驱 token 的 Markov embedding 作为输入,输出条件接受率 。连续前缀存活概率为:
这是条件概率的链式乘积,不要求各位置无条件独立。后续调度需要的是 的绝对数值,仅有排序正确还不够:轻微过度自信经过多个位置相乘,会错误估计延长验证的收益。
DSpark 因此引入 Sequential Temperature Scaling(STS),在留出的验证数据上逐位置校准,使累计存活概率更贴近实际观测。它调整 confidence logits 的温度,不是调整最终生成文本的采样 temperature。SGLang 将这部分独立为 dspark_sts.py,并在 planner 中验证校准文件与当前 proposal length 的一致性。
5.5 从单请求 acceptance 走向全 batch 验证预算
设共有 个请求,第 个请求选择验证 个草稿。总 target 输入量和预期有效输出为:
如果 profiling 给出每秒能执行多少轮的曲线 ,则预计吞吐为:
延长一个请求的验证前缀,边际收益是对应的 。由于它沿位置单调不增,在固定总预算下,按存活概率选取高价值扩展能自然保留前缀依赖;相同分数时仍需优先较早的位置。
但选择验证长度也可能影响正确性。若观察了尚未纳入前缀的随机候选,再回头决定是否保留前面的 token,就可能产生 selection bias。论文因此讨论 non-anticipating 的截断条件,而不是允许任意查看整块未来后再选一个看起来最好的长度。
这也解释了为何不能只抄一个 argmax(expected_throughput) 就宣称调度无损:还必须说明估计来自哪一轮、决策依赖哪些已知量、截断处怎样产生补充 token,以及采样分支怎样使用有效的 。
5.6 SGLang:host 选预算 K,device 分配当前块,executor 执行验证
host 队列提供历史预测,用它算出本轮 top-k 的 K;当前候选中究竟选哪 K 个位置,则由 GPU 使用当前 confidence 决定。 队列不保存下一轮要验证的 token ID,也不把历史 top-k 的请求分配原样搬到本轮。
以下核对的是本文固定的 SGLang 822e73ccddc0。源码中的具体类名是 DraftBlockProposer、DSparkVerifyPlanner、TargetVerifyExecutor;下文简称 proposer、planner、executor。host 侧还有两个角色:ConfidenceRelay 负责把 confidence 搬到 CPU,HostConfidenceBudgetPlanner 负责从中选出预算。
一轮 decode 在 DSparkWorkerV2._forward_decode() 中的实际调用链如下,每跳标注输入与产出(省略 prefill、观测与 mamba 分支):
verify_window = alloc_verify_window(...)             # 各位置 position 与 cache 槽位
proposal = self._proposer.propose(...)               # → draft_block_ids、draft_tokens、
                                                     #   corrected_logits、draft_hidden、confidence
if proposal.confidence is None:
    confidence = planner.compute_confidence_tensor(...)      # confidence head + STS
verify_token_budget = planner.resolve_verify_token_budget(...)  # overlap:取回预写的 K
layout = planner.schedule_layout(confidence, budget)  # 当前 top-K → verify_lens → RaggedVerifyLayout
verify_ids_2d = cat([draft_block_ids[:, :1], draft_tokens])    # anchor + 草稿
if run_compact:
    target_verify, hidden = executor.run_compact(layout, ...)   # ragged 行压紧 + graph bucket
else:
    target_verify = executor.run_non_compact(...)               # 完整 (bs, W) 链宽
accept = executor.accept_and_finalize(...)            # → correct_len、bonus、cap_trim_lens、commit_lens
on_publish(accept.new_seq_lens, confidence)           # → ConfidenceRelay 发布与 ring 写入
executor.commit_hidden(...) # 有效前缀 target hidden → draft context KV三个组件的协同不是”三个对象依次调用”那么简单:proposer 产出候选与分布,planner 只消费 confidence 与预算决定”验证到哪”,executor 消费前两者的结果执行 target 与接受判定。 候选 token 和 corrected q 完全绕开 planner——分配只取决于 confidence 分数,不取决于 token 字面值;而 executor 的接受判定必须拿回 proposer 的 q,两者通过 DraftBlockResult 交接。
图中 host 预算路径与 device 当前块路径在 planner 的 schedule_layout() 汇合。箭头表达依赖,不表示实测耗时;overlap 模式下,预算已经在 forward prepare 阶段由 scheduler 调用 prepare_verify_budget() 写入 draft_input.verify_token_budget,worker 中的 resolve_verify_token_budget() 只是取回它。不能按函数在 _forward_decode() 中的位置,误认为 host 必须等本轮 proposer 完成才开始算预算。worker、planner
之后各小节沿调用链展开:5.6.2–5.6.3 讲历史数据如何在 host 侧定出 K,5.6.4 讲当前数据如何在 device 侧定出归属,5.6.5–5.6.6 讲布局如何变成执行与提交。
5.6.1 三个组件分别交付什么
| 组件 | 输入与工作 | 交给下游的结果 |
|---|---|---|
| Proposer | anchor、历史 context、masked block;一次并行 backbone,再执行轻量序列头与采样 | 候选 token、实际采样所用的 corrected logits、draft hidden,以及可选 confidence |
| Planner | host 历史 confidence 与成本表选 K;device 当前 confidence 分配 K | 含 anchor 的 verify_lens、ragged offsets/layout、graph tier |
| Executor | 候选、layout、target 模型、采样/grammar 配置 | target logits、接受前缀、bonus、新序列长度,以及待提交的有效 hidden/KV 状态 |
Proposer 将重计算留在并行 backbone,把块内的 D → E → F → G → H 依赖放在轻量 Markov/RNN head 上。folded 路径可把 head 修正与采样合并,但随机验证仍必须拿到生成这些候选时实际使用的 。DraftBlockResult.corrected_logits 承担这个契约;不能用未修正的 backbone logits 替换它。具体字段也要区分:draft_hidden_3d 在 DraftForwardResult 中,DraftProposal 对外暴露的是 draft_hidden,不是同名字段。proposer
如果 proposal 没有直接带回 confidence,worker 会调用 planner 的 compute_confidence_tensor() 补算。confidence head 可使用前驱 embedding,并通过 STS 校准;它估计接受概率,不是 target 已经验证出来的真假标签。
5.6.2 历史 confidence 如何到达 host:两个 ring,各有职责
这里的“host 队列”实际需要拆成 ConfidenceRelay 的 D2H ring 和 HostConfidenceBudgetPlanner 的可选 carry ring。前者解决跨设备的数据可见性,后者补足配置要求的历史滞后。relay 源码
- 发布当前预测。
_forward_decode()完成接受处理后调用on_publish(..., confidence=confidence)。FutureMap.publish()把 confidence scatter 到持久 device buffer,记录publish_ready。发布的是本轮 proposer 的预测,不是本轮 acceptance 的经验均值。 - 提交 D2H。 专用
fwd_prepare_d2h_stream先wait_event(publish_ready),随后把 confidence buffer 非阻塞复制到 pinned host ring,并记录copy_done[slot];同一个 slot 还保存 request generation 快照。publish_ready表示生产依赖就绪,copy_done才表示 host 数据可读。 - 读取旧槽位,不等最新预测。 CUDA overlap 路径固定
CONFIDENCE_RELAY_RING_LAG=2、ring depth 为 3。resolve()选(ring_pos - 2) % 3,通过copy_done[slot].query()非阻塞检查;ring 尚未积累足够发布,或复制尚未完成,都返回None,不会在这里synchronize()等待。 - 映射当前请求。 从历史快照中按当前
req_pool_indices_cpu取行,所以 batch 重排不要求沿用历史 batch 的行号。随后用 generation 判定这一行是不是同一代请求。 - 必要时再延迟。 host planner 配置
lag_steps=max(env,1),该版本环境变量默认 2;carry_steps=max(lag_steps-relay_lag_steps,0)。默认 overlap 已由 relay 提供两步滞后,carry 长度为 0。若配置为 4,则 host 另外保留 2 个 carry 槽;每次读取旧 confidence/generation,再覆盖该槽并推进游标。host planner
compute_budget() 内部依次执行 _shift_to_lag()(carry_steps>0 时读写 carry 槽,否则原样返回 relay 已滞后的数据)、_two_steps_prior_survival()(对滞后 confidence 逐请求 cumprod,并按 generation 过滤)与 compute_verify_token_budget()(下一小节)。函数名里的 two_steps 是历史命名,真正滞后几步由 lag_steps 配置决定。
在连续发布、同一请求持续 decode 的简化时序中:
publish c0 → ring_pos=1:还没有可读历史
publish c1 → ring_pos=2:resolve 读 slot 0,即 c0(须 copy_done)
publish c2 → ring_pos=3:resolve 读 slot 1,即 c1(须 copy_done)
这表示准备下一轮时保留两步的 relay 距离,不是每条请求无条件拥有精确的“前两次 decode”记录:slot 按发布序列推进,continuous batching 中请求可能暂停、退出或重新加入。generation 防止跨请求污染,并不证明同一代记录足够新鲜。
若旧 slot 属于 generation 7,而当前请求已是 generation 8,_two_steps_prior_survival() 返回该行全 1 的 survival。carry 冷启动的 generation 为 0,也走同一回退。这是乐观预测,会倾向于给新请求探索空间;它既不是全 0,也不是同步拉取当前 confidence。另一方面,relay 返回 None 时预算本身是 None,planner 无法进行这次动态 top-k,走其完整/统一布局回退;不要把两种冷启动合并成一个分支。
这里没有对多轮 confidence 做滑动平均。 避免当前 GPU→CPU 同步进入调度关键路径,是由 event/query 和预计算时序可以推导出的工程收益;把滞后解释为“为消除 TP 浮点噪声而跨步平滑”没有这段源码支持。源码对同一条 D2H 机制的注释写得很直接:“don’t sync the schedule stream; gate a private stream on the publish event and copy into the static pinned buffer”——confidence ring 复用了同一个 fwd_prepare_d2h_stream 与 publish_ready event,读旧槽位时只用 copy_done.query() 非阻塞检查,读不到就放弃本轮动态调度。relay 源码 关闭 overlap 时,compute_budget_sync() 确实同步复制 confidence 到 CPU,但 relay_lag_steps=0 会使 host carry 补足配置的 lag,因此也不能直接断言它使用当前快照决定当前预算。
5.6.3 host 如何从历史预测算出 K
令 为当前请求数,默认每请求至少执行一个 anchor 行。用 表示额外草稿预算,用 表示 target 输入行数,避免把两者都写成 B:
compute_verify_token_budget() 将历史 survival 展平,过滤低于 survival_eps 的分数,降序排列为 ,然后一次累计求和,评估所有前缀预算:
若使用 additive cost table,则改成 。因此 host 确实做了一次历史分数排序,但只输出最佳数量 budget=K*,不会把这次排序的请求/位置索引交给 device。预算搜索
下面是说明算法的假设数字,不是 benchmark。设两个请求各提出三个草稿,历史 survival 为 [0.9,0.6,0.2] 与 [0.8,0.5,0.1],排序结果为 [0.9,0.8,0.6,0.5,0.2,0.1]。
| K | target 行数 R+K | 预测输出 N | 假设 SPS | 预测 token/s |
|---|---|---|---|---|
| 0 | 2 | 2.0 | 100 | 200 |
| 1 | 3 | 2.9 | 95 | 275.5 |
| 2 | 4 | 3.7 | 90 | 333 |
| 3 | 5 | 4.3 | 85 | 365.5 |
| 4 | 6 | 4.8 | 80 | 384 |
| 5 | 7 | 5.0 | 65 | 325 |
| 6 | 8 | 5.1 | 55 | 280.5 |
host 因而选 。它回答“愿意多验证四个草稿”,没有回答“当前两个请求各分几个”。
5.6.4 device 用当前 survival 分配 K,而不是复用历史赢家
假设同一轮当前 survival 已变成请求 A 的 [0.95,0.90,0.85]、请求 B 的 [0.70,0.30,0.10]。GPU 的 global top-4 选中 A 的三个位置及 B 的第一个位置,于是:
历史 top-4 的归属:A 两个、B 两个 → 只用于估算 K 的收益
当前 top-4 的归属:A 三个、B 一个 → 真正决定本轮布局
selected_extra = [3, 1]
verify_lens    = [4, 2]   # 每请求 +1 个 anchor
有效 target 行数 M = 6
默认 min_verify_len=1 时,源码相当于 verify_lens=clamp(1+selected_extra,1,max_len)。候选窗口、epsilon、上下界都会影响最终有效行数;一般应理解为预算上界,而不是任何配置下都严格等于 。
排序优先级是 survival 降序 → 位置升序 → 请求索引升序。Torch 参考路径通过多次 stable argsort 实现,CUDA 路径使用对应 Triton kernel。累计乘积单调不增,配合位置优先打破平分,才保证一个请求选到的是前缀;这不是依赖 torch.topk 默认稳定性的保证。“独立于 token 字面值”指不拿 token ID 当平分规则,并不意味着 confidence 与已采样前驱无关。调度 kernel
CUDA 路径的 _schedule_topk_selected_extra_kernel 不加载任何 token ID:它对展平后的 survival 与 (request, position) 索引做两两比较累计排名,排位条件就是 gt | (eq & (pos_lt | (pos_eq & req_lt)))——survival 更大者在前,相等时位置靠前者在前,再相等时请求索引小者在前;排名小于 budget 的位置经 atomic_add 计入各请求的入选数。所以“tie-breaking 与 token 字面值无关”在这个内核里是结构性的:它根本没有 token 输入。
TP 的数值微差是另一层问题:相等分数的确定性规则不能消除不相等分数的跨 rank 偏差。因此 _schedule_verify_lens() 用 SpecTpSyncSite.DSPARK_PLAN 同步最终 verify_lens;SpecTpSync.sync() 的实现就是 tp_group.broadcast(values, src=0),且默认 SGLANG_SPEC_TP_SYNC=all 开启——verify_lens 确实从 rank 0 广播。该快照的 resolve_verify_token_budget() 明确写着 No collective,注释给出的理由是预算只从已经广播的 draft token(经由 confidence)、复制的 generation 与静态 SPS 表导出。draft 采样在 DSPARK_DRAFT_GREEDY / SAMPLE / MULTINOMIAL 站点逐 token 广播过,是这条一致性链条的起点,所以预算不需要再广播一次。不能把这两件事混成“每轮 host budget 都从 TP0 广播”。graph tier 若由本地 budget 派生,也依赖这些输入一致,不能指望后面的 lens 同步修复所有上游 shape 分歧;关闭同步后,SGLANG_DSPARK_DEBUG_CONFIDENCE_PREFIX_SCHEDULER=1 的日志会直接暴露同一请求在不同 rank 上 verify_len 分歧,这正是广播存在的意义。DP attention 还有独立的 tier gather 路径。planner
5.6.5 ragged layout 把预算变成实际执行 shape
设三个请求的 verify_lens=[4,2,6],这里每个长度都包含 anchor。额外草稿预算为 ,有效 target 行数为 ;不能把 12 同时当成 top-k 的 K。
Compact 路径将有效行按 offset [0,4,6,12] 压紧,并一并构造 position、cache location 与 attention metadata。若 CUDA Graph bucket 为 [8,16,32],12 个有效行可能 replay 16 行的 graph。多出的 4 行不属于请求的有效输出,但不能据此声称它们完全不执行计算:dense MLP 等算子可能仍覆盖 bucket 行,实际节省要按所用 graph/kernel 衡量。non-compact 路径则把完整 verify_ids_2d 展平,保留配置的固定链宽 verify_num_draft_tokens,不是自动缩成当前最大 verify_len。executor
capture 期的槽位分布本身也是不均匀的:build_capture_verify_lens() 把 total 按 [base+1]*rem + [base]*(num_slots-rem) 分配,例如 42 个 token、8 个请求槽位对应 [6,6,5,5,5,5,5,5],而不是 8×6=48。因此任何要求“每个请求恰好一个等长 block”的模型组件都不能默认 ragged capture 槽位均匀——这类 num_tokens == bs * block_size 式假设必须由组件自己声明并检查,调度器不会替它保证;反过来,capture 布局是否可用也取决于各 attention backend 对 ragged 序列长度的支持声明。
这也是成本表必须与模型、硬件、backend、graph tiers 和并行配置匹配的原因。同一 bucket 内继续裁剪,可能只减少有效 token 而不减少 replay 成本。该版本还提供可选 _budget_aligned_to_graph_tier():将预算补到既定 tier 可容纳的额度,再让当前 top-k 填入更多真实草稿,默认不开启。这里的物理成本是离散的,但 host 的表查询/插值只是它的近似模型,不应把两者说成完全相同的精确阶梯函数。
未初始化 SPS 表时,该版本的 compact planner 可直接缓存 verify-all 统一布局,绕过每轮动态调度。从数学上看,若 SPS 恒定、候选 survival 为正,增加 K 只增加预测收益,最大预算自然最优;若收益为零、被 epsilon 过滤或出现平分,不能额外声称 argmax 必定唯一落在最后一项。capture-derived SPS 可用于建立实测成本,但本节不把未经本地复测的启动耗时写成通用性能数据。SPS 配置
5.6.6 接受、预算截断和 KV 提交:必须保持一位偏移
继续使用 anchor D、草稿 E F G H 的例子。若 verify_len=4,target 输入是 [D,E,F,G]:D 行的 logits 检验 E,E 行检验 F,F 行检验 G,最后 G 行供前缀全通过时产生 bonus H*。H 没有作为第四个草稿进入接受判定。
若 E、F 接受而 G 拒绝,则输出 [E,F,G*],下一轮 anchor 是 G*。此时 target 已有的有效输入行是 [D,E,F],提交这三行的 KV/hidden;G 虽然已输出,却还没有经过 target forward,因此并没有 G 的 KV 可以提交。** commit_lens=correct_len+1=3 中的这个 1,在输出计数中对应 bonus,在本轮 KV 行计数中对应旧 anchor D。
cap_trim_lens 更不能简单定义成“被预算删掉的所有后缀”。接受 kernel 的直接定义是:
ell = verify_lens - 1
capped = minimum(raw_correct_len, ell)
cap_trim_lens = raw_correct_len - capped
correct_len = capped
commit_lens = correct_len + 1
这是接受处理产生的长度经 layout cutoff 裁剪后的差值。例如 G 已经拒绝,raw_correct_len=2、ell=3,trim 为 0;即使 H 没验证,trim 也不会因此自动变成 1。若 raw 长度为 4、ell=3,trim 才是 1。compact 路径在规则缓冲区中恢复/填充 logits 后,raw 值还包含布局处理语义,不能将它当成对未执行位置的真实接受测量。
因此至少要分开记录:预算允许的前缀长度、target 接受长度、cutoff 调整量,以及实际提交长度。worker 还返回 block_accept_lens=commit_lens+cap_trim_lens,这正说明它们服务于不同的下游口径,不能全部写成“猜对几个”。bonus 必须按 cutoff 后的正确位置选取,compact offset 也必须保持请求归属。
执行顺序上,target forward 后应用 grammar mask,再做接受处理;带 live grammar 的 batch 不进入图内接受 epilogue,因为图内私有 buffer 不会自动收到外部 mask。folded draft 也不意味着可以 folded accept:该版本图内接受是 greedy,sampling batch 仍走 eager 接受,并由 corrected logits 恢复 。接受结果的 correct_len、bonus、trim 在 finalization 前同步到 TP ranks,随后发布 confidence 并提交有效状态,组成下一轮的 anchor/context 输入。worker、executor
这三个组件的协同最终形成两条跨轮依赖:已接受 hidden/KV 与 bonus 供下一轮生成;当前 confidence 经 relay 供后续轮估计预算。 当前块分配不会回写本轮已经选定的历史预算,但这是一种降低同步依赖的实现选择;改成当前数据选预算不必然产生循环,却会改变同步成本与截断决策的统计依赖,必须重新检查 sampling 的因果条件,不能直接沿用论文的 lossless 结论。
6. DFlash 2:把块内一致性拆成候选选择与局部表示建模
6.1 Top-1 错误并不总是 backbone 完全没想到答案
DFlash 2 的官方分析区分了两种失败:正确 token 已经在某个位置的 top-K 中,但独立 top-1 选错了;或者正确 token 根本不在候选集合里。前者可以改善选择,后者需要改善 backbone。
在官方报告的五层 Qwen3-4B drafter、GSM8K 设置中,首位置的条件 Recall@1 为 85.4%,Recall@16 为 99.5%;最后位置的 Recall@16 下降到 87.8%。这些指标都以更早位置正确为条件,不能当成任意上下文上的无条件准确率。DFlash 2 官方技术博客用这个观察引出 selector 与 convolution 两部分。
这条思路与 DSpark 是对并行 drafting 缺失依赖的不同回应。它们并非同一项目严格继承的四代版本,DSpark 的 serving scheduler 也不是被 DFlash 2 的 selector 替代了。
6.2 Selector:先并行算邻接候选分数,再走一条因果路径
保留位置 的候选集合 。对前驱候选 和当前候选 ,计算:
与 是前驱、后继的低维 codebook, 将当前位置 hidden 投影到同样维度。词表中任意两词的全转移不必在每个位置显式展开;只给相邻位置保留下来的候选对打分。
CandidateSelector.build_lattice() 的主要结果可理解成 [batch, m, K, K]:每个位置,对所有可能前驱与当前候选计算分数。首位置的前驱固定为 anchor。候选表与各位置的 已经生成,所以这些分数可并行计算。
接下来执行的是因果 walk:
或在候选集合内按正规化的条件分布采样:
当前实现不是 Viterbi,也不是最大化整条路径分数之和的全局搜索。 SGLang 的 sample_path() 和 SpecForge 的 greedy_path() 从 anchor 出发,用当前已选前驱查下一行。这保留了清晰的条件 proposal 分布,也避免把未来位置的分数倒灌进当前 token 的决策。
把 walk 逐步展开就是:step 0 的前驱固定为 anchor,对 的 个候选算 取 argmax 得 ;step 1 把前驱换成刚选出的 ,再对 取 argmax 得 ;依此类推。虽然 的邻接分数全部预先算出,每步实际只读取“前驱 = 已选 token”的那一行,其余行留给未走到的分支。SGLang 的 _follow_maps() 用 maps[:, edge].gather(-1, index) 顺序推进,经 torch.compile 后仍是串行步进;CUDA 路径则整段交给 selector_walk_triton。greedy 与 sampling batch 共用同一张 captured graph——源码注释明确这是 “selected rather than branched” 的选择式分支,而不是在 graph 里做控制流。
采样语义在 sample_path() 里也值得单独看。 的行用逆 CDF:uniforms.ge(probs.cumsum(-1)).sum(-1).clamp_max(K-1),即按累计概率落在哪个区间选哪个候选;greedy 行直接 argmax,并且其 q 被替换为路径索引上的 one-hot(torch.where(greedy_mask, one_hot(path_indices), q_rows))。所以随机验证拿到的 q 不是某个笼统的 softmax,而是沿实际路径逐步使用的每一行条件概率:step 0 是 anchor 行下的初始分布,之后各行按已选前驱 gather 出实际走过的那一行。
build_lattice() 的形状细节也能对上公式:unary_logits[:, :, None] + einsum("blpr,blcr->blpc", pred * hidden[:, :, None], keys),其中 hidden 是 hidden_projection 后的表示,keys 是后继 codebook 对当前候选的 gather,pred 在 step 0 用 anchor 行扩展成 份、step 用上一位置的 candidate_ids。两张 codebook 在 TP 上是逐 rank 复制的,不像 LM head 那样切分——候选 ID 是全局 gather 的,任一 rank 都可能需要任意一行。selector 实现
与 DSpark 的全词表 logit correction 相比,DFlash 2 把额外序列决策收缩到候选集;但 top-K 本身仍需要从词表 logits 中选取,codebook 也仍按词表大小存储。候选评分只处理 个词,不等于整个 drafter 的参数和计算都与 无关。
6.3 Grouped dynamic convolution:专门补块内局部依赖
selector 不能选择候选集合外的 token,因此还需要改善 late-position recall。DFlash 2 在 attention 和 MLP 子层周围加入 grouped dynamic depthwise convolution。
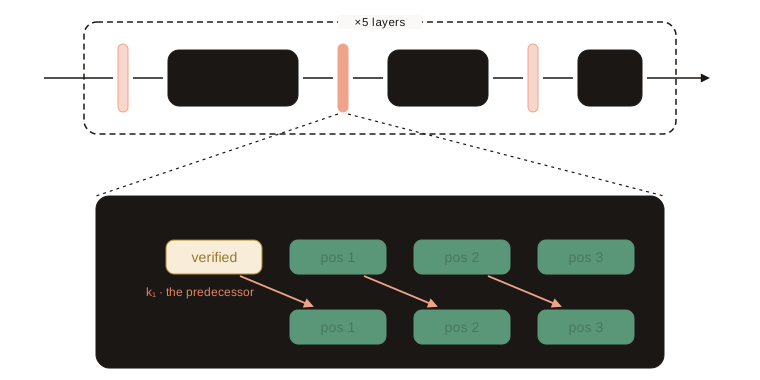
图源:DFlash 2 官方技术博客,Figure 4。截至本文核对日期,官方项目的 DFlash 2 资料指向这篇技术博客,未找到独立论文 PDF;这里提取其原始 SVG,并固定浅色配色以便独立显示。图中的 ×5 layers 属于作者展示的模型实例。下半图连接的是各位置的 hidden 表示,不是等待前一个位置采样出的 token,因此能保持并行执行。
以两 tap 为例,当前位置读取当前和前一个位置的 hidden:
其中 为 channel, 是所属 channel group;基础系数可以逐 channel 存储,动态增量按组共享。所有位置的上一层 hidden 已知,所以这种 causal 卷积可以并行执行,不必等待前一个位置先选出离散 token。
DFlashGroupedConv 用子层输入产生 input/output 两侧的动态系数,prepare() 在子层前卷积,finish() 在子层输出后卷积;每个 proposal block 单独处理,边界补零,不连接不同训练 anchor。
初始化也体现了兼容性:基础 kernel 从 identity 开始,动态 projection 从零开始。新组件启用时先接近原来的 DFlash,避免随机扰乱 backbone。这里的“causal”约束是新增局部混合只看左侧;不能据此推断整个 full-attention backbone 也已变成自回归模型。
6.4 SpecForge:DFlash objective 加严格 top-K selector CE
SpecForge 没有要求选择一个新的 training.strategy=dflash2。当前 DFlash registration 同时接受 DFlashDraftModel 和 DFlash2DraftModel,训练 wrapper 仍是 OnlineDFlashModel,模型 architecture 决定是否存在卷积和 selector。
训练主线为:
根据 SpecForge 的公开训练实现重绘,这是该框架的 recipe,不能当成作者 checkpoint 的完整训练配方。图中两条监督路径各有职责:主 objective 改善候选覆盖,selector CE 改善候选已覆盖时的选择;真值不在 top-K 中时,跳过的是该位置的 selector 损失,主 objective 仍然有效。
对真实目标 token ,selector 项可概括为:
主 token objective 继续训练 backbone;selector objective 的权重由配置和训练进度控制。当前 _selector_chunk_terms() 有三个直接影响结果的设计:
- 不把漏召回的目标 token 强行插入 top-K。 训练使用与 serving 一样的真实候选集合,目标缺席时该位置不贡献 selector 梯度;这类错误交给 backbone 改善。
- 前驱使用真实训练 token。 推理却使用刚选出的 token,因此 teacher-forced selector accuracy 和实际走完整条路径的 acceptance 必须分别看。
selector_stop_gradient可配置,默认是 false。 设为 true 时,只对 selector objective 输入的 hidden/unary logits 做 detach;主 DFlash loss 仍正常更新 backbone。warmup/ramp 也是可选配置,不能描述成必然先训 DFlash、再冻结它单独训 selector。
模型初始化还有一条兼容性设计:SpecForge 的 CandidateSelector 对前驱 codebook 用正态初始化,后继 codebook 却零初始化,注释给出的理由是让 transition 以 no-op 起步——“a fresh DFlash2 selector is numerically identical to the unary DFlash proposal”;后继因子先学到非零值,另外两个双线性因子才收到信号。这与 6.3 里卷积的 identity/zero 初始化是同一策略:新组件启用时先不改变原 DFlash 的行为,避免随机初始化扰乱 backbone;也意味着在 DFlash1 权重上挂接新 selector 不改变初始行为,热启动微调因此是安全的。
训练指标因此至少要拆成候选 coverage、候选已覆盖时的 conditional accuracy,以及真实 greedy walk 的 serving accepted length。把“正确答案已经在候选里时的选择准确率”当成端到端准确率,会系统性忽视 recall 的上限。objective 与诊断实现已经分别统计这些量。
当前 Qwen3.8-27B 的示例配置使用 block_size=8、selector_top_k=16、selector_rank=256、两 tap、group size 16,并声明了 sliding attention。这些值用于说明配置如何驱动实现,不应推广成 DFlash 2 必须使用的固定网络。
6.5 SGLang:复用 DFLASH worker,但 sampling 必须带上 selector 的 q
SGLang 的 DFlash2DraftModel 继承 DFlashDraftModel,仍用 --speculative-algorithm DFLASH。worker 检查 candidate_selector 后,在 draft forward 后进入 selector 路径;prefill、target verify 和 target-hidden KV commit 沿用 DFlash 主体。
compute_candidates() 得到 top-K IDs 和 unary scores,build_lattice() 并行构造邻接分数,sample_path() 返回选出的 token,以及沿实际路径使用的每一行条件概率 q_rows。
根据官方博客 Figure 1 与 selector 说明,对照 build_lattice() / sample_path()重绘。为看清关系,下半图只画 3 个位置、每位 3 个候选,候选编号仅作示意;真实 K 由 checkpoint 配置决定。细线表示可以提前并行打分的候选对,粗线表示依据已选前驱逐步走出的路径。图右补充了 walk 的逐步语义:step 0 前驱固定为 anchor;greedy 行取 argmax 且 q 为 one-hot, 行沿逆 CDF 采样且 q 为该行实际概率。target 收到的是粗线上的一条链,不是整张 lattice;KV 提交仍沿用前面的 DFlash 流程。
随机验证时,_selector_sampling_accept() 将这个稀疏候选分布按 candidate_ids scatter 到 target 词表坐标,再交给拒绝采样。候选外的 为零,但 target 仍可通过残差分布输出这些 token,因此 top-K proposal 不会直接把最终 target 输出限制在 top-K 内。worker 中的 proposal 与 acceptance 分支将这两者明确分开。
源码还在 finally 中把 scatter 的位置清零,因为缓冲区跨轮复用,下轮候选集合可能不同。“本轮 q 只有 K 个非零位置”同时是数学契约和内存生命周期契约:若旧位置没有清掉,验证计算的就不再是实际 proposal 分布。
还有一个需要明确的支持边界:当前 _validate_phase1_sampling_support() 对部分 build/device 的非 greedy 不可用情况,会警告并退回 greedy 验证,selector 分支的警告明确指出请求的 sampling distribution 不再保持。因此部署验证必须检查实际后端分支;论文的 lossless 结论不能覆盖这种 fallback。
7. 把 SpecForge 的训练全流程串起来
前面解释了每种算法怎样把张量变成 loss。接下来还需要回答:张量来自哪里、谁管理它们、checkpoint 怎样交给 SGLang。
7.1 当前入口是一套 trainer,算法与部署拓扑分别选择
当前公开入口是:
specforge train --config run.yamltyped config 的 training.strategy 选择算法,model.draft_model_config 选择 draft architecture,data 和 deployment 字段再决定读取已有 feature 文件还是消费在线 capture。不是每种组合各有一份独立的训练主循环。CLI与runtime 架构说明定义了当前路径:
配置解析 + AlgorithmRegistration
  → 构建 topology、feature store、数据源、draft model、strategy
  → Trainer.fit()
  → FeatureDataLoader 产出 TrainBatch
  → TrainerController 控制 epoch / step / checkpoint / ack
  → TrainerCore.train_step()
  → DraftTrainStrategy.forward_loss()
  → backend backward / gradient accumulation / optimizer.step()
  → 保存训练状态与可导出的 draft 权重
旧教程中以某个 scripts/train_*.py 为中心的调用链可能已经过时。本文使用该快照的 specforge train,各算法的 wrapper 名字则仍可能保留旧的 Online 前缀。
7.2 数据准备:首先对齐文本模板与监督区间
训练数据首先经过 target tokenizer 和 chat template,形成 input_ids、attention mask 与 loss_mask。对话中的 user/system 内容通常作为上下文,哪些 assistant token 参与 loss 由数据处理规则决定。
这里的真实风险不是 JSON 能否读入,而是训练生成的 token 序列是否与部署一致:special tokens、工具调用模板、thinking 开关、截断策略或 tokenizer revision 的变化,都可能让 drafter 学到另一种上下文分布。
然后冻结 target,对干净序列做 causal forward,采集算法需要的 target 表示。在线 capture 不等于所有训练样本都由服务自由生成。 当前 adapter 向外部 capture server 发送模型输入,让它执行并提取张量;数据 token 来自已有回答还是先前 rollout,属于上游数据构建策略。inference plane 设计明确区分了 transport/capture 与算法训练。
7.3 Feature contract 比“拿到 hidden states”更具体
| 算法 | draft 条件 | 额外监督表示 | 容易混淆的地方 |
|---|---|---|---|
| EAGLE-3 | 多层 auxiliary feature,归一化后的训练字段为 hidden_state | target,当前契约可由 target final hidden 经冻结 head 得到 teacher logits | 原始 offline 文件中的 hidden_state 与 wrapper 中同名字段语义不同 |
| DFlash | hidden_states,用于 context KV injection | 数据 token 即可支持默认 CE | context 里不能暴露 anchor 及其未来的 target feature |
| DSpark | hidden_states | target_last_hidden_states,用于 L1 和 confidence label | teacher hidden 要按 label 的前一位置索引 |
| DFlash 2 | 与 DFlash 一样的 context features | 数据 token、其真实前驱及 strict top-K 中的 label | selector 没有独立的 target backbone,也不能解决未召回 token |
以 EAGLE-3 为例,normalize_offline_sample()将磁盘里的 aux_hidden_state 映射为训练输入 hidden_state,将磁盘里的 final hidden_state 映射为 target。只按字段名猜含义,很容易把三层条件和最后一层监督互换。
多层 capture 的顺序同样是 checkpoint 接口。即使拼接后的总维度相同,把 [low,mid,high] 换成 [high,mid,low],FC 仍能执行,语义却完全变化。因此要核对 layer ID、输入/输出采集位置、norm 和投影,而不是只检查 tensor shape。
7.4 Offline 与 online disaggregated 的区别是数据生命周期
Offline colocated 读取预先生成的本地 feature 文件,用固定 SampleRef 列表组成可重复遍历的数据集;offline disaggregated 则把既有特征发布到共享目录或 Mooncake,并提供静态 manifest。这两种方式可以围绕同一批 feature 做多个 epoch。
Online disaggregated 中,外部经过适配的 SGLang capture server 直接把 feature tensor 写到 Mooncake,producer/控制面传递的是样本 ID、key、shape、dtype 等元数据,trainer 再取张量。不能把任意普通 SGLang server 当成兼容的 capture server;应使用该版本 recipe 指定的 capture 支持。
训练文本 → capture 请求 → SGLang target forward
                              │
                       feature tensors
                              ↓
                           Mooncake
                              │
SampleRef → rank 0 分发 → 各 rank FeatureDataLoader
                              ↓
                       TrainBatch + algorithm loss
                              ↓
                      optimizer boundary + ack
                              ↓
                         feature 清理
控制面不转发大 tensor,是为了避免数据绕经 producer 内存并让元数据队列承担不必要带宽;相应代价是必须严肃处理 ack、对象保留和重试。当前实现由 consumer rank 0 维护 durable ledger,每个 optimizer boundary 汇总各 rank 的样本确认,再清理对应 feature。runtime 架构与 ack 时序解释了这套所有权。
多 rank 还要求按完整 optimizer window 分发,基本量子为:
若生产侧 in-flight 容量不足以容纳 ,就无法稳定推进一个完整全局 step。当前 online stream 是 consume-once:多个 epoch 表示 producer 创建新的样本 pass,而不是 consumer 对已经删除的张量再遍历一遍。
7.5 Backward、checkpoint 与导出
TrainerCore 与 training backend负责梯度累积、非边界 microbatch 的 no_sync()、梯度裁剪和 optimizer step。TrainerController 只在实际 optimizer boundary 推进 global_step,再执行 ack 和定期保存。
训练 checkpoint 与 serving model directory 也不同。前者包含恢复所需的 optimizer/RNG 等状态,后者应具备模型配置、draft 权重及必要映射。各 strategy 的 checkpoint_state_filter() 负责筛选 draft 状态,export 层再转换布局。
例如,准备好与配置匹配的 feature 数据后,可以先查看启动计划,再执行训练。以下命令来自当前 CLI 形式,路径指 SpecForge checkout:
# 只解析并显示拓扑,尚不启动训练
specforge train --config examples/configs/offline/colocated/qwen3-8b-eagle3-offline.yaml --plan

# 真正执行;此前必须准备好配置所指的数据、target 权重和 vocab mapping
specforge train --config examples/configs/offline/colocated/qwen3-8b-eagle3-offline.yaml导出命令的形式如下,CHECKPOINT_PATH 等均是待替换的实际产物路径,不是本次写作已经生成的权重:
specforge export --to sglang \
  --checkpoint CHECKPOINT_PATH \
  --draft-config configs/qwen3-8b-eagle3.json \
  --vocab-mapping VOCAB_MAPPING_PATH \
  --output-dir EXPORTED_DRAFT_DIR
DFlash/DSpark 等按各自配置导出;没有词表裁剪时不要照搬 EAGLE-3 的 mapping 参数。DFlash 2 尤其需要同时导出 convolution、codebook、hidden projection 及对应 config。权重名称兼容使迁移更直接,但不会替代一次实际 serving parity 检查。
8. SGLang 的共同底座:提交前缀、KV 生命周期和 overlap
8.1 一轮真正保留的是哪些 KV
回到开始的例子。target 已处理 A B C,anchor 为 D,draft 提出 E F G H。验证发现 E/F 可以接受,G 应替换为 X:
| 项目 | 本轮之后的内容 |
|---|---|
| 本轮 target verify 输入 | D E F G H |
| 本轮新输出 | E F X;D 已在上轮输出 |
| 新增有效 target KV | KV(D), KV(E), KV(F) |
| 不可作为历史的临时 KV | KV(G), KV(H) |
| 下一轮 anchor | X |
| 下一轮开始前尚缺的 target KV | KV(X) |
X 是处理 F 那一行时生成的结果;target 没有以 X 为输入执行,因此不能把被拒绝 G 的 KV 改个 token ID 当成 X 的 KV。
接受了 个草稿,新输出数与新增有效 KV 数恰好都是 ,但对应的 token 集合不同:输出是 [E,F,X],KV 是 [D,E,F]。这就是 commit_lens 容易让人误读的原因。
下一轮从有效 KV 前缀 A B C D E F 与 anchor X 开始。对 DFlash 类 worker,draft context KV 同样只接收这三个已执行位置的 target hidden;对 EAGLE,draft extend 用对齐后的 token/feature 更新自己的状态。
8.2 逻辑回滚不必等于立刻物理 free
SGLang 将“已经确认有效”和“已经预留容量”分开维护。当前请求字段位于 req.kv 中:
kv_committed_len描述已经提交的 KV 边界。kv_allocated_len描述已分配容量的边界,可覆盖尚未有效的 speculative 空间。- GPU 上的
seq_lens描述当前执行路径使用的长度;overlap 下,CPU bookkeeping 可能滞后于设备结果。
因此一般有:
拒绝发生后,首先必须保证后缀不再对 attention 可见;物理槽位可以保留供下一轮复用,或按 allocator、page、回收时机释放。原文“rejected KV 一律到请求结束才释放”应收窄为某条预分配执行路径的行为,不能作为所有模型、后端和版本的统一规则。当前 ScheduleBatch 的容量管理和result processor 的提交逻辑分别负责这两个层面。
连续链的接受前缀天然位于前面,树结构却可能接受压平数组中不连续的节点。当前 EAGLE 的 _finalize_accept_tree_path() 对 topk>1 进行 compaction,使 KV、hidden states 和预测结果对齐;topk=1 无需做这种树路径搬移。公共 verify 实现明确保留了这个分支。
同样的 slot index 也不意味着 target/draft 共享了 KV 数值。两个模型可以借用相同逻辑索引与分配计划,但各自持有不同层数和布局的 KV buffer。DFlash 的 target-hidden projection 正好说明:它们共享位置语义,不共享任意 attention layer 的数值。
8.3 混合模型还可能有 KV 以外的状态
对纯 Transformer,关注 token history 与 KV 已经能解释大部分回滚。对于带 recurrent/linear-attention 状态的 hybrid target,只缩短 KV 长度不够:未接受 token 可能已经推进了额外状态。
当前 EAGLE 的 commit_mamba_states_after_verify()、DFlash 的 _update_target_mamba_state_after_verify()、DSpark 对应的 commit 路径,就是为了把非 KV 状态也落到接受边界。不能由“某个算法支持线性链验证”直接推断它支持任意 hybrid target;需要该模型的完整状态提交适配。
8.4 Overlap 隐藏的是等待,不会消除依赖
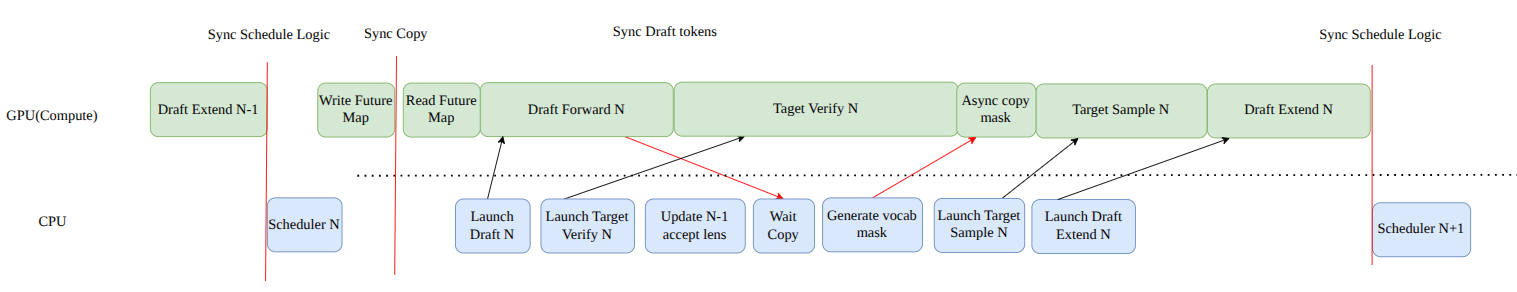
原文围绕 grammar constrained decoding 的观察仍然重要。验证阶段既有 GPU 上的 target forward,也有 CPU 上的 grammar 状态推进与词表 mask 构造,两者可部分重叠:
draft 候选与树结构就绪
  ├─ GPU:target verify forward → logits ──────────┐
  └─ CPU:取得树结构 → 推进已接受 grammar → 构造 mask ┤
                                                   ↓
                                       apply mask → sample
                                                   ↓
                                         提交输出与下轮状态
当前 run_eagle_verify() 在 target launch 前建立 GrammarTree,target forward 后构造 grammar vocab mask,再交给 eagle_sample()。plan stream 与 compute stream 之间的 wait_stream() 则保护 draft 产生的 metadata 与 verify 消费它的先后关系。
这里有三个不能跨越的依赖:
- 生成本轮 grammar mask 前,必须已经应用此前实际接受的 token。
- 树或链的候选结构必须对 mask 构造者可见,不能读尚未完成的设备到主机拷贝。
- sampling 必须读取应用了正确 grammar 与采样处理后的 target 分布。
在 DSpark 的当前实现中,live grammar 会关闭某些将 acceptance 折叠到 CUDA Graph 内的路径,因为图内 epilogue 不能绕开图外生成的 mask。DSparkWorkerV2 的 fold_eligible 判断让这种约束直接体现在代码中。
所以优化 overlap 时真正的问题不是“哪里可以删一次同步”,而是生产者何时完成、消费者在哪个 stream/线程读取、复用缓冲区何时安全。DFlash 2 的 q_rows 清理、DSpark 的历史 confidence generation、EAGLE 的 verify buffer keep-alive,都是同一类生命周期问题。
9. 从训练结果到 serving:如何判断一次改进是否成立
9.1 四种长度必须分别记录
训练 block length、draft proposal length、target 验证行数、最终输出数不是同一个指标。
| 方法与典型配置 | Draft query 数 | 新 proposal 数 | Target verify 输入预算 |
|---|---|---|---|
| EAGLE tree | 随 frontier 与深度变化 | 树中的候选,不是一条等长链 | speculative_num_draft_tokens 个树节点,包含 root |
DFlash block_size=8 | 8 | 7 | 8 |
DSpark 默认 anchor-predict,block_size=7 | 7 | 7 | 8,开启调度时各请求可缩短 |
DFlash 2 block_size=8、top_k=16 | 8 | 7;每位置先保留 16 个候选 | 8,最终只验证选出的一条链 |
尤其不要把 DFlash 2 的候选 lattice 当成 EAGLE tree:selector 内部虽有多条可选路径,target 收到的仍然是选好的一条链,并没有同时验证每个位置全部 16 个候选。
SGLang 的 DSpark 参数解析显式计算 gamma = speculative_num_draft_tokens - 1;draft query 的数目还取决于 sample_from_anchor。参数解析比变量名字更可靠。
9.2 训练指标要对应部署的失败方式
| 观察到的现象 | 优先检查的机制 |
|---|---|
| EAGLE-3 第一步好、深处迅速下降 | TTT 深度、递推状态接口、token/teacher shift、训练 mask |
| DFlash 各位置 loss 很低,上线 acceptance 差 | 是否泄漏 anchor target feature、模板/采样差异、是否只测 teacher-forced 指标 |
| DSpark confidence 很高、实际尾部常被拒绝 | 校准数据、STS 适配长度、teacher 分布与部署采样配置、累计概率偏差 |
| DFlash 2 conditional selector accuracy 很高,整体收益小 | strict top-K coverage、自由 walk 与 teacher forcing 的差异 |
| acceptance 提高但 token/s 下降 | draft/selector 成本、KV commit、verify 实际执行行数和 graph tier |
| 输出 token 看似对齐,后续生成逐渐异常 | 接受路径 KV、bonus 未执行状态、recurrent state 和词表映射 |
其中一个很有用的判断是:DFlash 2 若 coverage 已经高、conditional accuracy 低,可以改 selector;若 coverage 本身持续下降,继续堆 selector 参数不会把答案变回候选,只能从 backbone、局部依赖或数据分布入手。
9.3 先比较一轮的成本,再比较完整 workload
下面是仅用于说明成本公式的假设数据,不是论文或本次测量结果;总耗时已包含 draft、verify、采样与状态开销:
| 方案 | 每轮总耗时 | 平均新输出数 | 摊销时间 |
|---|---|---|---|
| 方案 A | 9 ms | 6.0 | 1.50 ms/token |
| 方案 B | 6 ms | 4.8 | 1.25 ms/token |
| 方案 C | 6.5 ms | 5.8 | 1.12 ms/token |
方案 B 的 acceptance 较低,却仍然更快。反过来,selector 改善 ,也需要补偿 top-K、评分和采样增加的时间。
完整评估至少要记录 target/draft revision、量化、attention backend、硬件、TP/DP、上下文与输出长度、batch/concurrency、sampling 和 grammar 设置。分别报告 TTFT、TPOT、吞吐与有效输出长度,再拆分 draft、verify、KV/context update 的时间。
训练 epoch 中测到的 acceptance proxy,不能代替 serving benchmark;一个空载单请求结果,也不能推导饱和系统的总吞吐。跨论文引用“最高几倍”时,如果 baseline、模型和 workload 不同,数字不构成可比较的演进曲线。
9.4 有哪些明确的反例
短输出可能不值得投机。 prefill、drafter 初始化和额外状态准备尚未摊销,请求就已经结束。首字延迟与稳态 TPOT 应分开分析。
高并发下扩大验证长度可能损失吞吐。 draft 生成得便宜,不代表 target 验证得便宜。DSpark 把总预算交给负载相关的 cost model,正是处理这种收益反转。
长上下文可能让 persistent context 变贵。 target feature capture、传输、draft KV 容量与 attention 读取都会增加。DFlash 的单次 parallel forward 不能消除这些随上下文变化的成本;滑窗可以降低成本,但必须与训练和模型配置对齐。
大词表可能让轻量 head 成为显著开销。 DSpark 的低秩修正仍产生全词表 logits;DFlash 2 要做 top-K,并存储 codebook。理论上减少序列 backbone 次数后,新的瓶颈可能出现在这些原先不起眼的环节。
有 fallback 的 sampling 不一定保持请求语义。 使用 greedy 路径验证 greedy、正确随机路径验证 sampling,是两种不同的检查。accuracy 接近本身不是分布保持的证明。
9.5 一个从训练到部署的核对顺序
- 固定 target/tokenizer revision 与数据模板,确认 feature capture 的层、顺序及 norm。
- 检查一小批样本的 token/feature/label 对齐和有效 mask,尤其是 anchor 边界。
- 对 EAGLE 看逐 TTT 深度指标,对 DFlash 看逐位置指标,对 DSpark 看分布重叠和校准,对 DFlash 2 同时看 coverage 与路径 acceptance。
- 导出模型,核对配置和权重完整性;DSpark 另准备与实际 workload/backend 匹配的 confidence 校准及成本表。
- 先验证 greedy 输出与状态提交,再验证随机分布和约束输出分支,最后测多种并发与上下文长度的端到端成本。
例如,一个已有兼容 DFlash 2 导出目录的 serving 命令形态是:
python -m sglang.launch_server \
  --model-path TARGET_MODEL_PATH \
  --speculative-algorithm DFLASH \
  --speculative-draft-model-path EXPORTED_DFLASH2_DIR \
  --speculative-num-draft-tokens 8
这里的 8 表示上述典型配置的验证 block 预算,真正 proposal 为 7。该命令展示参数接口;是否能直接运行,仍由 target/draft 配对、模型配置和后端支持决定。
10. 保留原文实验:EAGLE + Grammar 的 overlap 优化
原文在 2025-12-23 记录过约束解码与投机解码的 overlap 实验。核心观察是:处理上一轮已接受 token 的 grammar 状态,以及根据当前 draft 构造词表 mask,都有机会放到 target verification 的执行窗口里。
原来的时序图如下:
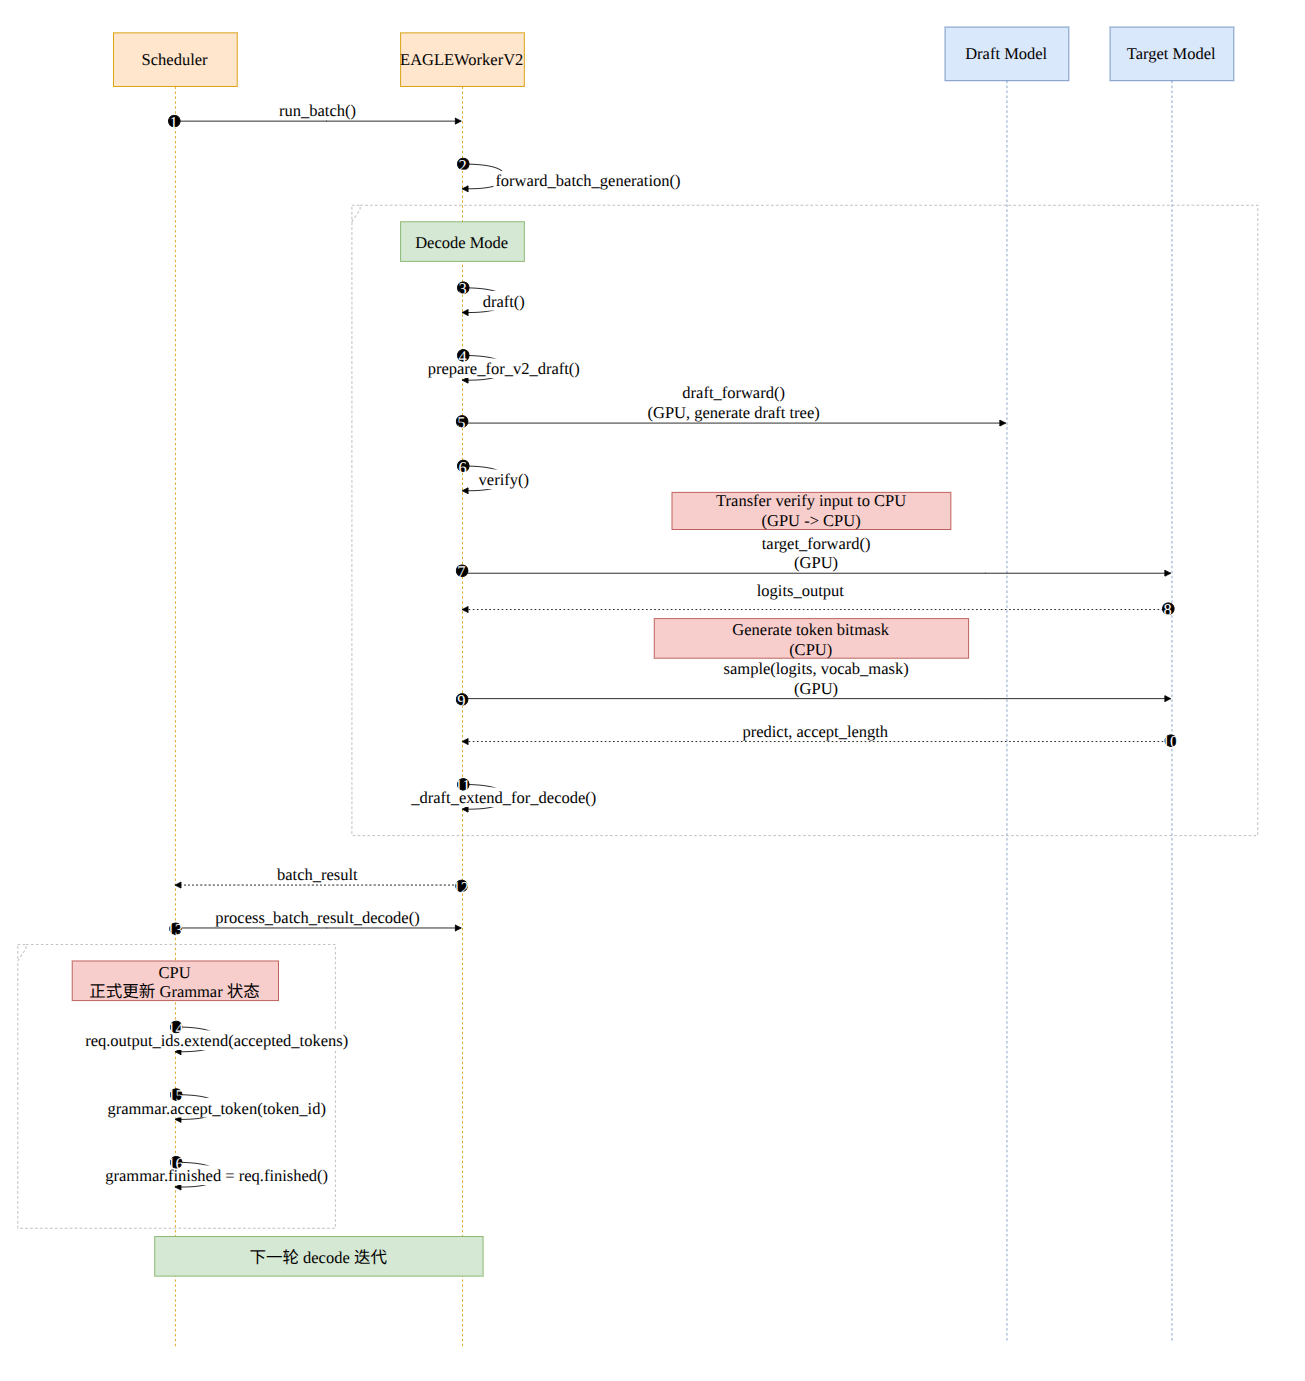
图中需要关注的是从 draft tree 到 CPU grammar mask、再到 GPU sampling 的依赖,而不是把所有 CPU 工作都串在 GPU forward 之前。
原始与优化后的执行示意分别为:


优化思路是异步取得 verify 输入,在 target 执行期间处理上一轮 grammar accept,再构造本轮 mask。sampling 仍然等待 mask 就绪。原文代码中的 last_batch_accept_tokens、grammar_accept_processed 是当时原型的组织方式,不应当作当前 commit 的稳定 API。
10.1 原始观测值
| 测试场景 | No Overlap | Overlap Double Sync | Overlap Once Sync |
|---|---|---|---|
| JSON Generate | 0.8557 s | 0.7296 s | 0.6687 s |
| JSON OpenAI | 0.4455 s | 0.2549 s | 0.3861 s |
| Mix Concurrent | 0.6386 s | 0.5623 s | 0.5468 s |
原文另外记录了 batch size 4 的 TPOT 从 4.07 ms 降至 3.22 ms,TTFT 从 21 ms 增至 27 ms,平均 acceptance length 从 2.59 变为 2.9。
还有一次 GSM8K 观测,命令参数为 --num-shots 8 --num-questions 1319 --parallel 1319:
| 指标 | No Overlap | Overlap |
|---|---|---|
| Accuracy | 0.232 | 0.230 |
| Invalid | 0.003 | 0.003 |
| Latency | 44.037 s | 36.554 s |
| Output throughput | 3763.649 token/s | 4559.657 token/s |
以上只作为历史实验记录保留。原文未给出完整 target/draft checkpoint、硬件、软件 commit、全部采样参数及重复次数,本次也没有重测,不能用它们预测当前版本收益,更不能用 accuracy 接近证明实现严格无损。
10.2 Acceptance 变化是待解释的问题
我仍然保留原文的疑问:仅改变 overlap,为什么 acceptance length 会从 2.59 变为 2.9?如果模型、输入、候选构建与验证语义完全相同,单纯移动执行时序不应被直接当作模型预测变准的原因。
应依次核对请求混合、输出长度、随机数消费顺序、计数口径、grammar 状态更新时间和候选 mask。TTFT 增加也可能来自初始化或额外调度开销,但缺少 profile 时只能作为假设,不能写成已经证实的归因。
这组记录能够支持的工程结论是:CPU grammar 与 GPU verify 存在可重叠的窗口;要把它转化成可信性能结论,还需要把正确性、负载和统计口径固定下来。
11. 演进回看:训练在定义信息边界,推理在兑现成本收益
| 方法 | 训练重点 | Draft 执行 | 验证和状态管理重点 |
|---|---|---|---|
| EAGLE | feature regression + token prediction | feature 与提前一位 token 驱动自回归 | 静态树、tree attention、接受路径 |
| EAGLE-2 | 复用 EAGLE draft 训练 | confidence 驱动 expand/rerank | 动态树预算和祖先闭包 |
| EAGLE-3 | 去除 feature loss,多层条件,TTT | 可信 target feature 起步,自生成 latent 递推 | verify 后 draft extend,训练/执行状态对齐 |
| DFlash | 随机 anchor、masked blocks、位置加权 CE | 一次 block forward,每层 context KV injection | 线性 verify,按提交前缀更新 draft context |
| DSpark | block 训练 + CE/L1/confidence,另做校准 | 并行 backbone + Markov/RNN 序列头 | 保存修正后的 q,confidence/SPS 预算,ragged verify |
| DFlash 2 | DFlash objective + strict top-K selector CE,卷积参与训练 | 带局部卷积的 backbone + 并行候选评分 + 因果 walk | 使用 selector 的实际 q,复用 DFlash 状态提交 |
对我来说,这条演进最值得迁移的认识有三个。
第一,target feature 是训练与推理之间的契约。 它在何时可用、哪些位置可见、怎样投影,决定了 drafter 能利用什么信息。TTT、anchor mask、KV injection 都在处理不同形式的信息可用性。
第二,保留少量串行依赖未必妨碍低延迟。 EAGLE 把串行放在 backbone 深度推进中,DSpark 将其收缩到轻量 head,DFlash 2 再收缩到预计算候选分数上的 walk。要比较的是关键路径上留下多少工作,而不是是否出现一个 for 循环。
第三,接受长度必须与成本和状态一致性一起看。 好的 loss、较长的 proposal、较高的 conditional accuracy 都只是中间结果。只有验证预算、实际执行行数、有效 KV 和最终采样协议共同正确,才会得到稳定的 serving 收益。
SpecForge 负责把这些训练目标落实为数据契约、loss、梯度与 checkpoint;SGLang 负责把 checkpoint 落实为候选生成、验证、调度和状态提交。把两边连起来看,才能解释一个 drafter 为什么离线很好、上线却没有变快,以及下一次应该改数据、模型,还是执行系统。
Reference
论文与方法材料:
- Fast Inference from Transformers via Speculative Decoding
- EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty
- EAGLE-2: Faster Inference of Language Models with Dynamic Draft Trees
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test
- DFlash: Block Diffusion for Flash Speculative Decoding
- DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation
- DFlash 2: Keep Drafting Parallel
实现与源码阅读入口:
- SGLang:EAGLE worker、公共 verify、EAGLE-3 模型
- SGLang:DFlash/DFlash 2 worker、模型与 selector
- SGLang:DSpark worker、proposer、planner、verify executor
- SpecForge:runtime 数据流、训练职责、capture 边界
- SpecForge:EAGLE-3 TTT、DFlash/DSpark/DFlash 2 objectives、DFlash 2 模型
- EAGLE 官方实现、DFlash 官方实现、DSpark 官方 DeepSpec
原文背景阅读与站内关联: