刘芷溢
最近更新
FlashAttention v1-v4:从 IO 感知到异步流水与硬件协同
沿着 FlashAttention v1-v4 的论文、作者博客与源码,拆解 Ampere、Hopper、Blackwell 如何改变 attention 的数据路径、线程分工和瓶颈,并用调度图解释 copy、MMA、softmax 与输出校正如何真正重叠。
理解 H100:从硬件数据路径到 Nsight Compute 瓶颈分析
沿着 kernel 的分配、指令发射、访存与异步矩阵计算,建立 H100 的硬件工作模型,并把 Nsight Compute 的吞吐、调度、事务和依赖指标组织成可验证的瓶颈诊断方法。
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization 论文笔记
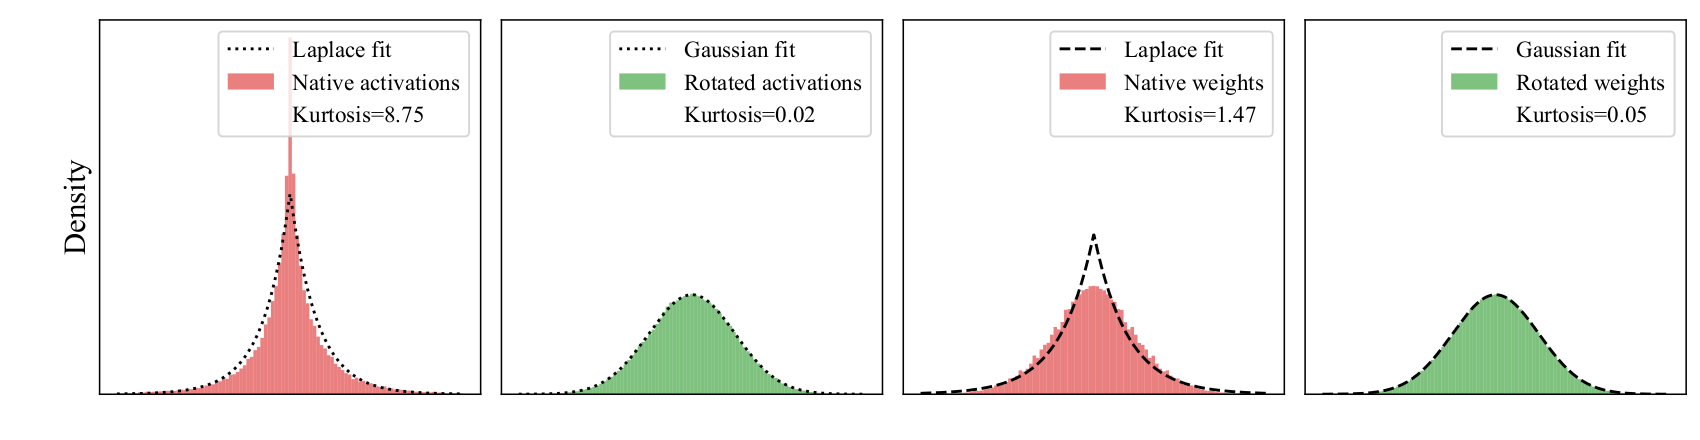
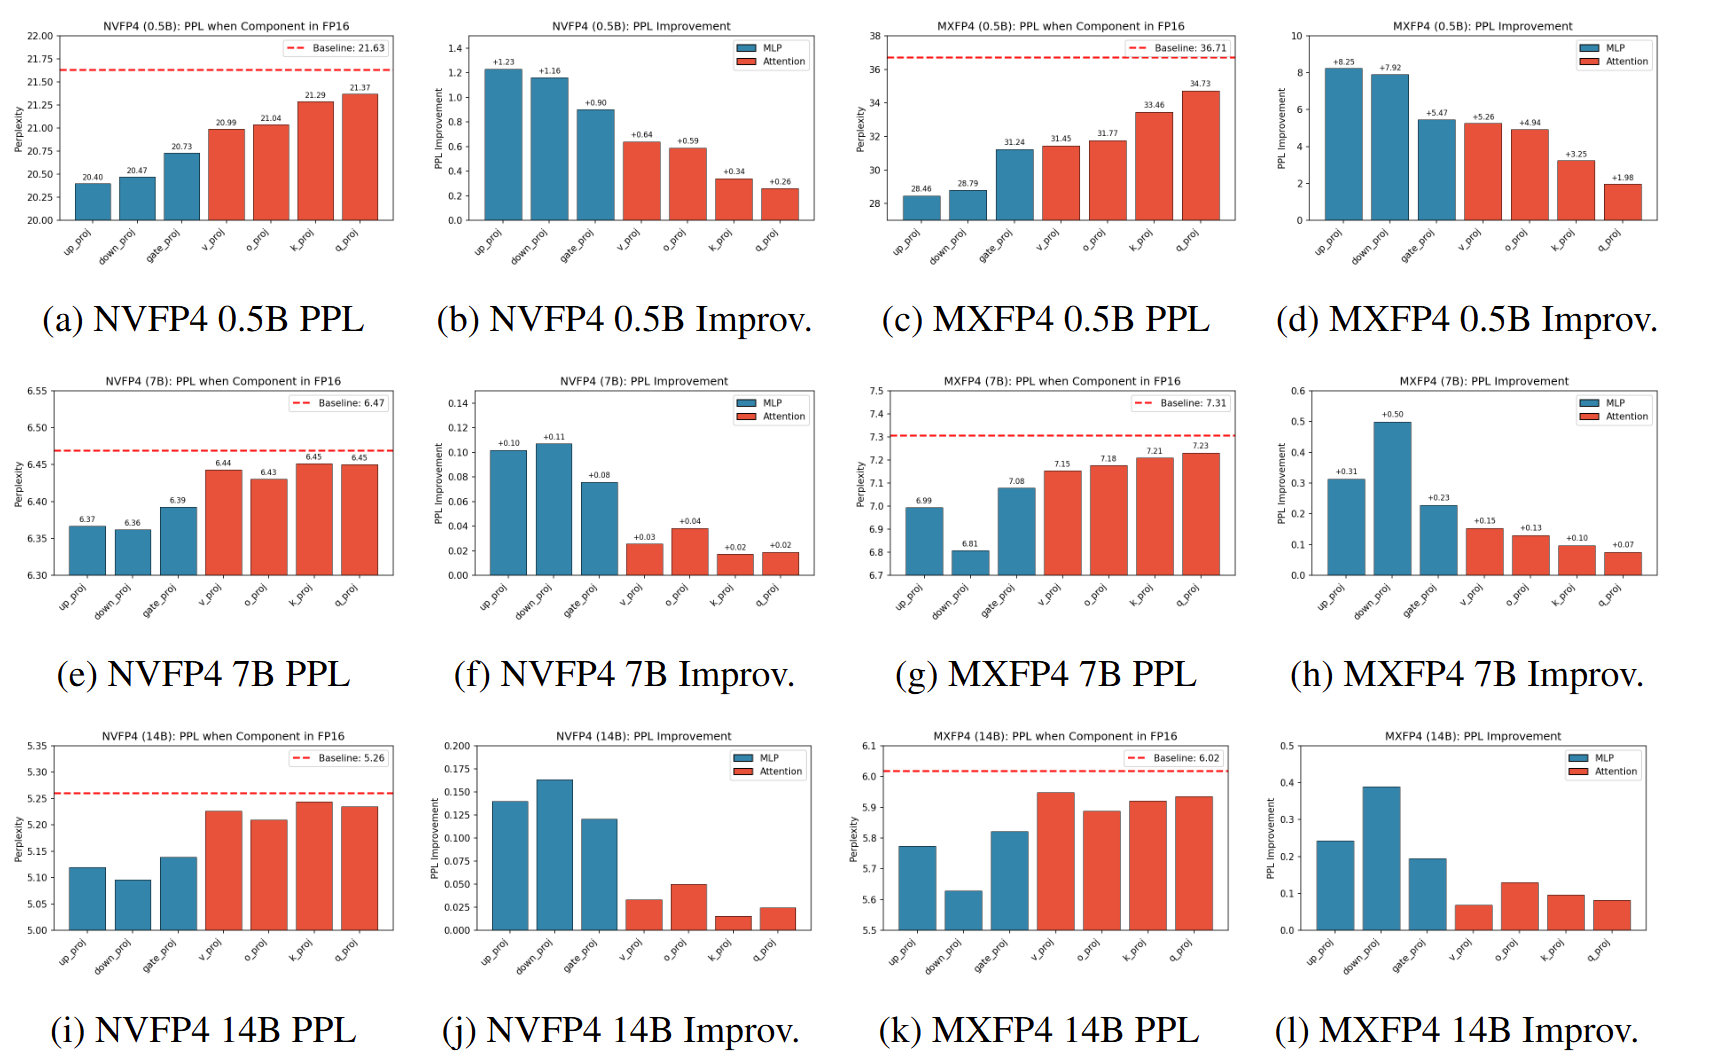
以格式、量化算法和 GPU Kernel 的跨层约束为主线,拆解 ICLR 2026 论文 Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization,解释旋转为何改善 MXFP4 却可能伤害 NVFP4、MR-GPTQ 如何修正这一矛盾,以及 QuTLASS 的真实收益与部署边界。
FP4、FP8 与 INT8/INT4:数值范围、块缩放与推理计算精度
从标量编码、共享 scale 与有效位宽出发,拆解 INT8、FP8、MXFP8、INT4、MXFP4、NVFP4 的表示范围,并沿 GEMM、GQA/MLA Attention 数据流解释 8 bit/4 bit 推理真正使用的乘法、累加、Softmax 与输出精度。
从 EAGLE 到 DFlash 2:SGLang 与 SpecForge 的投机解码训练和推理
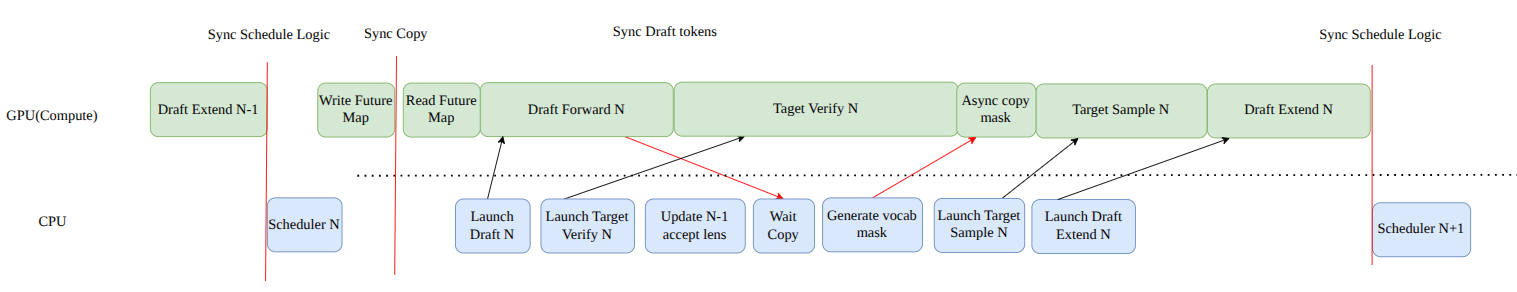
沿 EAGLE、EAGLE-2、EAGLE-3、DFlash、DSpark 和 DFlash 2 的演进,解释 draft 的训练目标、数据对齐、推理状态与验证预算,并对照 SpecForge 训练和 SGLang serving 源码串起完整流程。
README
CuTe FlashAttention-2 case-study benchmark This directory preserves the exact teaching kernel, benchmark harness, raw results, and figure generator used by the corresponding tom-jerr blog post.
CuTe 详解:以 FlashAttention-2 拆解 Layout、TiledCopy 与 TiledMMA
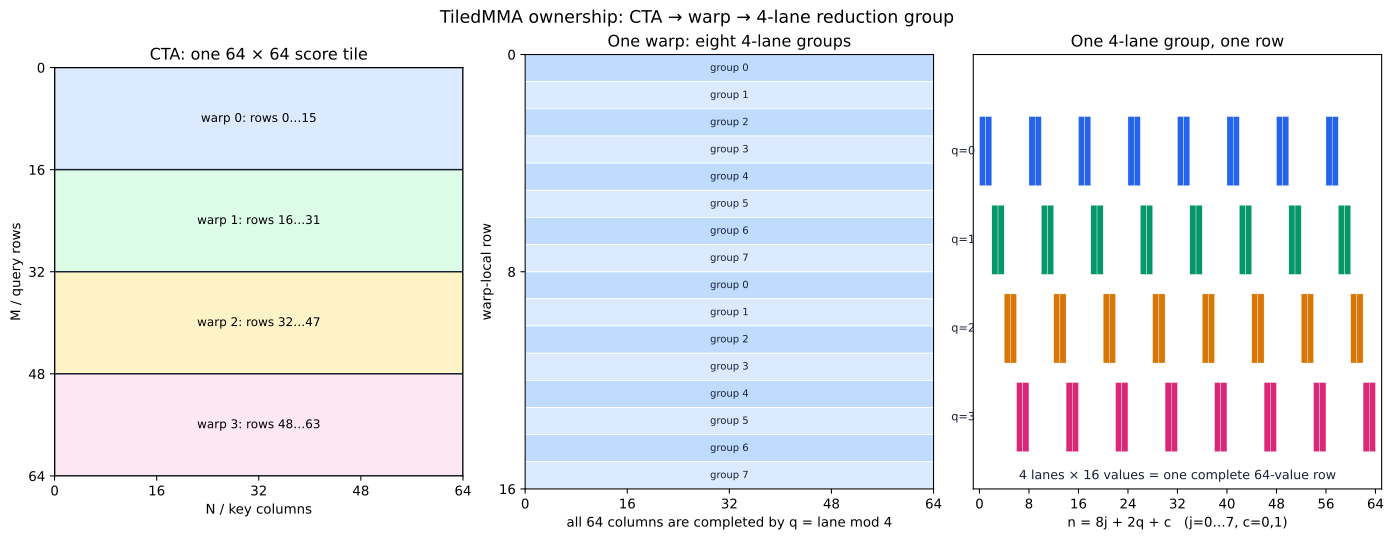
以一份可运行的 FlashAttention-2 前向 Kernel 为贯穿案例,从坐标函数和线程所有权出发,详解 CuTe 的 Layout algebra、Tensor、TiledCopy、TiledMMA、寄存器重解释与流水线,并用正确性和性能实验检查这些抽象最终生成了什么。
LLM 量化综述:数据格式、PTQ 与 QAT 的算法演进
从 INT8、FP8、INT4、MXFP4、NVFP4 的表示范围与舍入误差出发,按 8 bit、4 bit 和低于 4 bit 梳理 PTQ/QAT,解释各方法解决的问题、相对前作的创新、核心优化与数值稳定性,并对应到 llm-compressor 的工程实现。

sglang
11 篇文章
从 EAGLE 到 DFlash 2:SGLang 与 SpecForge 的投机解码训练和推理
沿 EAGLE、EAGLE-2、EAGLE-3、DFlash、DSpark 和 DFlash 2 的演进,解释 draft 的训练目标、数据对齐、推理状态与验证预算,并对照 SpecForge 训练和 SGLang serving 源码串起完整流程。
SGLang HiCache:组件、工作流与 L1/L2/L3 读写时序
从 HiRadixCache、HiCacheController、Host KV Pool 与 Storage Backend 的职责出发,沿 Scheduler 主循环拆解 L3 query、hit、prefetch、L2 load、L2 write 和 L3 write 的准确时序。
eplbopt
GRACE-MoE 优化 一种针对稀疏混合专家(SMoE, Sparse Mixture-of-Experts)模型在分布式多GPU集群上推理时的综合优化方案。SMoE模型的核心痛点在于:跨设备通信开销大与计算负载极度不均衡。 文中提出的三个核心Idea层层递进,形成了一个闭环:先通过分组减少通信(但加剧了负载不均衡),再通过复制缓解负载不均衡,最后通过路由在通信和计算之间找到最优的执行路径。 Core Idea 1.
PD Disaggregation in SGLang
本文将从为什么需要 PD 分离开始讲起,通过几篇论文来讲述现在 PD 分离演进的路线,以 SGLang 中 PD 分离的实现作为 example 进行解析;由于笔者之前做过分布式相关的项目,将其中的状态机与 Raft 浅浅做了以下对比。
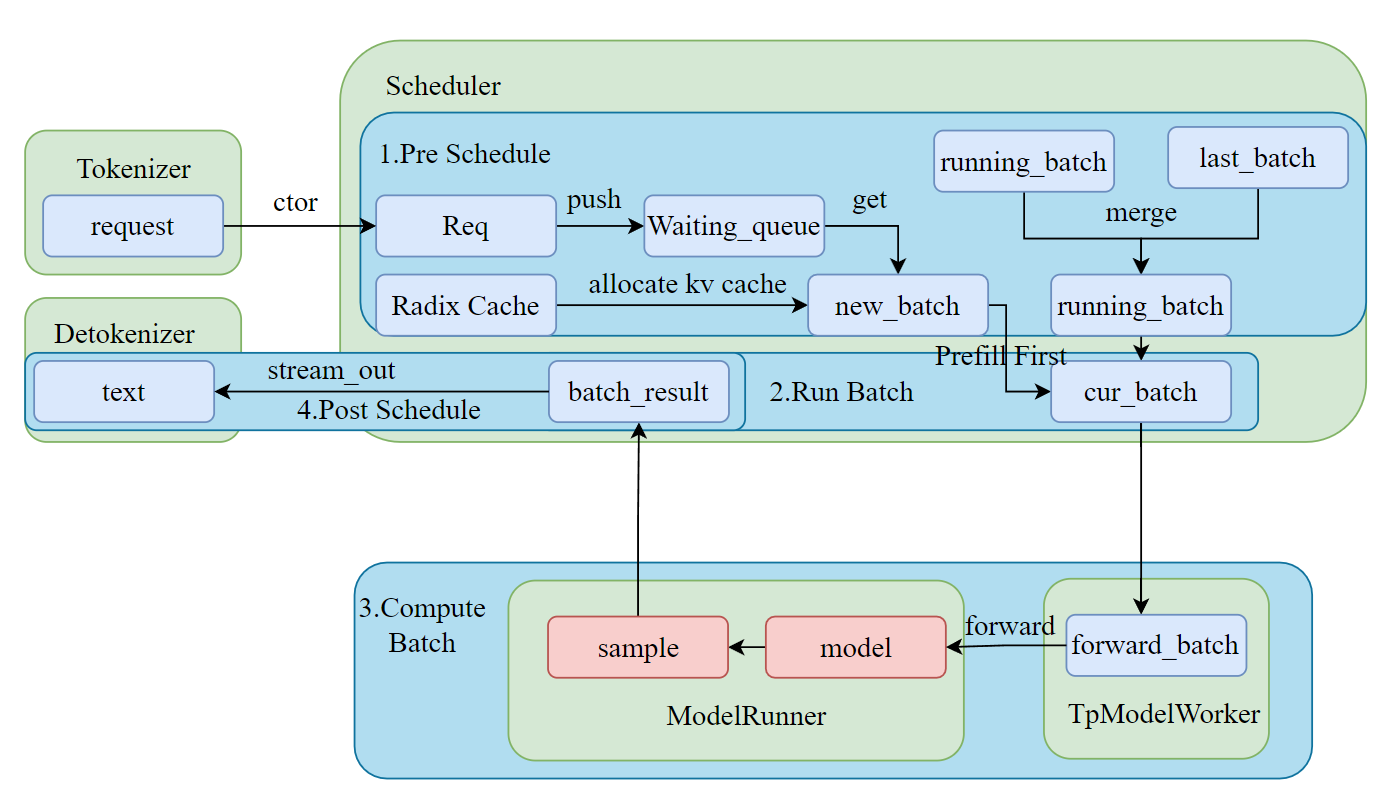
一条 Request 在 SGLang 的前世今生
本文将介绍在 SGLang 中,一条请求从到达系统到最终完成的全过程,涵盖请求的接收、调度、执行以及结果返回等关键环节。
RadixAttention 你需要知道的细节
本文深入探讨 SGLang 中 RadixAttention 的实现细节,涵盖 Radix Tree 结构、前缀匹配、内存管理与驱逐策略,以及 Cache-Aware Scheduling 的工作原理。
SGLang 中的 TP + PP 流程浅析(以 Qwen2 为例)
这里我们以 Qwen2 模型为例,开启 PP + TP 分析一下 SGLang 是如何实现模型推理的并行的
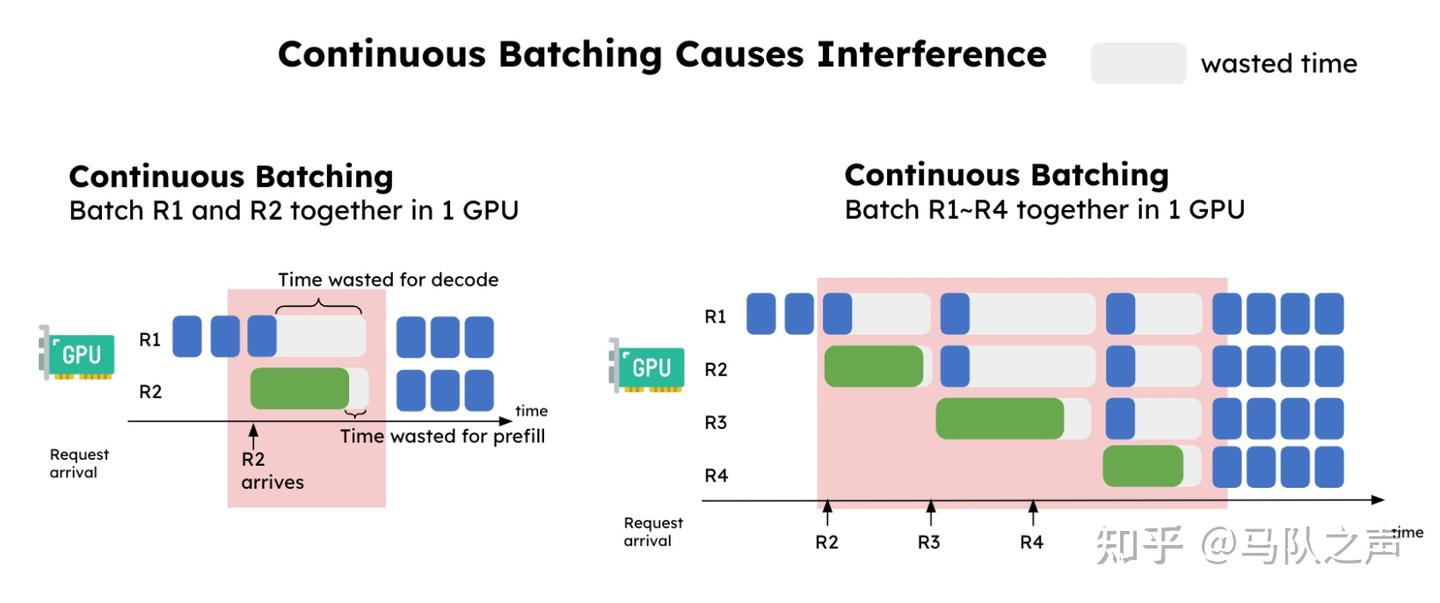
大模型推理服务中的 Batching
现在的大模型推理的框架基本都实现了 Continuous Batching,本文将从大模型推理服务为什么需要 Batching 开始,逐步讲解该领域的技术演进,包含调度层和计算层的相关优化技术。
从代码看 SGLang 的 KV Cache
本文将深入解析 SGLang 的 KV Cache 实现细节,介绍其组件结构、工作原理以及在模型推理中的应用。
SGLang Scheduler 技术变迁
本文将结合代码分析 SGLang Scheduler 的技术演进,介绍其核心数据结构和工作流程,帮助读者深入理解调度器的实现细节。
Data Parallelism in Attention in SGLang
本文介绍 SGLang 中 Attention 层的数据并行(DP Attention)机制,涵盖其设计理念、实现细节及执行流程,旨在提升模型推理的效率和性能。