
LLM 量化综述:数据格式、PTQ 与 QAT 的算法演进
理解量化,首先要知道一个数还剩下哪些合法取值,然后才能讨论怎样把模型放进这些取值里。INT8 和 FP8 都是 8 bit,却有不同的动态范围和误差形态;INT4、NF4、MXFP4、NVFP4 都与 4 bit 有关,但它们的格点、scale 和计算路径并不相同。
数据格式规定可表示范围、格点密度和特殊值行为,决定数值稳定性的基础边界;实际误差还取决于分组、scale、校准分布和运算精度。 所以,格式相同的两个模型也可能有完全不同的精度,格式更小的模型也未必推理更快。
接下来先讲格式,再把量化工作流分成 PTQ 与 QAT;随后分别讨论 8 bit、4 bit 和低于 4 bit。每种方法都围绕四个问题展开:前一种做法哪里不够、它改变了什么、核心优化如何实现、数值和部署代价是什么。旋转、蒸馏、混合精度和码本会放回对应工作流中解释。
1. 数据格式:量化误差与数值稳定性的起点
1.1 先分清存储位宽、计算位宽与累加位宽

图中的位域解释单个元素如何编码;用于张量时,还要加上 scale 和可能的 zero-point。W4A16 只表示权重采用 4 bit、相应 activation 采用 16 bit,没有规定它们是整数还是浮点,更没有规定 KV、累加器和输出的精度。
| 格式 | 未缩放的表示特征 | 对数值稳定性的直接影响 |
|---|---|---|
| FP32 | E8M23,最大有限值约 | 常用于统计、scale、参考计算及部分训练状态 |
| BF16 | E8M7,指数范围接近 FP32 | 不易因范围不足溢出,但尾数舍入仍明显 |
| FP16 | E5M10,最大有限值 65504 | 主体分辨率较细,但大 activation、梯度或倒数更易溢出 |
| INT8 | 有符号编码通常为 | 通过 scale 提供张量范围;格点等间距,异常值会拉粗步长 |
| FP8 E4M3FN | 4 位指数、3 位尾数,最大有限值 448,无 Infinity 编码 | 相对分辨率较好,范围小于 E5M2 |
| FP8 E5M2 | 5 位指数、2 位尾数,最大有限值 57344 | 更大范围换来更粗的相对分辨率 |
| INT4 | 有符号编码通常为 | 仅 16 个编码,范围与主体精度的冲突更突出 |
| FP4 E2M1 | 最大幅度 6,非均匀格点 | 必须结合 scale;不能当作均匀 INT4 量化 |
| NF4 | 为特定权重分布设计的 4 bit 非均匀码本 | 改善相应分布下的存储误差,不能据此推出 FP4 原生计算能力 |
E4M3 必须继续区分 FN 与 FNUZ:前者上表为 448,FNUZ 变体的最大有限值为 240。不同特殊值与指数偏置规则不能混用。TF32 则主要是 Tensor Core 的计算精度模式,并非通用的 19 bit checkpoint 格式。FP8 格式论文、OCP MX 规范
INT8 乘积常以 INT32 累加,FP8/FP4 GEMM 也需要区分输入、部分和、累加与输出精度。高精度累加减少的是运算过程的误差,无法恢复输入已经量化丢失的信息。
1.2 INT8 与 INT4:绝对舍入误差由步长决定
均匀整数量化可以写成:
这里 是反量化乘数, 是整数零点。有的框架存的是 ,所以读取名为 scale 的字段时,必须顺着消费它的乘除运算确认含义。
例如使用有效范围 的对称 INT4,对 [-0.1, 0.2, 0.4, 6.0] 取 ,前三个数都会 round 到零。这里既没有 overflow,也没有 NaN,但信息已经明显损失。
这个例子体现了范围与精度的冲突:扩大范围可以减少 clipping,却会增大量化步长、损害主体分布;缩小范围可以改善主体分辨率,却会牺牲尾部。min/max 校准寻找的是覆盖范围,MSE 校准寻找的是误差折中,两者目标不同。
对称量化常用 ;非对称量化可以更好利用有偏分布的有限格点,但需要额外零点及修正。不要把“INT4 signed 范围是 ”“有效对称范围用 ”“框架取半个整数跨度作为 scale 分母”混成一种实现。它们都可能出现在真实系统中,训练与部署必须选同一约定。
也需要纠正一个常见表述:LayerNorm/RMSNorm 主要作用于 activation,并不会把 Linear 的权重矩阵归一化到零均值;RMSNorm 本身也不减均值。是否采用对称权重量化,应由权重分布和后端约束决定。
如果采用最近舍入、scale 精确且没有 clipping,则可推得:
这是绝对误差界,不是固定相对误差界: 接近零时,即使绝对误差很小,相对误差也可能很大。若 超出可表示区间,误差还包括它到区间端点的距离;没有对输入幅度的额外约束,就不存在仅由 bit 数决定的有限全局误差上界。
取同一目标范围 ,为了方便比较都使用有效对称范围,则:
| 位宽 | 有效整数范围 | 步长 | 区间内最大舍入误差 |
|---|---|---|---|
| INT8 | 约 0.02362 | ||
| INT4 | 约 0.42857 | ||
| INT3 | 1 | ||
| 对称三值 | 6 | 3 |
最后一行只有三个有效值,不能与利用四个编码的非对称 INT2 混称。这个例子说明:8 bit 降到 4 bit,步长并不只是扩大两倍;继续降到 2–3 bit,单靠覆盖 min/max 很快就会失去主体分辨率。
1.3 FP8 与 FP4:指数扩大范围,尾数限制相对精度
对采用最近舍入的二进制浮点数,在正规数范围、没有上溢或下溢、scale 精确时,若尾数有 个显式位,一个常用相对误差上界是:
E4M3、E5M2、E2M1 对应的这一上界分别是 6.25%、12.5%、25%。这是满足条件时的舍入界,不是模型 accuracy 损失,也不是每个数都达到的误差。进入 subnormal/零附近之后,相对误差保证不再适用;实际 rounding 模式、scale 的离散化和 clipping 还会增加误差。
E2M1 的非负数值集合为:
再加上负值与带符号零构成其编码。它在小值附近分配较密、在大值附近分配较稀,与 INT4 等间距格点不同;但它的范围仍很小,因此实际张量必须缩放。用同样的 bit 数比较精度时,要比较完整的“元素格式 + scale + 分组”。
NF4 又是另一种选择。QLoRA 用适配近似正态权重的非均匀码本改善 4 bit 存储,并对量化常数再次量化以降低 metadata 开销。它不是 E2M1,不能把 NF4 checkpoint 换一个格式标签就交给 NVFP4 kernel。
1.4 MXFP4:元素之外,scale 也被限制到格点
OCP MXFP4 的基本分组是 32 个元素,每组共享一个 8 bit E8M0 scale:
E8M0 不是普通有符号 FP8 数据,它主要编码正的二次幂。读取 checkpoint 中保存为 uint8 的 scale 时,要解码指数,而不是把整数 127 直接当乘数 127;相应偏置下,127 可以表示 。
如果忽略 padding 和对齐,平均位数为:
它的额外误差来自 scale 自己的离散化。理想实数 scale 也许是 0.3,但 E8M0 只能选择相邻幂次附近的可表示值。把 scale 向上选,可以降低饱和风险,却可能增加主体 rounding 和 zero-collapse;适当向下选可能改善 MSE,但要付出 clipping。
MXFP4 格式规定了表示,不意味着所有量化器都用同一个 scale 搜索算法。 ceil(log2(amax/6)) 可以作为保守覆盖的教学方案,但不是本文源码快照的逐字实现。compressed-tensors 的 generate_mx_scales 使用与元素格式相关的指数偏移及位运算规则;做数值对拍时要调用实际实现。
1.5 NVFP4:更小分组与两级 scale
常见 NVFP4 推理表示可以概念化为:
这里使用的是反量化乘数约定。一个 FP32 tensor scale 将局部 scale 放到合适的范围;每 16 个元素再用 E4M3 编码局部 scale。与 E8M0 相比,E4M3 有尾数,局部 scale 更细,但仍会发生舍入、溢出和下溢。NVFP4 格式与训练说明
忽略少量全局 scale 和 padding,其平均位数为:
因此相对 BF16 的数据压缩比上限约是 ,而不是 4;MXFP4 对应约 3.76。真实模型还包含未量化层、对齐、索引、运行时临时区和 KV,显存比例不会简单等于这个理论比值。
在 llm-compressor 的 NVFP4 preset 中,weight 的局部和全局 scale 离线产生;activation 的 local scale 是动态的,global scale 则根据校准统计确定。所以**“activation dynamic”不等于“NVFP4 不需要数据”**。这也是只用几条短 prompt 校准后,长上下文输入可能出现严重饱和的原因之一。官方 NVFP4 示例
这个 compressed-tensors 快照中的 generate_global_scale 使用类似 的量化乘数方向,局部 scale 计算随后与它配合。它不等于上式中的反量化乘数 ;读字段必须同时看 helpers.py 和量化/反量化消费路径。
两者的设计差异可以归纳为:MXFP4 用幂次 scale 降低表示与缩放复杂度;NVFP4 用更小的组和带尾数的局部 scale,减轻共享范围与 scale 离散化的部分误差,但引入 global/local scale 协同问题。具体哪种更准,要在同一模型、量化器和目标 kernel 上测量。
1.6 scale 合法性与零值处理属于格式实现的一部分
设实际使用的 scale 为 ,编码值为 ,则重建误差含有:
提高元素量化质量并不能消除 。FP4 只有很少格点,scale 的小幅变化还可能让元素跨过 rounding 边界,使两种误差强烈耦合。
因此数值稳定性要覆盖四步:在足够高精度中统计;选择合法 scale;把 scale 编码成实际 dtype;再检查编码后的 scale 是否为零或非有限值。先对 FP32 scale 做 clamp_min(1e-8),然后 cast 到 FP16/FP8,仍可能得到零。
全零 block 可以约定有限正 scale、全零编码,精确重建为零;E8M0 还需要明确零组的合法指数约定。非对称 min=max 的退化区间也要单独处理。输入已经出现 NaN/Inf 时,应追踪上游异常,不能仅靠 nan_to_num 把整个问题掩盖掉。
1.7 低于 4 bit:标量编码与平均 bits/weight 不再等价
INT3 可以直接把每个权重映射到 8 个编码;向量量化则把一组权重共同映射到码本索引。例如 8 个权重共享一个 16 bit 索引,索引载荷平均为 2 bits/weight,但每个权重并不是只能独立取四个值。
类似地,三值权重的状态数对应 bit。它是编码率的概念,不代表每个硬件地址能容纳“1.58 个二进制位”。真正比较模型大小时,还要算打包、scale、码本、索引和未量化参数;后文的 QuIP#、AQLM 与 BitNet 会分别利用这些不同的表示方式。
2. 方法分类:PTQ 与 QAT,两条工作流面对同一个误差问题
2.1 用优化对象与训练过程分类,不用算法名字分类
PTQ(Post-Training Quantization) 从已有预训练模型出发,主要通过统计校准、参数等价变换、重建补偿与有限的局部优化完成压缩。QAT(Quantization-Aware Training) 将目标量化器放入训练前向,让模型参数或可训练增量持续适应离散表示。
| 工作流 | 典型优化对象 | 常见目标与方法 |
|---|---|---|
| PTQ:范围与分布处理 | scale、clipping、异常通道、等价缩放/旋转 | RTN 校准、LLM.int8、SmoothQuant、AWQ、QuaRot |
| PTQ:重建与有限优化 | 权重落点、rounding、变换、码本等 | GPTQ、AdaRound、AutoRound、OmniQuant、SpinQuant、QuIP#、AQLM |
| QAT:目标量化下训练 | 模型权重、clipping/scale、adapter 等 | STE、PACT、LSQ、LLM-QAT、匹配部署格式的 LoRA/QAT |
| QAT:从头训练的延伸 | 从预训练阶段学习低比特权重 | BitNet / BitNet b1.58;应与改造已有 checkpoint 的 QAT 区分 |
后文按 PTQ/QAT 两条主线组织。“用了 backward”不能单独决定分类。 AdaRound、AutoRound 和 OmniQuant 通过局部反传优化压缩参数,通常仍归 PTQ;QuIP# 和 AQLM 还包含有限微调,属于带恢复阶段的 PTQ。若额外进行大规模端到端量化感知训练,应明确标出 QAT 阶段,而不是抹掉这段成本。
旋转、蒸馏、混合精度都可以成为某条工作流的组成部分,不需要另设第三大类。MXFP4/NVFP4 是格式,Marlin/CUTLASS 是实现后端,也不与 PTQ/QAT 并列。分类是为了说明优化发生在哪里;部分论文的边界用语确有交叠,具体步骤比单个标签更可靠。
按位宽的阅读地图如下,列的是代表性使用场景,不意味着方法被永久限制在该位宽:
| 目标 | PTQ 重点 | QAT 重点 |
|---|---|---|
| 8 bit | 范围校准、异常通道、动态 scale、W8A8 | 学 clipping/步长,让权重适应量化 |
| 4 bit | 输出重建、通道重要性、旋转、FP4 scale | 权重与激活联合适应、蒸馏、部署一致性 |
| 低于 4 bit | 更强 rounding 优化、向量/加性码本、误差补偿 | 更粗格点下的优化稳定性、三值/二值训练 |
2.2 优化的是层输出,最终验收的是模型任务
全文统一使用 PyTorch Linear 布局:
是 token 数, 是输入通道, 是输出通道;为突出量化主路径,暂时省略 bias。下面 若出现在矩阵乘法中,表示量化后再反量化到实数的重建值,而非未经解码的整数索引。
记权重误差为 ,激活误差为 ,则:
第一项是 activation 加权后的权重误差,第二项是权重放大后的 activation 误差,第三项是联合量化的交叉项。这个分解直接解释了后文的方法选择:
- GPTQ 重点处理 ,所以需要输入二阶统计。
- AWQ 利用 activation 重要性修改权重的量化条件。
- SmoothQuant 在 和 之间重新分配困难。
- W4A4 下只把权重做得很准,不能消除 。
- QAT 让网络在这些误差共同存在时重新优化,但仍受目标格式的表达能力限制。
误差也不一定随层数或上下文长度单调增加;残差、归一化、attention 分布都可能放大或抑制它。要测实际输出和任务退化,不能仅凭“误差会累积”预测幅度。
2.3 scale 的粒度决定误差在哪些元素之间耦合
| 对象与粒度 | 按本文布局的逻辑 scale 形状 | 可以解决的问题 |
|---|---|---|
| per-tensor | 元数据最少,无法隔离跨通道异常值 | |
| per-output-channel | 不同输出通道独立选范围 | |
| 沿 分组,group size 为 | 将异常值影响限制在局部组 | |
| dynamic per-token | 每个 token 独立适应幅度变化 | |
| 沿 分组 | 进一步隔离同一 token 内的异常值 | |
| 二维 block 权重 | 让 scale 与二维 tile、转置路径协调 |
若 activation 按 token、weight 按输出通道量化,scale 可以从点积中提出:
若二者沿 分组,计算变成:
每个 reduction 分组都有不同 scale,不能只在最终 epilogue 乘一次。更细粒度通常改善量化表达,但也增加 metadata、局部缩放和布局约束。这就是“per-channel 更准确”不能独立于 kernel 讨论的原因。
3. 8 bit:先解决动态范围和异常通道
8 bit 有较多格点,常见困难首先是少数异常通道把整组范围拉得过大。若把范围和分组处理好,简单量化就值得作为基线;若仍不能满足质量目标,再增加补偿或训练。
3.1 PTQ:RTN、静态校准与动态 scale
RTN(Round-to-Nearest)是在确定 scale、zero-point 后直接舍入。它不做跨权重补偿,因此成本低,也是判断复杂算法是否有效的必要基线。
校准集的作用取决于方案:静态 activation 需要范围统计;GPTQ 需要输入协方差;AWQ 需要 activation 幅度和候选缩放的重建误差。只有静态权重与动态 activation 的简单 RTN 路径,才可能完全不需要校准数据。
常见 observer 包括 min/max、滑动统计、percentile 与 MSE 搜索。percentile 丢掉少量极值不一定安全:稀有 code token、数学符号或 MoE expert 可能恰好承载重要行为。范围选择至少要在独立验证集上检查,并统计每层、每组的饱和率和非零值被量化成零的比例。
工程上应分开理解两种改进。per-channel weight scale 防止某个输出通道决定其他通道的步长;per-token activation scale 让每个 token 适应自己的幅度。但一个 token 内依然可能有少数巨大通道,因此 per-token 并不能解决全部 activation outlier。
FP8 dynamic 的主要变化是换成浮点格点并动态选择范围,省去静态 activation 范围校准这一环节。它并不学习最优权重,也不补偿层输出误差;如果当前误差已很小,这是成本较低的 PTQ 起点。llm-compressor FP8 示例
稳定性上,需要用足够高精度收集 amax,处理空/零 block,检查 scale cast 后的值,并确认动态 quant 与 GEMM 是否融合。若每次 GEMM 前都额外读写一遍完整 activation,数值上合理的动态方案也可能在小 shape 上产生明显开销。
3.2 PTQ:LLM.int8 把异常通道留给高精度路径
单一 INT8 路径既要容纳异常值,又要保住主体分辨率,冲突无法只靠一个 scale 消除。LLM.int8 的核心改进是混合精度分解:将输入通道分为普通集合 和异常集合 ,概念上计算:
第一项使用带缩放的低精度计算,第二项保留高精度。相对普通逐向量 INT8,它的创新是不强迫所有通道共享同一低精度计算路径;异常通道不会再迫使普通部分的步长一起变粗。
代价是检测、收集通道、额外矩阵乘和结果合并。阈值太小,高精度分支变大;阈值太大,剩余 INT8 部分仍可能被 outlier 主导。因此要同时测高精度分支占比、层输出误差与实际延迟。这里的混合精度分解是 PTQ 内部策略。
3.3 PTQ:SmoothQuant 把 activation 的量化困难迁移给 weight
SmoothQuant 也使用 ,但重点是给 W8A8 的 activation 腾出数值空间。定义:
工程上需要处理 、 为零,以及极端 scale。较大的 会更积极地减小 activation 异常通道,同时加重相应权重列的量化负担。因此 或示例中的 0.8 都只是候选值,不是模型无关的最优常数。SmoothQuant
AWQ 与 SmoothQuant 的区别不在那条等价公式,而在目标函数和量化对象:
| 维度 | AWQ | SmoothQuant |
|---|---|---|
| 经典目标 | 保护 activation 敏感的权重量化 | 平衡 weight 与 activation 的量化难度 |
| 常见场景 | W4A16 | W8A8 |
| 统计起点 | 输入幅度重要性及重建误差 | activation、weight 的通道范围 |
| 失败信号 | 保护一列却扩大组 scale,其他列受损 | activation 更平滑,但放大后的 weight 误差更大 |
由于 SmoothQuant 改变参数化、GPTQ 优化权重落点,两者可以组合。正确顺序是先变换,再在一致的坐标系中收集统计并量化。原坐标的 Hessian 不能随意用于已旋转或缩放的权重;例如 时,应有 。
相对 LLM.int8 的分支处理,SmoothQuant 的创新在于用离线等价变换争取更规则的低精度 GEMM:将 吸收到前驱 norm/线性层,将 吸收到消费该 activation 的权重。它减少了对动态异常分支的依赖,但前提是所有消费者都正确变换,且权重增加的误差小于 activation 减少的误差。
它与后文 AWQ 使用相似公式,但优化动机不同:SmoothQuant 为 W8A8 平衡两侧范围;AWQ 的典型目标是 W4A16 下保护重要权重列。这里的“相对前作”是在比较机制,不意味着这些论文按一条严格串行的时间线发展。
3.4 QAT:STE 让权重适应离散前向
QAT 的前向计算可以是:
FQ 内部 quantize 后立即 dequantize,输出仍是浮点 Tensor,但取值受目标格点限制。浮点参数保留并交给优化器更新;真实低比特打包通常放到导出阶段。FP32 master weights 是否存在,取决于训练栈和优化器,并不是所有 QAT 都天然维护一份 FP32 参数。
round 的真实导数几乎处处为零,所以使用 Straight-Through Estimator(STE)近似反传。对固定 scale 的带截断 fake quant,一种常用近似是:
范围内近似传递梯度,饱和区外截断;具体边界与 kernel 的 mask 约定需保持一致。“STE 就是梯度永远等于 1”遗漏了 clipping 的处理。PyTorch QAT 工作流
下面只演示固定 scale、对称整数格式、范围内 STE 的逻辑,不是 NVFP4 模拟器,也不包含可学习 scale 的梯度:
import torch

def fake_quant_fixed_scale(x, scale, qmin=-8, qmax=7):
    u = x.float()
    if not torch.isfinite(u).all():
        raise FloatingPointError("non-finite fake-quant input")
    s = scale.detach().float()
    if not torch.isfinite(s).all() or not (s > 0).all():
        raise ValueError("scale must be finite and positive")
    clipped = torch.clamp(u / s, qmin, qmax)
    rounded = clipped + (torch.round(clipped) - clipped).detach()
    return (rounded * s).to(x.dtype)
.detach() 让 backward 忽略 round 带来的不连续变化,clamp 则保留饱和区的梯度门控。若使用 BF16 输入,也先在 FP32 中完成 scale 除法和范围运算,避免低精度中间值提前 overflow/underflow;最终返回的 dtype 不代表内部统计可以随意降精度。
相对前面的 PTQ,QAT 的改变是模型参数本身可以根据带量化的任务损失持续更新;代价是训练数据、backward、优化器状态和可能的能力漂移。STE 是代理梯度,不是 round 的真实导数,因此仍需验证最终离散模型的质量,不能只观察连续权重的收敛。
3.5 QAT:PACT 与 LSQ 分别学习截断范围和量化步长
固定 quantizer 的 QAT 能移动权重,但量化格点可能仍不合适。两类经典改进是直接让训练目标决定 clipping 或 scale;它们也可用于后文更低位宽,8 bit 章节先建立其基本机制。
PACT:学习哪些尾部值得牺牲。 原始 PACT 对非负 activation 使用可学习上界 :
相对固定 min/max 或固定 clipping,它让任务梯度与对 的约束共同选择范围:较小 改善主体分辨率,较大 保留尾部。参数必须保持合法正值,并监控落在截断区的比例。LLM 的有符号 activation 不能直接照搬非负形式,需要与目标量化器一致的双边范围或对称阈值。
LSQ:不仅学习范围,还控制 scale 梯度的量级。 令 ,对整数 fake quant 的代理导数有:
同一个 scale 被大量元素共享,梯度总量会随着共享元素数 变化。LSQ 使用与 相关的梯度缩放,使步长与权重的相对更新更平衡。相对只把 scale 设为可学习参数,这个优化控制才是稳定训练的关键之一。
实现时应按 per-tensor/per-channel/per-group 的实际共享范围定义 ,避免把整个模型参数量代入;scale 的参数化、梯度精度、学习率和冻结时机都要明确。极低位宽下 scale 的小幅变化会使很多值跨过格点,独立 scale 学习率和变化幅度监控尤其有用。
4. 4 bit:从覆盖范围转向输出重建与联合适应
进入 4 bit 后,“范围内没有溢出”远远不够。少量格点使 rounding 本身成为主要误差;W4A4 还同时受到权重和 activation 两侧误差影响。这里先讲 PTQ 如何改变落点与坐标,再讲 QAT 如何让网络在这些误差下重新优化。
4.1 PTQ:GPTQ 用二阶信息补偿已经量化的误差
对某一输出通道,将权重视作列向量 。固定校准输入后:
这是该层重建目标的 Hessian,不是整个语言模型交叉熵对所有参数的完整 Hessian。对于固定输入的这个二次目标,上式是精确的;把层重建损失作为最终任务损失的替代,才是更重要的近似。
假设先固定第 个权重为离散值 ,令调整量为 ,约束 。在当前尚可调整的坐标集合中求解:
拉格朗日条件给出:
这解释了 GPTQ 的核心:某个坐标被迫落到格点后,利用输入通道相关性调整还没固定的坐标,尽量抵消输出变化。并不是把每个权重单独量化后再统一修补,也不是去更新 activation。论文的高效实现让权重行共享处理次序,并用分块更新减少开销。GPTQ
在 llm-compressor 的 gptq_quantize.py 中,可以对应到四个实现细节:
- Hessian 与临时权重计算使用 FP32。输入展平后转置,累加二阶统计。
- 对角线为零的 dead channel 被单独处理。它只表示校准数据没有激活这个方向,不保证真实业务永远不会激活它。
- 先加 ,其中 ,再做 Cholesky 和逆矩阵相关计算。
- 逐列量化、更新当前块,随后将整个块的误差补偿传播到剩余列。
源码中的 Hinv 在分解之后实际保存的是逆 Hessian 的上三角 Cholesky 因子。不能把其中一行 err / d 直接当成上面完整逆矩阵公式的逐字翻译。
block_size 与 group_size 也不是同一个参数。 前者控制 GPTQ 更新的计算分块,后者决定哪些权重共享 scale。两个值都可能是 128,但改变的是不同东西。act-order 则按输入重要性改变处理顺序,其分组和 g_idx 的含义依具体实现而异;不能推断所有 GPTQ checkpoint 都必须运行时重排 activation。
如果 Cholesky 失败,这个源码快照会记录 warning 并对该模块退回 RTN。脚本能保存模型,并不代表每层成功执行了 GPTQ。应保留 fallback 层名单,检查校准覆盖、非有限数值、样本多样性,再适度增加 damping;过强 damping 又会削弱通道相关性带来的补偿能力。
GPTQ 最初重点是 weight-only。现在 llm-compressor 可以把相同的权重补偿思路用于支持的 FP4 scheme,但这不意味着 GPTQ 会直接解决 FP4 activation 的所有误差。
相对 RTN,GPTQ 从“当前元素最近的格点”推进到“考虑输入相关性的层输出重建”;相对逐个权重执行昂贵二阶更新的早期思路,它通过共享列顺序、Cholesky 形式和分块延迟更新,使大矩阵量化可执行。稳定性代价集中在 Hessian 估计与分解,而不是 scale 一个参数上。
4.2 PTQ:AWQ 用 activation 重要性改变权重的量化条件
AWQ 的起点是:权重元素大小不是输出敏感度的唯一依据,还要看该输入通道实际被多大 activation 使用。对角缩放矩阵 满足:
缩放前后浮点函数不变,但 落入量化格点的方式改变了。某个权重组的量化步长为 时,在缩放没有同比例扩大整组范围的情况下,重要通道在原坐标中的舍入误差尺度约为 。所以放大重要列可能保护它,但并不是“放大多少就一定改善多少”。
实际选择要比较:
典型做法由 构造候选 scale,再搜索幂指数及相关参数。llm-compressor 的 AWQ 实现 缓存必要输入,测试缩放后的 fake-quant 输出,并支持 duo_scaling 候选搜索。它不是仅打印 activation 统计量就结束。
这里需要区分三个概念:
- 论文发现少量 salient weights 对精度很重要,不等于部署时必须保留这些权重为 BF16。
- AWQ 没有全模型反向训练,但会改变浮点权重的参数化,并进行量化候选的输出误差评估。
- AWQ 的等价缩放要在相邻层中正确吸收。一个 norm 的输出同时送入 Q/K/V 时,三个消费者必须使用一致的变换;只改一个 Linear 会破坏原函数。
它适合 W4A16 等权重误差主导的路径。若 activation 也被压到 4 bit,需要重新评价联合误差,而不是默认 weight-only 搜到的 scale 仍最优。AWQ 论文
相对 GPTQ 的二阶相关性补偿,AWQ 用更轻量的通道幅度与 scale 搜索改善权重量化条件,不构建同样的完整输入 Hessian。它牺牲了一部分相关性信息,换来另一种成本与效果的平衡;这不是某个方案对所有模型都严格占优的关系。
4.3 PTQ:AdaRound 与 AutoRound 把 rounding 当作优化变量
GPTQ 按顺序补偿离散落点,但给定 scale 后,最近舍入本身未必让一个 block 的输出最接近浮点模型。可以把每个权重“向上还是向下”改写为待优化选择。
以 AdaRound 的思想为例,忽略边界时写成:
优化局部重建损失,同时用正则和退火使软选择 最终趋向 0 或 1。相对 RTN,它把每个 rounding 决策与层输出关联;相对 GPTQ,它使用可优化的软离散选择,而非只按闭式二阶补偿逐列推进。最终必须将软选择硬化后再验收,否则软模型的好 loss 不能证明整数模型也好。
AutoRound / SignRound 则用 STE 处理舍入,并通过 signed gradient descent 等设计优化 rounding 与范围。其核心不是重新训练全部预训练权重,而是针对 block 输出重建,迭代调整量化参数;当前 llm-compressor 文档列出 rounding 参数 与 clipping 参数 。固定版本接口
相对只优化 rounding,联合范围优化增加了可搜索空间,也增加了过拟合校准数据的风险。实现上应保存最佳验证状态,使用代表性 token,监控 clipping、有限正 scale 和硬化后的输出误差;迭代数与学习率要成套调整。它同样可用于 2–3 bit,但不能据此保证任何位宽、格式和 serving 后端都已有可用 kernel。
4.4 PTQ:OmniQuant 联合学习 clipping 与等价变换
固定规则的 SmoothQuant/AWQ 不一定给每个 block 找到最合适的范围分配。OmniQuant 用 Learnable Weight Clipping(LWC)和 Learnable Equivalent Transformation(LET),在局部重建中联合校准这些参数,基础权重可保持冻结。
其优化可以概括为:
等价平移与缩放的一个线性示意是:
真正吸收到计算图时,要处理 bias、norm 和多个消费者的耦合。相对固定幂指数的缩放方案,创新是让局部重建目标选择变换和 clipping 的组合;相对完整 QAT,它将训练范围约束在少量校准参数,降低成本。
LWC 还有一个具体设计:学习相对于当前 min/max 的 clipping 强度,而非直接学习一个不随权重变化的绝对阈值。以包含零的范围为例,若 ,用受约束的 定义 ,再计算量化步长。这使范围能跟随 LET 改变后的权重统计调整; 时退回原始 min/max。它解释了为什么 LWC 与 LET 要联合优化,而不只是依次叠加两个独立开关。
稳定性上,过小/过大的 会分别放大输入或权重,clipping 上下界还要保证次序正确。应在 FP32 中维护关键统计,限制非法 scale,逐层检查浮点变换的等价性,再比较量化输出;不要让重建损失掩盖一个本来就不等价的图变换。
4.5 PTQ:QuaRot 通过等价旋转分散异常坐标
令 为正交矩阵,,则:
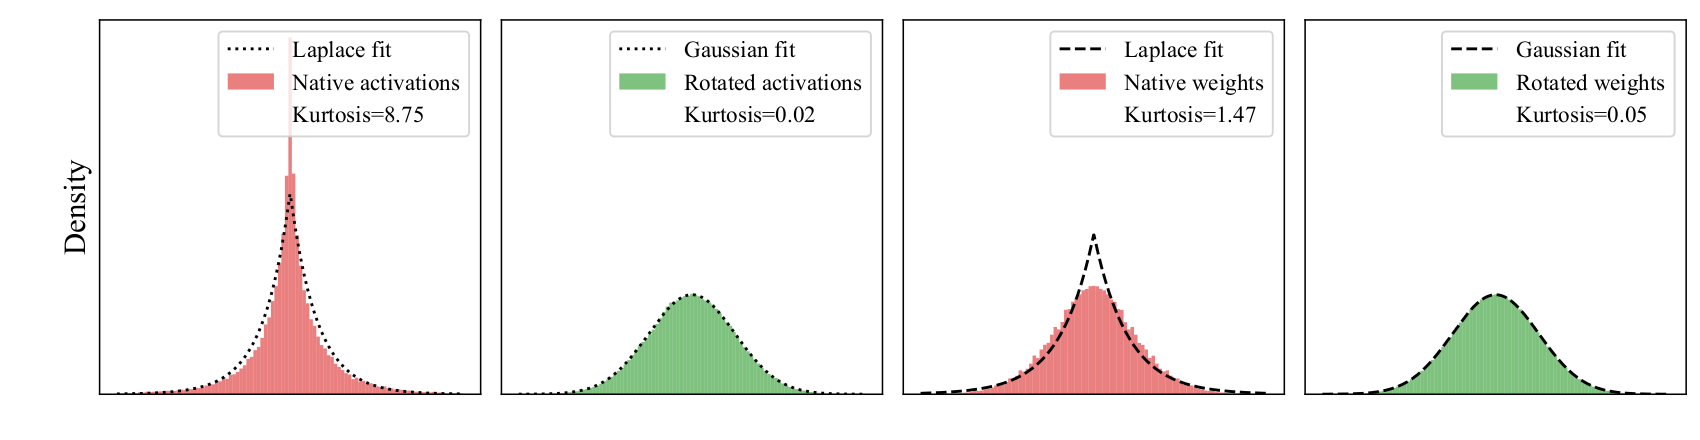
旋转保持向量二范数和内积,但不保持最大坐标、稀疏性和量化分组内的幅度分布。对于沿少数坐标集中的向量,归一化 Hadamard 变换可以把能量分散到多个维度,改善部分量化器的有效分辨率。
例如长度 16 的向量 ,乘归一化 Hadamard 后,各坐标幅度成为 4:最大值降了 4 倍,二范数仍是 16。但原向量用一个对称 scale 可以恰好表示非零值和所有零;最大值降低本身不能证明量化误差下降。
同样,正交相似变换保持 的特征值,所以完整正交旋转不会神奇地降低 Hessian 的二范数条件数。它改变的是坐标分布及其与离散格点、分组的关系,不是凭空消除信息。
还可以用一个不依赖 GPU 的小实验,把“最大值下降”和“量化误差下降”明确分开。取 ,使用 E2M1 格点、一个 16 元素分组、实数 scale ,比较直接量化与“归一化 Hadamard → 量化 → 逆变换”。运行 配套 Python 脚本 得到:
| 路径 | 量化前的最大幅度 | 回到原坐标后的平方误差 | NMSE |
|---|---|---|---|
| 直接量化 | 6 | 0 | 0 |
| 旋转、量化、逆变换 | 1.875 | 0.375 | 0.010067 |
原向量恰好落在格点上;旋转虽然压低了最大值,却破坏了这种对齐。脚本也检查了不量化时的可逆性与范数保持。这是使用理想实数 scale 的教学反例,不是 NVFP4/MXFP4 模拟器或模型精度评测;真实格式还需要加入 scale 编码及运行时舍入规则。
QuaRot 相对对角缩放的主要变化,是用正交混合把集中在少数坐标的能量分散开,并结合模型计算图安排权重、activation 和 KV 路径。对角缩放改变不同方向的长度,正交旋转保持二范数但改变与量化坐标轴的对齐,两者不是同一种变换。
“离线旋转”表示可以预先融合进权重;“在线旋转”表示推理 activation 仍需变换。RMSNorm 的归一化部分具有相应性质,但逐通道增益要正确吸收;LayerNorm 的均值、RoPE、残差、共享 embedding、tensor parallel 分片也有额外约束。特别是 通常成立,旋转不能任意穿过非线性。
4.6 PTQ:SpinQuant 进一步优化旋转矩阵的选择
随机正交矩阵都能保持浮点等价,但经过量化后精度可能差很多。SpinQuant 的创新是把旋转本身变成待优化对象,在正交约束下针对量化模型优化,而不是只接受一次随机或固定变换。
其思路可以写为 ,约束 。若只用普通优化器任意更新矩阵元素,矩阵可能不再正交,浮点等价性也随之丢失;需要论文对应的正交流形优化或约束保持更新。应同时检查 、无量化输出偏差与实际量化损失。
论文采用 Cayley SGD:从投影梯度构造反对称矩阵 ,通过形如
的更新保持正交性,其中梯度方向符号由 的构造约定决定。实现用固定点迭代近似这一更新,避免每一步显式求逆。主要优化可吸收的 R1/R2;在线 R3/R4 保留为可快速执行的 Hadamard。这说明它同时考虑了量化质量与推理变换成本。Cayley 优化细节
论文级的旋转学习与工具提供的固定旋转必须分清。在本文核对的 llm-compressor 源码中,SpinQuantModifier 会拒绝 learnable=True;它不是把论文训练过程完整封装成了一个 oneshot 开关。具体配置在工程章节说明。
4.7 PTQ:MR-GPTQ 将旋转与具体 FP4 格式共同设计
NVFP4 按 16 个元素分组,局部动态范围主要由组内数值决定,不再由整个 tensor 共用一个元素步长;不过 tensor 的 global scale 仍会影响各组局部 scale 的编码。MXFP4 则还要将组 scale 限制到 E8M0 的幂次格点。旋转可能改善组内极值,也可能把原本准确表示的零、小值和稀疏结构变成大量难以表示的新值。
MR-GPTQ 的分析和实验给出了很有价值的反例:在其研究的配置下,旋转配合普通 RTN 可以改善 MXFP4,却损害 NVFP4。后续改善依赖针对格式的量化优化,而不是只换一个更“平滑”的分布。这个结果不能外推成“NVFP4 禁止旋转”,但足以否定“所有 4 bit 都应该先做全维 Hadamard”。误差分析与方法
相对把全维 Hadamard 直接接到 RTN 前面,MR-GPTQ 把小块旋转、格式相关的 MSE scale 优化、排序和 GPTQ 补偿结合起来。关键是旋转尺寸、量化 group 和 scale 编码共同影响格点选择;论文的专门执行路径也属于整体方法,不能只比较离线误差而忽略在线变换成本。
因此需要先回答“当前是元素舍入误差,还是 scale/分组误差”,再选择是否旋转。详细指标放在第 7 节;结论应来自目标量化器和留出集,而不是只看激活直方图是否更平滑。
4.8 QAT:LLM-QAT 用蒸馏恢复联合低比特表示下的能力
4 bit 下,逐层重建足够好也可能留下跨层累积与任务分布差异。LLM-QAT 将量化模型放回训练过程,通过教师生成的数据和输出分布约束低比特学生,并考虑权重、activation 与 KV 的量化。它的 data-free 指不依赖原始预训练数据,不表示不需要样本或训练算力。
相对局部 PTQ,它优化的是更完整的模型行为;相对只用少量硬标签的 QAT,教师软分布提供了更多词表和上下文关系。通用蒸馏式 QAT 可以写为下式,其中 hidden loss 是可选扩展,并非所有论文都采用全部项:
实现时冻结教师并关闭其梯度;学生在真实目标格式的 fake quant 下训练,KL/softmax/logits reduction 使用足够高的精度。padding、next-token shift、有效 token 数和梯度累积的归一化必须一致,否则损失权重会随 batch 或序列长度变化。
W4A16 只模拟权重还可能足够;W4A4 必须把 activation 格点、scale 和 clipping 同时放入训练。对于 MXFP4/NVFP4,还要量化 scale 本身。使用 INT4 fake quant 学到的补偿,不能直接认作 E2M1 与 E4M3/E8M0 scale 下的补偿。
QLoRA 把冻结的基础权重低比特存储,梯度经反量化计算流向 LoRA。它主要解决微调内存问题,并不自动模拟最终的 W4A4 activation、KV 或 NVFP4 kernel。
尤其要检查:
训练时在反量化基础模型外加高精度 adapter,部署时却先合并再整体量化,会改变前向函数。需要匹配的 QAT/LoRA 合并策略或合并后的再次评测,不能只验证未合并模型。
原生低精度训练则进一步让 forward、dgrad、wgrad 的 GEMM 使用 FP4 操作数,必须处理梯度舍入、转置量化、累加误差和优化器状态。它与“用 BF16 GEMM 执行 fake quant 的 QAT”有不同的性能目标和稳定性要求。
4.9 QAT 与原生 FP4 训练:稳定前向还不够
普通 QAT 可以用浮点 GEMM 计算反量化后的 FP4 操作数,因此它的收益首先体现在最终模型质量。若进一步要求训练 GEMM 本身用 FP4,就进入原生低精度训练的问题:这是训练执行方式的延伸,需额外处理 backward,不能仅由 W4A4 推断。
对于 ,三类主要 GEMM 是:
它们的 reduction 方向不同,同一权重在 forward 与 backward 中还会以不同方向被消费。沿一维分组重新量化转置后的矩阵,一般有 ,意味着两个方向看到的离散权重不同。
Transformer Engine 的 NVFP4 训练 recipe 采用 16×16 的二维权重 scale,让转置路径更一致;它是训练策略,不能据此声称所有 NVFP4 推理权重都按 16×16 共享 scale。常见推理表示仍是上面的 1×16 分组。训练 primer
另外两项训练技术也要区分作用范围:
- TE 2.16 在 wgrad 使用的 columnwise input/gradient 量化路径上应用 RHT,降低这些 reduction 方向的异常值影响。它不是把每层 forward 激活统一旋转后就结束。
- 随机舍入用于梯度量化。对相邻格点 ,取上格点的概率为 ,下格点的概率为 ,在未饱和等条件下有 。这能降低系统性舍入偏差,但不能保证每一步梯度准确,也不能修复 clipping 的偏差。
RHT、二维 scale、随机舍入以及更高精度状态构成特定训练 recipe 的组合。不能把其中任意一个开关当作“FP4 稳定训练”的充分条件,也不能把预训练论文中的结果直接外推到 QAT。NVFP4 训练论文
5. 低于 4 bit:格点不足迫使优化目标与表示一起改变
2–3 bit 并不是把 4 bit recipe 的一个数字改小。相同范围下步长迅速增大;缩小 group 虽能降低部分误差,scale 开销却占更大比例;少数敏感层和校准偏差也更容易主导最终质量。因此,这一阶段既需要更强的 PTQ 重建,也需要考虑训练式量化。
5.1 PTQ:GPTQ / AutoRound 仍可使用,但要按真实预算比较
GPTQ 的二阶目标和 AutoRound 的 rounding 优化并没有限定必须 4 bit,可继续用于 3 bit、2 bit。变化在于单次离散化造成的扰动更大:二阶补偿的局部最优不代表下游非线性和最终任务损失也最优;局部重建的校准过拟合更容易被暴露。
可以比较更小 group、更多代表性校准 token、clipping 搜索、更多局部优化,以及少数敏感层保留高位宽。但“2 bit + 更密 scale + 更多高精度层”未必比规则 3 bit 更小。若每 个权重保存一个 16 bit scale,仅这一项就使平均位数变成:
例如 已是 3 bits/weight,还未计 zero-point 与其他 metadata。应比较相同 checkpoint/显存预算下的任务质量,而不是只比较 preset 名字。
数值上还应检查 GPTQ 的 damping 与 fallback、AutoRound 的硬化误差、局部误差的 P99,以及验证集随迭代是否反弹。混合精度选择同样属于 PTQ 内部的预算优化;如果随后用任务损失训练这些配置,再明确记录 QAT 阶段。
5.2 PTQ:QuIP / QuIP# 从独立标量转向结构化向量量化
QuIP 将 incoherence 处理与基于二阶统计的自适应舍入结合,缓解权重和 Hessian 的不利坐标结构。QuIP# 的主要推进是更高效的随机 Hadamard 处理、BlockLDLQ 与基于 的结构化向量码本,再加有限的量化恢复微调。
标量量化分别给每个 选一个值;向量量化则给一组 共同选择码字 。在输入相关性的度量下,可以把局部选择理解成:
这里是解释优化目标的示意,不是 BlockLDLQ 的完整实现。真实算法还要利用块间关系补偿先前量化误差。相对 GPTQ 的标量落点,创新是同时优化一组权重的联合表示,并利用规则码本结构控制解码成本。
需要注意两种“块”不是一回事:前文的 scale group 是共享缩放因子;这里的 vector group 是共享一个联合编码。后者可以在平均 2 bit 的预算下使用更丰富的向量形状,不能拿“每个标量只有四个值”的直觉直接判断其误差。
稳定性与部署代价包括:正交变换正确性、Hessian 分解、码本输入的归一化范围,以及专门的码本解码/矩阵乘。有限微调也要纳入压缩成本。llm-compressor 的 QuIPModifier 只提供相关变换能力,不能据此宣称已经实现 QuIP# 的完整 E8 码本和 BlockLDLQ 路径。
5.3 PTQ:AQLM 用多个可学习码本相加表示权重
固定码本结构便于优化 kernel,但未必适合每层权重。AQLM 把加性量化用于 LLM 的输入感知重建:一组权重由多个码本各选一个向量再相加。
是码本数, 是每本条目数, 是一组权重的维度;上式第二项只计算索引载荷。例如 时为 2 bits/weight,码本和 scale 还要另外计入。
核心优化分为离散与连续两个方向:通过 beam search 等方式选择 codes;固定或交替更新 codes 时,优化码本数值;再以 Transformer block 重建协调多层。相对普通向量聚类,它以输入分布加权后的层输出为目标;相对 QuIP# 的结构化码本,它进一步学习适合当前权重的加性码本,代价是搜索和解码复杂度。
这仍是从既有模型出发的 PTQ,可带有限恢复训练。工程验收要把 codebook、indices 与 scale 当作一个整体,检查反量化后输出;只保存索引或错配码本版本都会改变模型。码本更新采用足够高精度、避免少量校准样本过拟合,是实现时需额外验证的稳定性条件。
5.4 QAT:2–3 bit 下,代理梯度与部署格点的一致性更重要
继续降低位宽时,STE、LSQ、蒸馏等机制仍然适用,但每次跨格点会引起更大的离散跳变。连续参数看似平稳,不代表量化输出也平稳;应同时记录权重跨格点比例、scale 相对变化、饱和率与真正离散前向的验证损失。
可执行的训练顺序是:从浮点或 PTQ 初始化出发,按目标格式启用 fake quant;逐步引入最敏感的 activation/KV 量化点;在合法范围内优化权重与 scale;固定静态统计后继续适应;最后用目标 kernel 的舍入、打包和反量化做验收。逐步降位宽只是可选训练日程,最后必须在实际目标位宽下完成适应,不能用较高位宽的收敛替代验收。
对于码本模型,训练对象可能是码本或其他高精度参数,而不是逐权重 INT2 的 STE。应模拟实际表示:用标量 INT2 fake quant 训练后导出 AQLM,不具有数值等价性。这里的要点仍是前文 QAT 的契约,只是在更少 bit 下,失配代价更加明显。
5.5 QAT 的从头训练延伸:BitNet 从二值权重走向三值权重
BitNet 从模型训练阶段引入低比特 Linear,二值权重可以概念化为缩放后的 。相对现有模型的 PTQ,它让模型从学习过程开始就适应极低位宽;这需要训练预算,不能作为任意预训练模型的无损转换。
BitNet b1.58 的关键变化是加入零值,使用 absmean 缩放后的三值量化:
适当的位置再应用缩放因子。相比二值权重,零值让小权重能被显式忽略,减少把它们强制推到正负幅度的误差;论文中的 activation 仍使用更高位宽,不能称为全部操作数都是 1.58 bit。
这属于量化感知训练思想的从头训练延伸,不是通用现有 checkpoint 的 PTQ,也不同于少量步骤的 QAT 微调。高精度 latent weights 保存细小更新,STE 让梯度穿过离散前向,activation 归一化与合法正 scale 控制范围;优化器和梯度并未因此自动变成三值。
数值稳定性上,若连 latent weights 也每步强制覆盖成三个值,小于格点间隔的更新会直接丢失。要区分可训练状态与部署权重,并验证近零 、梯度裁剪和实际乘加/查表 kernel。理论编码率 也不能替代文件大小和端到端吞吐测试。
5.6 三种低于 4 bit 的方案,改变的是不同对象
| 路线 | 解决格点不足的方式 | 核心优化 | 主要成本 |
|---|---|---|---|
| GPTQ / AutoRound 的 2–3 bit PTQ | 在既定标量格点中选更合适的落点 | 二阶补偿或局部 rounding/范围优化 | 校准、重建与敏感层配置 |
| QuIP# / AQLM 的 PTQ | 用一组权重的联合编码增加表达能力 | 结构化向量量化或学习加性码本 | 码本、索引、专用解码及恢复微调 |
| BitNet 系列训练式量化 | 让模型学习适应二值/三值权重 | 带离散前向的训练 | 训练资源、高精度状态与专用计算路径 |
因此,“都小于 4 bit”只是在比较预算;它们并没有相同的可表示集合、误差模型或实现难度。
6. llm-compressor:将不同位宽的 PTQ/QAT 选择落实为工程流程
以下沿用已核对的 llm-compressor 052d807f5eb2 与 compressed-tensors a2a210e9001d 源码快照说明接口。两者用于源码阅读,不代表本文执行过 GPU 验证的依赖组合;实验时还需锁定相互兼容的安装版本。
6.1 三层职责与版本边界
离线算法在 llm-compressor 中执行;compressed-tensors 描述量化 scheme、qparams、transform 元数据及压缩表示;vLLM/SGLang loader 再选择其支持的执行路径。
浮点模型 + 校准数据 + recipe
  → oneshot / CompressionLifecycle
  → transform → observer/Hessian 收集 → 权重量化
  → save_pretrained(save_compressed=True)
  → safetensors + quantization_config + transform 元数据
  → 推理框架 loader / repack
  → 目标硬件的量化 GEMM / attention kernel
能表达 scheme、能保存 checkpoint、能高效执行,是三次不同的验收。 例如官方 QuIP 示例仍包含额外 vLLM 改动的提示,不能由 QuIPModifier 可导入推断所有 serving 版本都支持它。
另一个具体版本陷阱是 SpinQuantModifier:在本文快照中,源码包含 R1/R2/R3/R4 的变换构造,但 learnable=True 和 randomize=True 会被 validator 拒绝。示例注释关于 R3 的描述还可能滞后于源码。因此本文把它作为旋转变换工具,而不声称运行 oneshot 就完成了 SpinQuant 论文的旋转学习。源码约束
6.2 事件、hook 和量化参数分别何时发生
在当前源码中,关键事件是 CALIBRATION_START、SEQUENTIAL_EPOCH_END、CALIBRATION_END;旧笔记中的 CALIBRATION_EPOCH_START/END 不应直接当作当前 API 名称。
| 阶段 | 数据或状态变化 | 为什么需要这个阶段 |
|---|---|---|
| 初始化 session 与 recipe | 匹配模块,绑定 scheme、observer、变换配置 | 明确哪些层被改变,以及之后如何收集统计 |
CALIBRATION_START | 应用校准前变换、准备输入 hook 和统计 | 统计必须对应后续实际量化的坐标系 |
| 当前 subgraph 的 forward | 收集 activation 范围、Hessian、AWQ 所需输入 | 每种算法看到的并不是同一类“校准数据” |
SEQUENTIAL_EPOCH_END | 搜索 scale、执行补偿、更新权重与 qparams | 在激活和临时矩阵可以释放前完成当前块 |
| propagation forward | 在启用误差传播时,用当前压缩结果产生下一块输入 | 后续层适应上游压缩带来的分布变化 |
CALIBRATION_END / finalize | 收尾状态与 hook | 避免继续更新本应固定的统计 |
| compressed save | 序列化并进行压缩表示转换 | 真正生成低比特存储,不等于训练/校准中的浮点 fake quant |
SequentialPipeline 会在 propagation pass 关闭采集 hook,避免再次污染统计。这一遍是否执行由 propagate_error 控制;该快照对 AutoRound 会将它关闭,不能概括为“所有算法固定两次 forward”。
GPTQ 为宽度 的一层保存 FP32 Hessian,单这一项约需 字节: 时约 256 MiB,还没计权重副本、Cholesky 和 activation。Sequential/offload 减少同时驻留的对象,但不消除单层平方级状态;显存不足时要看具体哪个状态占用,而不是仅减小量化后的 group size。
通用 QuantizationModifier 内部的 fake quant 不意味着 oneshot 在执行 QAT。判断是否训练,要看是否有 optimizer step、哪些参数有梯度、优化的 loss 是什么;本文主线的 oneshot 示例是 PTQ。
6.3 先建立一条可复现的校准和保存链
下面采用本地 JSONL 校准文件,每行有一个 text 字段。对 instruction 模型,建议先用该模型 tokenizer 的 chat template 生成 text,后续 tokenization 避免重复加 BOS/EOS。不要用不匹配的模板让量化统计学到另一种输入分布。
from pathlib import Path
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer
from llmcompressor import oneshot
from llmcompressor.modifiers.gptq import GPTQModifier

MODEL_ID = "/models/base-model"  # 换成实际模型目录或 HF ID
OUT_DIR = "/models/base-model-w4a16-gptq"
N_CALIB = 256
MAX_LEN = 2048

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(MODEL_ID)
ds = load_dataset("json", data_files="calibration.jsonl", split="train")
ds = ds.shuffle(seed=42).select(range(min(N_CALIB, len(ds))))
assert len(ds) > 0
ds = ds.map(
    lambda row: tokenizer(
        row["text"], truncation=True, max_length=MAX_LEN,
        padding=False, add_special_tokens=False,
    ),
    remove_columns=ds.column_names,
)

recipe = GPTQModifier(
    targets="Linear", scheme="W4A16", ignore=["lm_head"],
    block_size=128, dampening_frac=0.01,
)
oneshot(
    model=model, tokenizer=tokenizer, dataset=ds, recipe=recipe,
    max_seq_length=MAX_LEN, num_calibration_samples=len(ds),
)
Path(OUT_DIR).mkdir(parents=True, exist_ok=True)
model.save_pretrained(OUT_DIR, save_compressed=True)
tokenizer.save_pretrained(OUT_DIR)
这里的 256 条、2048 token 和 damping 都是起点。更有价值的是校准 token 的分布:覆盖语言、代码、推理长度、真实系统提示和工具调用;对 MoE,还要关注 expert 覆盖。校准集、用于挑选 recipe 的验证集、最终质量测试集要区分开。
仅量化 Linear 不一定覆盖模型中的所有矩阵:fused QKV、定制 MoE 层和非标准模块需要框架适配。应检查匹配到的模块数、忽略列表、处理日志,而不是看到脚本无异常就认为全模型按预期量化了。
6.4 只替换 recipe,但每次重载原模型
AWQ W4A16: 使用前置缩放与后续量化两段式配置。
from llmcompressor.modifiers.transform.awq import AWQModifier
from llmcompressor.modifiers.quantization import QuantizationModifier

recipe = [
    AWQModifier(duo_scaling="both"),
    QuantizationModifier(
        targets="Linear", scheme="W4A16_ASYM", ignore=["lm_head"],
    ),
]
AWQ 的 mappings 定义哪些生产者/消费者参与等价缩放,targets/ignore 定义哪些模块量化,两者不能互相代替。被 ignore 的层仍可能参与保持函数等价所必需的缩放。AWQ 示例与 mappings
SmoothQuant + GPTQ W8A8: 前者改善输入分布,后者补偿权重误差。
from llmcompressor.modifiers.transform.smoothquant import SmoothQuantModifier

recipe = [
    SmoothQuantModifier(smoothing_strength=0.8),
    GPTQModifier(targets="Linear", scheme="W8A8", ignore=["lm_head"]),
]
本文 compressed-tensors 快照中的 W8A8 是权重 per-channel static、activation per-token dynamic 的对称 INT8 配置。这里 0.8 沿用官方示例,需与其他候选比较。对应示例
FP8 dynamic: 可用于低成本验证压缩—导出—推理链路。
recipe = QuantizationModifier(
    targets="Linear", scheme="FP8_DYNAMIC", ignore=["lm_head"],
)
纯 RTN 的这个 preset 权重按 channel、activation 按 token 动态量化,不需要为了激活范围特意收集静态校准数据;用 pipeline="datafree" 的路径时不要误称其进行了 Hessian 校准。若前面加了依赖统计的 transform,则仍按 transform 的需求准备数据。
NVFP4 RTN 与 GPTQ: 先比较无旋转的同格式基线。
recipe = QuantizationModifier(
    targets="Linear", scheme="NVFP4", ignore=["lm_head"],
)
# 或在独立的一次运行中比较:
recipe = GPTQModifier(
    targets="Linear", scheme="NVFP4", ignore=["lm_head"],
    block_size=128, dampening_frac=0.01,
)
NVFP4 与 NVFP4A16 分别表示权重/激活联合量化和 weight-only;MXFP4 与 MXFP4A16 同理。preset 不能只看名字,要读取 quant_scheme.py。更细的 observer、act-order、scale 配置,应参考固定版本的 llama3_gptq_example.py,不要混用另一个版本的字段。
6.5 旋转在 recipe 中放在哪里
比较分组旋转时可以用下面的实验组合,但它并不等于完整 MR-GPTQ:
from llmcompressor.modifiers.transform import QuIPModifier

recipe = [
    QuIPModifier(
        rotations=["v"], transform_type="hadamard", transform_block_size=16,
    ),
    GPTQModifier(targets="Linear", scheme="NVFP4", ignore=["lm_head"]),
]
它表达的是“输入侧小块旋转 + GPTQ + NVFP4”。完整 MR-GPTQ 还涉及格式相关 scale 搜索、重排和专门 kernel 支持;把三个名字组合起来,不能声称复现了论文结果。即使块大小恰好是 16,也要检查 transform block 与 quantization group 的轴和排列是否一致。
模型级旋转可参考:
from llmcompressor.modifiers.transform import SpinQuantModifier

recipe = [
    SpinQuantModifier(rotations=["R1", "R2", "R4"],
                      transform_type="hadamard", transform_block_size=128),
    QuantizationModifier(targets="Linear", scheme="W4A16", ignore=["lm_head"]),
]
这对应当前示例中的固定变换,不执行 learned rotations。隐藏维度、head dimension 和 transform block 的整除要求需逐模型检查;R3 attention 变换还涉及专门适配,不能随意多加一个字符串就认为正确。SpinQuant 示例
旋转后至少保存变换类型、块大小、应用模块、在线/离线状态及相关参数。若服务器丢掉在线变换,权重文件即使成功加载,也可能计算另一个函数。带旋转的 checkpoint 必须先在实际 serving 后端验证输出,再做速度比较。
6.6 怎样判断导出的模型真的按目标方案执行
建议保留一个运行清单:原模型 revision、llm-compressor/ compressed-tensors/推理框架版本、CUDA 与 GPU、校准数据标识和 hash、seed、token 数、recipe、忽略层,以及量化 fallback 日志。
导出后检查三件事:
config.json的quantization_config与预期格式、group size、activation 动态策略一致,transform 元数据未丢失。- safetensors 不只是保存了一个插有 fake quant 的 BF16 模型;实际存在对应压缩表示和 scale,权重载荷大小合理。不同格式的字段名不能机械套用
qweight/scales/qzeros。 - 推理日志和 profiler 显示实际 kernel。checkpoint 标着 NVFP4,不保证硬件执行 W4A4;官方示例指出较早架构可走 weight-only 路径,具体还依后端与 shape 支持。
对于常规受支持的 compressed-tensors checkpoint,vLLM 通常从配置识别量化方式;不要把 AWQ 优化出的 compressed-tensors 文件强行当成另一种 AWQ checkpoint 布局。GPU 支持、tensor-parallel 分片和真实 shape 都要包含在验收里。vLLM 集成说明
6.7 2–3 bit 的 PTQ recipe 与方法实现边界
在当前快照中,W2A16、W3A16 可以表达相应的整数量化 scheme,AutoRound 也提供相关工作流。下面展示替换 recipe 的方式,其他模型加载、校准与保存步骤沿用上面的完整示例:
from llmcompressor.modifiers.autoround import AutoRoundModifier

recipe = AutoRoundModifier(
    targets="Linear", scheme="W3A16", ignore=["lm_head"], iters=200,
)
需要安装该版本所要求的 AutoRound 依赖。iters=200 是官方示例的起点,不是质量保证;校准长度、batch、样本数量和学习率仍需配合调整。AutoRound 示例
| 文中的方法 | 当前工程入口 | 不能由此推断的能力 |
|---|---|---|
| INT8 / FP8 / NVFP4 RTN | QuantizationModifier + 对应 scheme | 不自动执行二阶补偿或 QAT |
| GPTQ | GPTQModifier | 不保证每层成功分解、不替代 activation 校准 |
| AWQ / SmoothQuant | transform + quantization/GPTQ 的组合 | 不保证任意模型的跨层映射都正确 |
| AutoRound | AutoRoundModifier + 独立依赖 | 支持配置不等于 serving kernel 已覆盖所有位宽 |
| QuaRot/SpinQuant 风格变换 | 对应 transform 与模型适配 | 固定变换不等于论文 learned rotation |
| QuIP# / AQLM | 专门算法、码本格式和加载/执行实现 | QuIPModifier 不提供完整 QuIP#,W2A16 不等于 AQLM |
| PACT / LSQ / LLM-QAT / BitNet | 对应训练实现或显式训练循环 | oneshot 不自动完成这些训练方法 |
只有数值表示、算法、导出格式和实际 kernel 连成完整路径,一个低位宽 recipe 才有部署意义。
6.8 QAT 的 prepare、训练、convert 与打包
一个可验证的日程是:先加载浮点或已有 PTQ 初始化;准备目标 FQ;用少量训练步 warm-up;开启目标位宽训练;待静态统计稳定后冻结 observer;以最终部署配置继续适应;最后 convert、pack、重新加载评测。warm-up 长度和冻结时间由实验决定。
冻结 observer 不等于冻结所有运行时 scale。dynamic per-token/per-block 的计算方式就是模型前向的一部分,部署需要它,QAT 也必须继续模拟它。
torchao 的核心接口可以表示为:
from torchao.quantization import (
    quantize_, Int8DynamicActivationInt4WeightConfig,
)
from torchao.quantization.qat import QATConfig

base_config = Int8DynamicActivationInt4WeightConfig(group_size=32)
quantize_(model, QATConfig(base_config, step="prepare"))
# 在这里构建 optimizer,并执行你自己的训练循环。
# train_loop(model)
quantize_(model, QATConfig(base_config, step="convert"))这是接口骨架,model、训练数据和 optimizer 由调用者提供。它展示 prepare/convert 的职责,不意味着 torchao 的 Tensor subclass checkpoint 可直接作为 llm-compressor 的 compressed-tensors checkpoint 加载。两条导出链必须按各自后端验证。QAT API
最后要逐项对齐:位宽、signed 范围、group axis、padding、rounding tie rule、clipping、static/dynamic 策略、scale 编码、global scale 方向,以及敏感层的排除列表。对 FP4,fake quant 必须使用真实 E2M1 非均匀格点及量化后的 scale;拿 INT4 fake quant 训练再导出 NVFP4,没有数值等价性保证。
8 bit、4 bit 和 2–3 bit 的 QAT 都应保留训练日志与离散模型验收;若改了 quantizer、合并了 adapter 或替换了 backend,需要重新对拍,不能复用旧结果。
7. 数值稳定性与方法选择:用哪些指标判断有效
7.1 先验证浮点等价性,再测目标格式的量化误差
先固定最终 quantizer:元素格式、group size、scale dtype、clipping、rounding、scale 算法都不能在消融实验中悄悄改变。然后按下面顺序测量。
第一层:确认变换本身正确。 不打开量化,比较原模型与旋转模型的输出,记录逐层相对误差和 logit 偏差。允许浮点重排带来的舍入差异,但明显漂移通常表示转置、逆变换、norm 融合、RoPE 或分片处理出了问题。
第二层:看分布,但只作为诊断。 对每层、每 token、每个实际量化 block 统计:
再记录峰度、组间 amax 比例、zero-collapse、饱和比例和 scale 编码的极值占比。全零组单独处理,不用除法产生的巨大比值把它误判为 outlier。这里没有通用的“ 必须旋转”阈值。
第三层:用真实目标量化器检查输出。 至少记录:
同时看 cosine similarity 和误差的 P95/P99;接近零的参考输出单独统计绝对误差。weight-only 可以比较 ;W4A4 必须重新执行 ,不能只比较 。
第四层:以任务和部署决定是否保留。 独立留出集上的 、PPL、teacher/student logit KL,用于发现整体偏移;代码、数学、检索、长上下文和真实业务评测用于发现平均值掩盖的退化。最后测真实 kernel 下的 TTFT、TPOT、吞吐、显存和旋转耗时。
PPL 比值满足 ,因此 NLL 更适合比较小幅差异。评测 tokenization、chat template、序列裁剪和 loss mask 必须一致,否则 KL/PPL 的差异可能来自评测管线。
分布统计需要按真正的 quantization group 计算。例如长度为 的非零组,忽略 epsilon 有 ;对 NVFP4 的 16 元素组,上界只有 4。因此不能把从整层张量算出的阈值直接套到 block 指标上。这是诊断粒度影响结论的一个具体例子。
7.2 旋转是否保留:做同格式消融,而不是只比较异常值
| 候选 | 目的 | 与谁比较 |
|---|---|---|
| BF16 原模型 | 建立质量与性能基线 | 所有候选 |
| BF16 + 旋转 | 检查图变换是否等价 | BF16 原模型 |
| RTN,无旋转 | 测格式本身的损失 | BF16 |
| GPTQ,无旋转 | 分离二阶补偿收益 | 同格式 RTN |
| RTN + 分组旋转 | 只考察旋转影响 | 同格式 RTN |
| GPTQ + 分组旋转 | 检查组合是否优于单项 | 无旋转 GPTQ |
| 更改旋转块大小或学习旋转 | 检查额外复杂度是否必要 | 前面最好的可部署候选 |
每个候选都从原始 checkpoint 重新开始,并在变换之后重新校准;不要在已经量化的权重上不断叠加旋转。若使用随机旋转,固定并保存 seed,至少比较多个 seed 的方差,避免挑中一次偶然好结果。
我的选择原则是:先把任务允许的掉点、P99 延迟和显存预算写成约束,再比较满足约束的候选。只有分布改善、却没有真实重建误差或留出集收益的旋转不应默认保留;只有精度收益、却没有可接受 kernel 路径的旋转,也还不是完成的工程方案。
7.3 按症状定位 PTQ 与 QAT 的稳定性问题
| 症状 | 优先检查 | 可验证的处理方向 |
|---|---|---|
| 小值大量变零,但没有 NaN | 组内 range、scale 编码、最小非零格点 | 减小 group、搜索 clipping/scale、比较变换前后 NMSE |
| 少数长输入明显掉点 | 校准长度分布、静态 global scale、饱和率 | 扩充代表性校准输入,检查 local dynamic 是否真的启用 |
| GPTQ 某层异常或退回 RTN | Hessian 对角线、非有限数值、Cholesky、校准覆盖 | FP32 统计、适度 damping、记录并评估 fallback 层 |
| QAT 开始后 loss 激增 | 一次开启过多量化点、observer 快速变化、scale 梯度 | warm-up、分阶段启用、静态 observer 冻结、独立 scale 学习率 |
| QAT loss 正常、部署明显退化 | fake quant 与 kernel 不一致、LoRA 合并、变换丢失 | 对同一输入做量化前后、pack 前后和 loader 后的逐层对拍 |
| FP16 NaN/Inf | reduction、softmax、scale 倒数、loss scaling | 用 FP32 统计与 reduction;必要时 BF16;先 unscale 再裁剪梯度 |
| 模型更小却更慢 | 独立 dequant、旋转 GEMM、layout/repack、小 batch 开销 | profiler 分离 quant/rotate/GEMM,核对 fused kernel 与真实瓶颈 |
对于 QAT 的训练状态,至少监控 loss、gradient norm、非有限梯度次数、scale/阈值直方图、饱和率、zero-collapse、observer 更新幅度。使用梯度累积时,observer 是否每个 microbatch 更新、分布式统计是否合并,也会影响结果。
GradScaler 主要解决特定混合精度路径的梯度数值问题,不会自动让 E2M1 多出有效格点。BF16 的动态范围更大,常常不需要 FP16 风格的 loss scaling,但 BF16/FP4 的舍入噪声仍然存在。
敏感算子需要分别考虑:norm 的均值/方差或平方和统计、softmax 的减最大值与指数/reduction、长 reduction 的累加,通常需要比 FP4 元素更高的精度。INT8 GEMM 的典型乘积累加是 INT32;浮点 GEMM 要区分输入格式、累加类型、部分和归并方式和输出 dtype。高精度累加只能减少累加误差,不能恢复输入量化时已经丢掉的信息。
“保留高精度层”也应由消融驱动。常见候选是 lm_head、embedding、norm、router 和敏感 attention 路径,但全都排除会降低压缩收益;MoE router 的微小偏差可能改变 expert 选择,需要看路由分布与任务结果,而不只看 Linear 的平均 MSE。
8. 将相同思路用于 KV Cache 与实际 kernel
KV 的 scale 校准、异常值处理、离线选择量化轴可放在 PTQ 路线下理解;若训练前向模拟 KV 量化并优化模型,则属于 QAT 的一部分。KV 数据在运行时产生,所以“动态量化”描述的是数据与 scale 的产生方式,不意味着在线更新模型权重。
8.1 权重压缩为何不能代替 KV 压缩

W4A16 常用低比特权重存储,再在 kernel 内解包和反量化到计算片段;不会必然执行 INT4×BF16 的原生乘法。优化的重点是把读取、dequant、scale 和 GEMM 连成一个 tile 数据流,而不是在 HBM 生成完整的 BF16 权重副本。
小 batch decode 常更受权重读取限制,prefill 或大 batch 更容易提高复用和算力利用率,所以同一低比特方案在不同阶段可能有不同收益。Marlin 的专用 pack/repack 价值也在于贴合消费顺序,不能只由“4 bit 少了一半”推导端到端速度。MARLIN
每条序列的 KV 数据量近似为:
为层数, 为缓存长度, 为 KV head 数, 为 head dimension, 为每元素数据位数。并发、多份缓存和 metadata 要另计,prefix sharing 则可能减少重复存储。
8.2 K 与 V 的量化轴为什么可能不同

K 的误差影响 和随后 softmax 的概率分布;V 的误差影响概率加权求和。两者的统计分布和使用方式不同,因此没有“所有 KV 都应该 per-token”或“所有 K 都应该更低位宽”的普遍结论。
KIVI 使用 key per-channel、value per-token 的不对称方案;KVQuant 进一步讨论 pre-RoPE key、非均匀量化和异常值处理。pre-RoPE 量化需要 attention/缓存路径配套,不是改 checkpoint 的一个字段就能实现。
若 K 的 scale 是每 token/head 一个标量,可以融合进相应 score 的缩放;若 scale 沿 head dimension 分组,则必须在 reduction 内处理。V 同样如此。只有满足对应广播条件,才能把公式简写为 dot(Q, K_q) * k_scale。
FlashAttention 通常不长期物化完整 score 矩阵。因此 attention 量化应明确是在 Q/K/V、KV 存储、QK/PV 乘法输入还是 softmax 中间结果上施加量化;这些对象不能用“attention score 量化”一词互相替代。
8.3 vLLM / SGLang 的参数与布局要按版本核对
vLLM 的 Quantized KV Cache 文档 区分 KV dtype、scale 来源与后端能力。模型 weight scheme 和 KV dtype 分别设置,导出权重量化文件不会自动启用所有 KV 路径。per-tensor、per-head 与 per-token-head 不是同一个 scale shape。
旧笔记记录过 Triton attention 将 FP32 scale 内联在每个 token/head 的 KV 数据尾部的布局:
[num_blocks, 2, block_size, num_kv_heads, data_head_size + scale_pad]
scale_pad = sizeof(float32) / sizeof(cache_storage_dtype)
这是一种具体实现方式,不是所有 vLLM cache 的公共契约。其好处是 scale 跟随 paged block 生命周期,代价是所有读写路径都必须理解尾部布局;具体版本以 Triton backend API 及对应源码为准。
SGLang 文档在本次核对时已分别列出 nvfp4 与 fp4_mx_block16 等 KV 选项。旧稿中的 fp4_e2m1 字符串不应视为当前通用启动参数;其 block-16 MX 风格 KV 也不能直接称作 OCP 标准 block-32 MXFP4。FP8 scale 缺失而使用 1.0 时,还应检查动态范围是否合适。SGLang KV 配置
8.4 TurboQuant、UltraQuant 与可部署性的距离
TurboQuant 将在线向量压缩、旋转、标量量化与残差估计联系起来,关注向量和内积误差;它并不等价于标准 MXFP4/NVFP4 checkpoint。
UltraQuant 则把低比特 KV 放进 context-heavy agent 的执行场景,考察格式近似、缓存压力与 attention kernel。旧稿记录其后期 agent round 的 P50 TTFT 最高约 3.47×、全轮次约 2.3×、输出吞吐约 1.63×;这些是原报告特定 workload 的结果,不是本文本机实测,也不能外推到短上下文服务。
这里可以看到一个跨层关系:如果 KV 压缩减少了缓存驱逐和重算,即使单次 attention 计算只略有改善,后期多轮请求的 TTFT 也可能明显下降。反过来,缓存本来就够用时,相同压缩格式的额外 dequant 反而可能成为开销。
9. 方法演进的主线与实验顺序
| 原有方法的不足 | 后续改进方向 | 代表方法 | 核心优化对象 |
|---|---|---|---|
| 一个范围覆盖不了主体与异常通道 | 混合精度分解、等价缩放 | LLM.int8、SmoothQuant | 计算路径、通道范围 |
| 权重最近舍入不等于输出最优 | 输入加权重建与二阶补偿 | GPTQ | 权重落点及剩余误差 |
| 等价参数化影响重要权重的精度 | activation 感知的 scale 搜索 | AWQ | 通道相对缩放 |
| 固定 rounding 与范围不够灵活 | 局部学习 rounding、clipping 与变换 | AdaRound、AutoRound、OmniQuant | 压缩参数 |
| 异常值集中在少数坐标 | 正交混合、学习旋转、格式相关微旋转 | QuaRot、SpinQuant、MR-GPTQ | 坐标系与格式匹配 |
| 极低位宽的独立标量格点不足 | 联合编码一组权重 | QuIP#、AQLM | 码字选择、码本与块重建 |
| 局部 PTQ 无法弥补模型级行为差异 | 在目标离散前向下训练 | STE/PACT/LSQ、LLM-QAT | 权重、阈值/scale 与任务目标 |
| 后压缩模型不易适应二值/三值 | 从学习阶段引入离散权重 | BitNet 系列 | 量化感知的预训练 |
这些是问题与解法之间的关系,不是一张“越晚发表越好”的排名。GPTQ 与 AWQ 优化不同对象,旋转与码本可能增加运行开销,QAT 也需要明确目标格式和训练预算。
先锁定模型、tokenizer、chat template 和原始 checkpoint;按训练/校准、recipe 选择、最终验收分别留出数据。建立 BF16 的质量、显存和延迟基线之后,再分离权重、activation、KV 三条轴。
如果参数显存是主要限制,先比较 RTN/GPTQ/AWQ 的 W4A16;如果 GEMM 吞吐是主要限制,比较有实际内核支持的 W8A8/FP8;如果是 KV 容量限制,单独测试低比特 KV。Blackwell 上再把 NVFP4/MXFP4 作为完整候选,不把架构支持直接当成性能结论。
当 PTQ 无法达到质量约束时,先定位少数敏感层、scale 或校准覆盖问题,再考虑更昂贵的重建、旋转搜索或 QAT。QAT 的目标应是弥补已明确的量化缺口,而不是在部署格式尚未确定时训练一个无法导出的学生模型。
最终至少报告以下指标,并写明统计口径:
- 质量:独立集 NLL/PPL、任务 accuracy 或 pass@k、logit KL、长上下文检索与多轮成功率。
- 局部数值:分层 NMSE/SQNR、尾部误差、饱和率、zero-collapse、scale 分布、GPTQ fallback。
- 存储:checkpoint 大小、权重载荷、scale/zero-point、KV 数据与 metadata、峰值 workspace。
- 性能:固定 batch 和输入/输出长度下的 TTFT/TPOT、P50/P95/P99、吞吐及 profiler 中 quant/rotate/GEMM 占比。
把“浮点等价变换通过”“目标量化器误差可接受”“packed checkpoint 对拍通过”“部署任务达标”“真实性能有收益”作为连续的验收关口,才能知道一个方案究竟在哪一层有效。
回到格式这个起点:8 bit 的范围问题推动了异常值分解与缩放;4 bit 的粗格点推动了重建、补偿、旋转和联合训练;低于 4 bit 又推动了向量/加性码本与二值、三值模型训练。PTQ 主要改进如何压缩已有模型,QAT 进一步改变模型如何适应目标量化器。选择方法时,需要把元素格式、scale、核心优化、数值稳定性和实际 kernel 放在同一个实验里检验。
附录:保留旧稿的性能观察与外部评测
A. H20 GEMM 的历史记录
旧稿保存了下面这组 H20/Hopper、、AI 辅助实现的 GEMM 数据。这里保留作者当时的观察,但原记录缺少完整代码版本、编译配置、预热和计时口径,因此不能当作本文新测的可复现基准,也不能据此给不同框架作普遍排名。
| 方案 | 实现 | 时间 | 吞吐 |
|---|---|---|---|
| W8A8 INT8xINT8 | CUTLASS | 0.100 ms | 171.7 TFLOPS |
| W4A16 BF16xINT4 | CUTLASS | 0.162 ms | 105.7 TFLOPS |
| W4A16 BF16xINT4 | Triton | 0.170 ms | 101.2 TFLOPS |
| W4A8 INT8xINT4 | CUTLASS full path | 0.111 ms | 154.4 TFLOPS |
| W4A8 INT8 fused | Triton | 0.101 ms | 169.8 TFLOPS |
| W4A8 BF16 fused | Triton | 0.179 ms | 96.1 TFLOPS |
表中的吞吐沿用旧稿命名,按有效工作量 理解;INT8 路径的计数不应误认为硬件执行了同等数量的浮点指令。几条融合路径是否包含 activation quant、weight unpack、scale 处理,也会直接影响比较。
我保留这组记录,是因为它提醒了一个具体问题:W4 比 W8 更小,并不保证这个 shape 下更快。若解包、类型转换和缩放成本超过节省的访存成本,端到端时间就可能增加。需要将这个判断带回真实 kernel 和 workload 验证。MARLIN 的内核设计 与 量化精度—性能评测 可作为进一步阅读。
B. SGLang 官方 KV accuracy 表
以下数值来自 SGLang Quantized KV Cache 文档,保留旧稿摘录并在本次核对。KV16/KV8/KV4 是该表的配置标签,具体模型、框架版本、格式与评测设置以原报告为准;这些不是本文本机实测。
| 模型 | 数据集 | KV16 | KV8 | KV4 |
|---|---|---|---|---|
| Qwen3-235B-A22B | gsm8k | 0.9168 | 0.9181 | 0.9186 |
| Qwen3-235B-A22B | aime25 | 0.7733 | 0.7333 | 0.6000 |
| Qwen3-235B-A22B | gpqa_diamond | 0.7010 | 0.6899 | 0.6778 |
| DeepSeek-R1-0528 | gsm8k | 0.9157 | 0.9154 | 0.9124 |
| DeepSeek-R1-0528 | aime25 | 0.5067 | 0.4934 | 0.4000 |
| DeepSeek-R1-0528 | gpqa_diamond | 0.7707 | 0.7697 | 0.7273 |
| GPT-OSS-120B | gsm8k | 0.9161 | 0.9163 | 0.9152 |
| GPT-OSS-120B | aime25 | 0.7533 | 0.7667 | 0.3533 |
| GPT-OSS-120B | gpqa_diamond | 0.5081 | 0.5434 | 0.3202 |
这个结果支持的判断是:单看 GSM8K 近似持平,无法保证 AIME 或 GPQA 也保持质量。它并不能单独证明退化一定来自某一量化轴或某个 outlier;定位原因仍需前文的分层误差与消融。
对于每 16 个 FP4 元素一个 8 bit scale 的数据区, 倍 BF16 容量、 倍 FP8 容量是忽略其他开销的理论关系;服务实际可容纳 token 数还取决于 page 对齐、其他 metadata 和固定显存开销。
参考资料
正文在对应机制旁链接了论文、固定源码和官方 recipe。下面保留原综述的生态资料入口,便于继续追踪实现;未固定版本的文档应按实际部署版本重新核对。
- vLLM Quantized KV Cache
- vLLM Triton Attention API
- vLLM LLM Compressor
- SGLang Quantization
- SGLang Quantized KV Cache
- GPTQ
- AWQ
- SmoothQuant
- LLM.int8()
- FP8 Formats for Deep Learning
- MARLIN
- Give Me BF16 or Give Me Death: Accuracy-Performance Trade-Offs in LLM Quantization
- KIVI
- KVQuant
- TurboQuant
- UltraQuant