刘芷溢
最近更新
FlashAttention v1-v4:从 IO 感知到异步流水与硬件协同
沿着 FlashAttention v1-v4 的论文、作者博客与源码,拆解 Ampere、Hopper、Blackwell 如何改变 attention 的数据路径、线程分工和瓶颈,并用调度图解释 copy、MMA、softmax 与输出校正如何真正重叠。
理解 H100:从硬件数据路径到 Nsight Compute 瓶颈分析
沿着 kernel 的分配、指令发射、访存与异步矩阵计算,建立 H100 的硬件工作模型,并把 Nsight Compute 的吞吐、调度、事务和依赖指标组织成可验证的瓶颈诊断方法。
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization 论文笔记
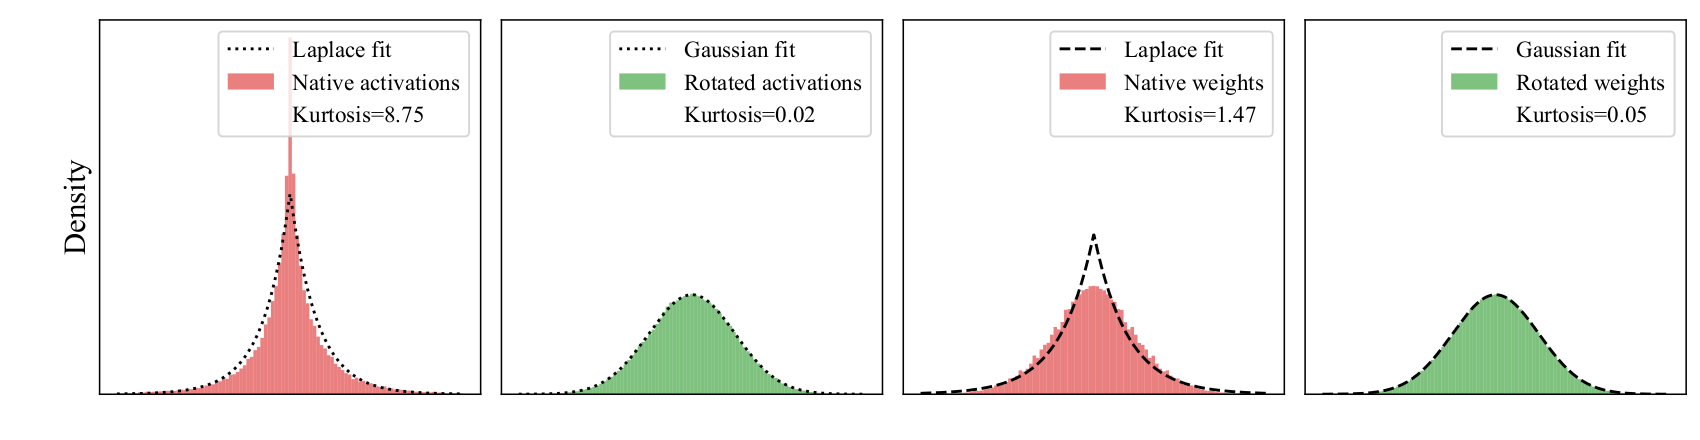
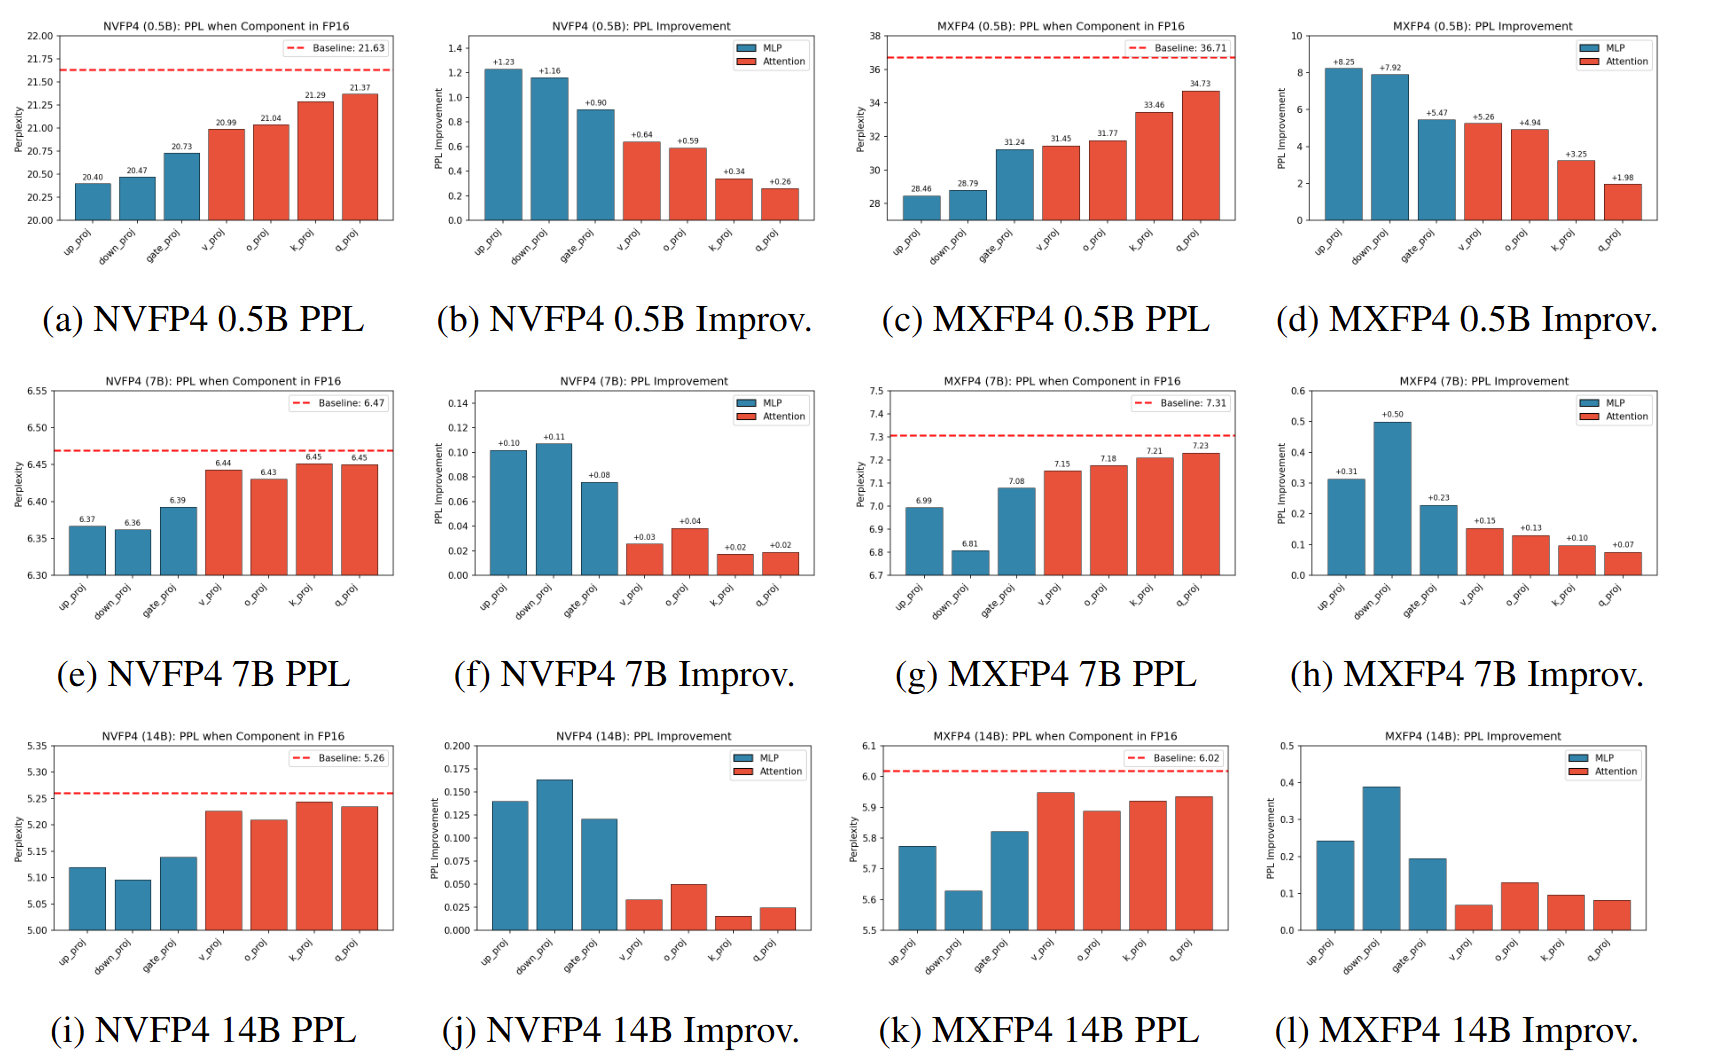
以格式、量化算法和 GPU Kernel 的跨层约束为主线,拆解 ICLR 2026 论文 Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization,解释旋转为何改善 MXFP4 却可能伤害 NVFP4、MR-GPTQ 如何修正这一矛盾,以及 QuTLASS 的真实收益与部署边界。
FP4、FP8 与 INT8/INT4:数值范围、块缩放与推理计算精度
从标量编码、共享 scale 与有效位宽出发,拆解 INT8、FP8、MXFP8、INT4、MXFP4、NVFP4 的表示范围,并沿 GEMM、GQA/MLA Attention 数据流解释 8 bit/4 bit 推理真正使用的乘法、累加、Softmax 与输出精度。
从 EAGLE 到 DFlash 2:SGLang 与 SpecForge 的投机解码训练和推理
沿 EAGLE、EAGLE-2、EAGLE-3、DFlash、DSpark 和 DFlash 2 的演进,解释 draft 的训练目标、数据对齐、推理状态与验证预算,并对照 SpecForge 训练和 SGLang serving 源码串起完整流程。
README
CuTe FlashAttention-2 case-study benchmark This directory preserves the exact teaching kernel, benchmark harness, raw results, and figure generator used by the corresponding tom-jerr blog post.
CuTe 详解:以 FlashAttention-2 拆解 Layout、TiledCopy 与 TiledMMA
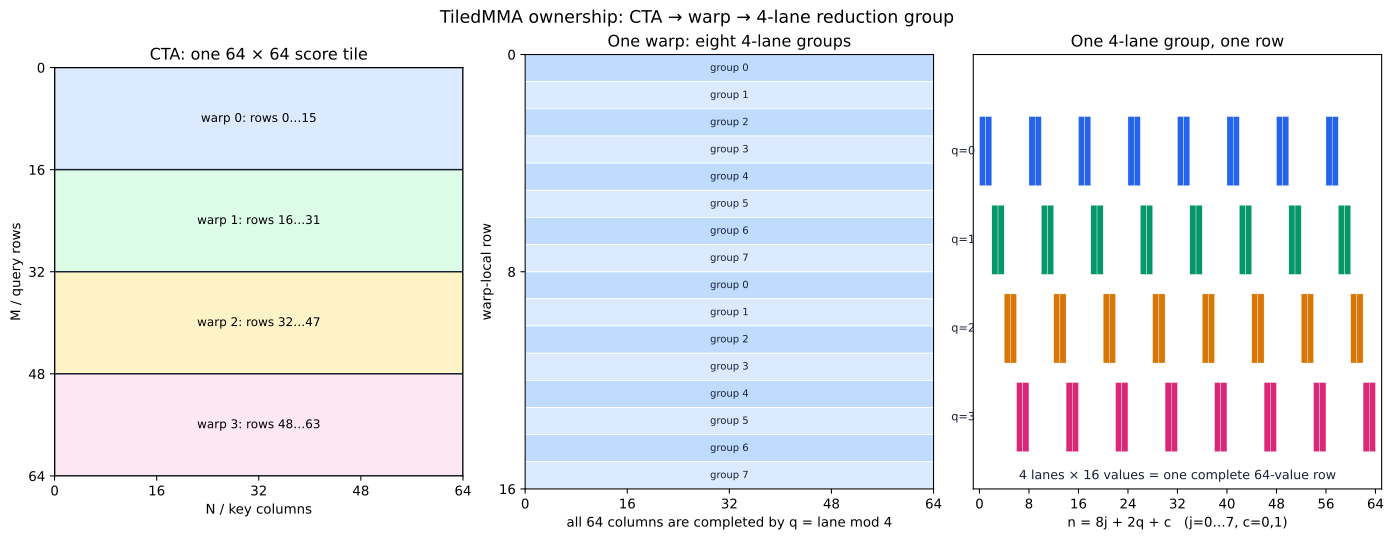
以一份可运行的 FlashAttention-2 前向 Kernel 为贯穿案例,从坐标函数和线程所有权出发,详解 CuTe 的 Layout algebra、Tensor、TiledCopy、TiledMMA、寄存器重解释与流水线,并用正确性和性能实验检查这些抽象最终生成了什么。
LLM 量化综述:数据格式、PTQ 与 QAT 的算法演进
从 INT8、FP8、INT4、MXFP4、NVFP4 的表示范围与舍入误差出发,按 8 bit、4 bit 和低于 4 bit 梳理 PTQ/QAT,解释各方法解决的问题、相对前作的创新、核心优化与数值稳定性,并对应到 llm-compressor 的工程实现。

tiny-llm
3 篇文章
Batching Inference & KV Cache
Batching Inference & KV Cache KV Cache Question without KV Cache Attention 计算实际上是与 seq_len 平方成正比的,所以 prompt 变长的话,我们的 FLOPs 会很快增长到超过 Single GPU 的计算能力(Compute-Bound) “Aha!”时刻: 当我们去预测第 9 个词时,我们需要: Q = 第 8 个 token 的 Query 向量。 K = ["The", ..., "and", "the"](所有 8 个 token)...
Group Query Attention
GQA: Group Query Attention Group Query Attention 这是一种针对多头注意力机制的优化技术,可以降低与键 (K) 和值 (V) 投影相关的计算和内存成本。与多头注意力机制 (MHA) 中每个查询 (Q) 头都有自己的 K 头和 V 头不同,多个 Q 头共享相同的 K 头和 V 头。多查询注意力机制 (MQA) 是 GQA 的一个特例,其中所有 Q 头共享一个 K/V 头对。 实际上在应用时,我们还会再计算 q @ k 后进行 mask 叠加,这里一般有两种情况: 一种就是我们自己设计的 mask 形式 一种就是 causal mask(因果掩码),用...
RMSNorm & MLP
RMSNorm & MLP RMSNorm RMSNorm1 的定义: y = \frac{x}{\sqrt{mean(x^2) + \epsilon}} \cdot weight x 是输入张量。 weight 是一个可学习的缩放参数。 epsilon(eps) 是为了数值稳定性而添加的一个小常数(例如,1e-5 或 1e-6)。 mean(x^2) 是平方和然后除以元素的数量 LayerNorm 成功的关键在于其 “重新缩放” (re-scaling) 的不变性,而 “重新中心化” (re-centering,即减去均值) 这一步可能不是必需的 归一化方法 方法归一化维度是否依赖批...
